이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
이 사업의 성패는 순위표보다 공공 조달과 기업 도입에서 정해진다
GPU를 지원해 모델이 나오는 단계까지는 정책이 만들 수 있지만, 그 모델을 실제 업무에 쓰게 만드는 것은 구매와 검증 제도입니다.
아파치 2.0이라 저작권과 라이선스 고지만 지키면 가중치를 고쳐 재배포하거나 상업 서비스에 쓸 수 있습니다. 1차 모델 약관은 제3자에게 상업적으로 제공할 때 LG와 별도 계약을 요구했습니다.
모델 카드는 BF16 원본을 H200 8장짜리 서버 두 대, 모두 16장에 올리는 예시를 듭니다. FP8과 NVFP4 버전도 함께 공개됐고, 보고서의 속도 측정은 FP8 버전을 H200 8장에서 돌린 값입니다.
기술 보고서 표 24개 지표 가운데 Qwen3.5, GLM-5.1, 딥시크 V4 프로를 모두 앞선 것은 OpenAI-MRCR, KGC-Safety, ROK-Fortress 3개입니다. 한국어 지식 평가 KMMLU-Pro에서는 세 모델보다 6.7~11.4점 낮았습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
업스테이지가 7월 22일 독파모 2차 모델 Solar Open 2를 오픈웨이트로 공개했습니다. 하이브리드 어텐션으로 100만 토큰을 받고, 노타AI의 양자화판은 117.8GB로 줄어 H100 두 장에 올라갑니다. 기록을 밖으로 보낼 수 없는 조직을 겨냥했습니다.

미스트랄이 10월 6일 1조 파라미터 Mistral Large 4 프리뷰를 공개했습니다. 아티피셜애널리시스 지수 38점으로 중국 밖 오픈 모델 1위이고, 사이버 방어를 앞세워 가중치는 레드팀 시험 뒤 10월 말 풉니다.
알레프 알파가 10월 3일 781억 파라미터 전문가 혼합 모델 Kolibri를 아파치 2.0으로 공개했습니다. H200 한 장에 올라가고 독일어·영어에 맞췄으며, 미세조정 데이터는 주로 GLM-5.2·5.3과 Qwen3.8-27B로 만들었습니다.
업스테이지가 7월 22일 독파모 2차 모델 Solar Open 2를 오픈웨이트로 공개했습니다. 하이브리드 어텐션으로 100만 토큰을 받고, 노타AI의 양자화판은 117.8GB로 줄어 H100 두 장에 올라갑니다. 기록을 밖으로 보낼 수 없는 조직을 겨냥했습니다.
미스트랄이 10월 6일 1조 파라미터 Mistral Large 4 프리뷰를 공개했습니다. 아티피셜애널리시스 지수 38점으로 중국 밖 오픈 모델 1위이고, 사이버 방어를 앞세워 가중치는 레드팀 시험 뒤 10월 말 풉니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@LG_AI_ResearchX 게시물 · 원문 보기
LG AI연구원이 공식 X 계정에 올린 공지는 네 가지 숫자로 요약됩니다. 모델 크기는 1차 모델의 3배, 벤치마크 종합 성능은 10.8% 향상, 지원 언어는 10개, 라이선스는 상업적 이용과 수정이 가능한 아파치 2.0입니다. 같은 날 낸 보도자료에서는 9개 영역 24개 지표 평균이 1차 모델의 63.3점에서 70.1점으로 올랐고, 코딩과 에이전틱 코딩 주요 지표 3개는 평균 30% 올랐다고 밝혔습니다.
임우형 공동 연구원장은 파라미터 수보다 개발 과정에 의미를 뒀습니다. 설계에서 추론 환경까지 750B급 모델을 만드는 모든 단계를 국내 연구진이 직접 해냈다는 설명입니다.
국내 연구진이 750B급 모델의 설계부터 데이터 학습, 분산 학습, 추론 환경 구축까지 전 과정을 독자적으로 완수했습니다.— 임우형, LG AI연구원 공동 연구원장
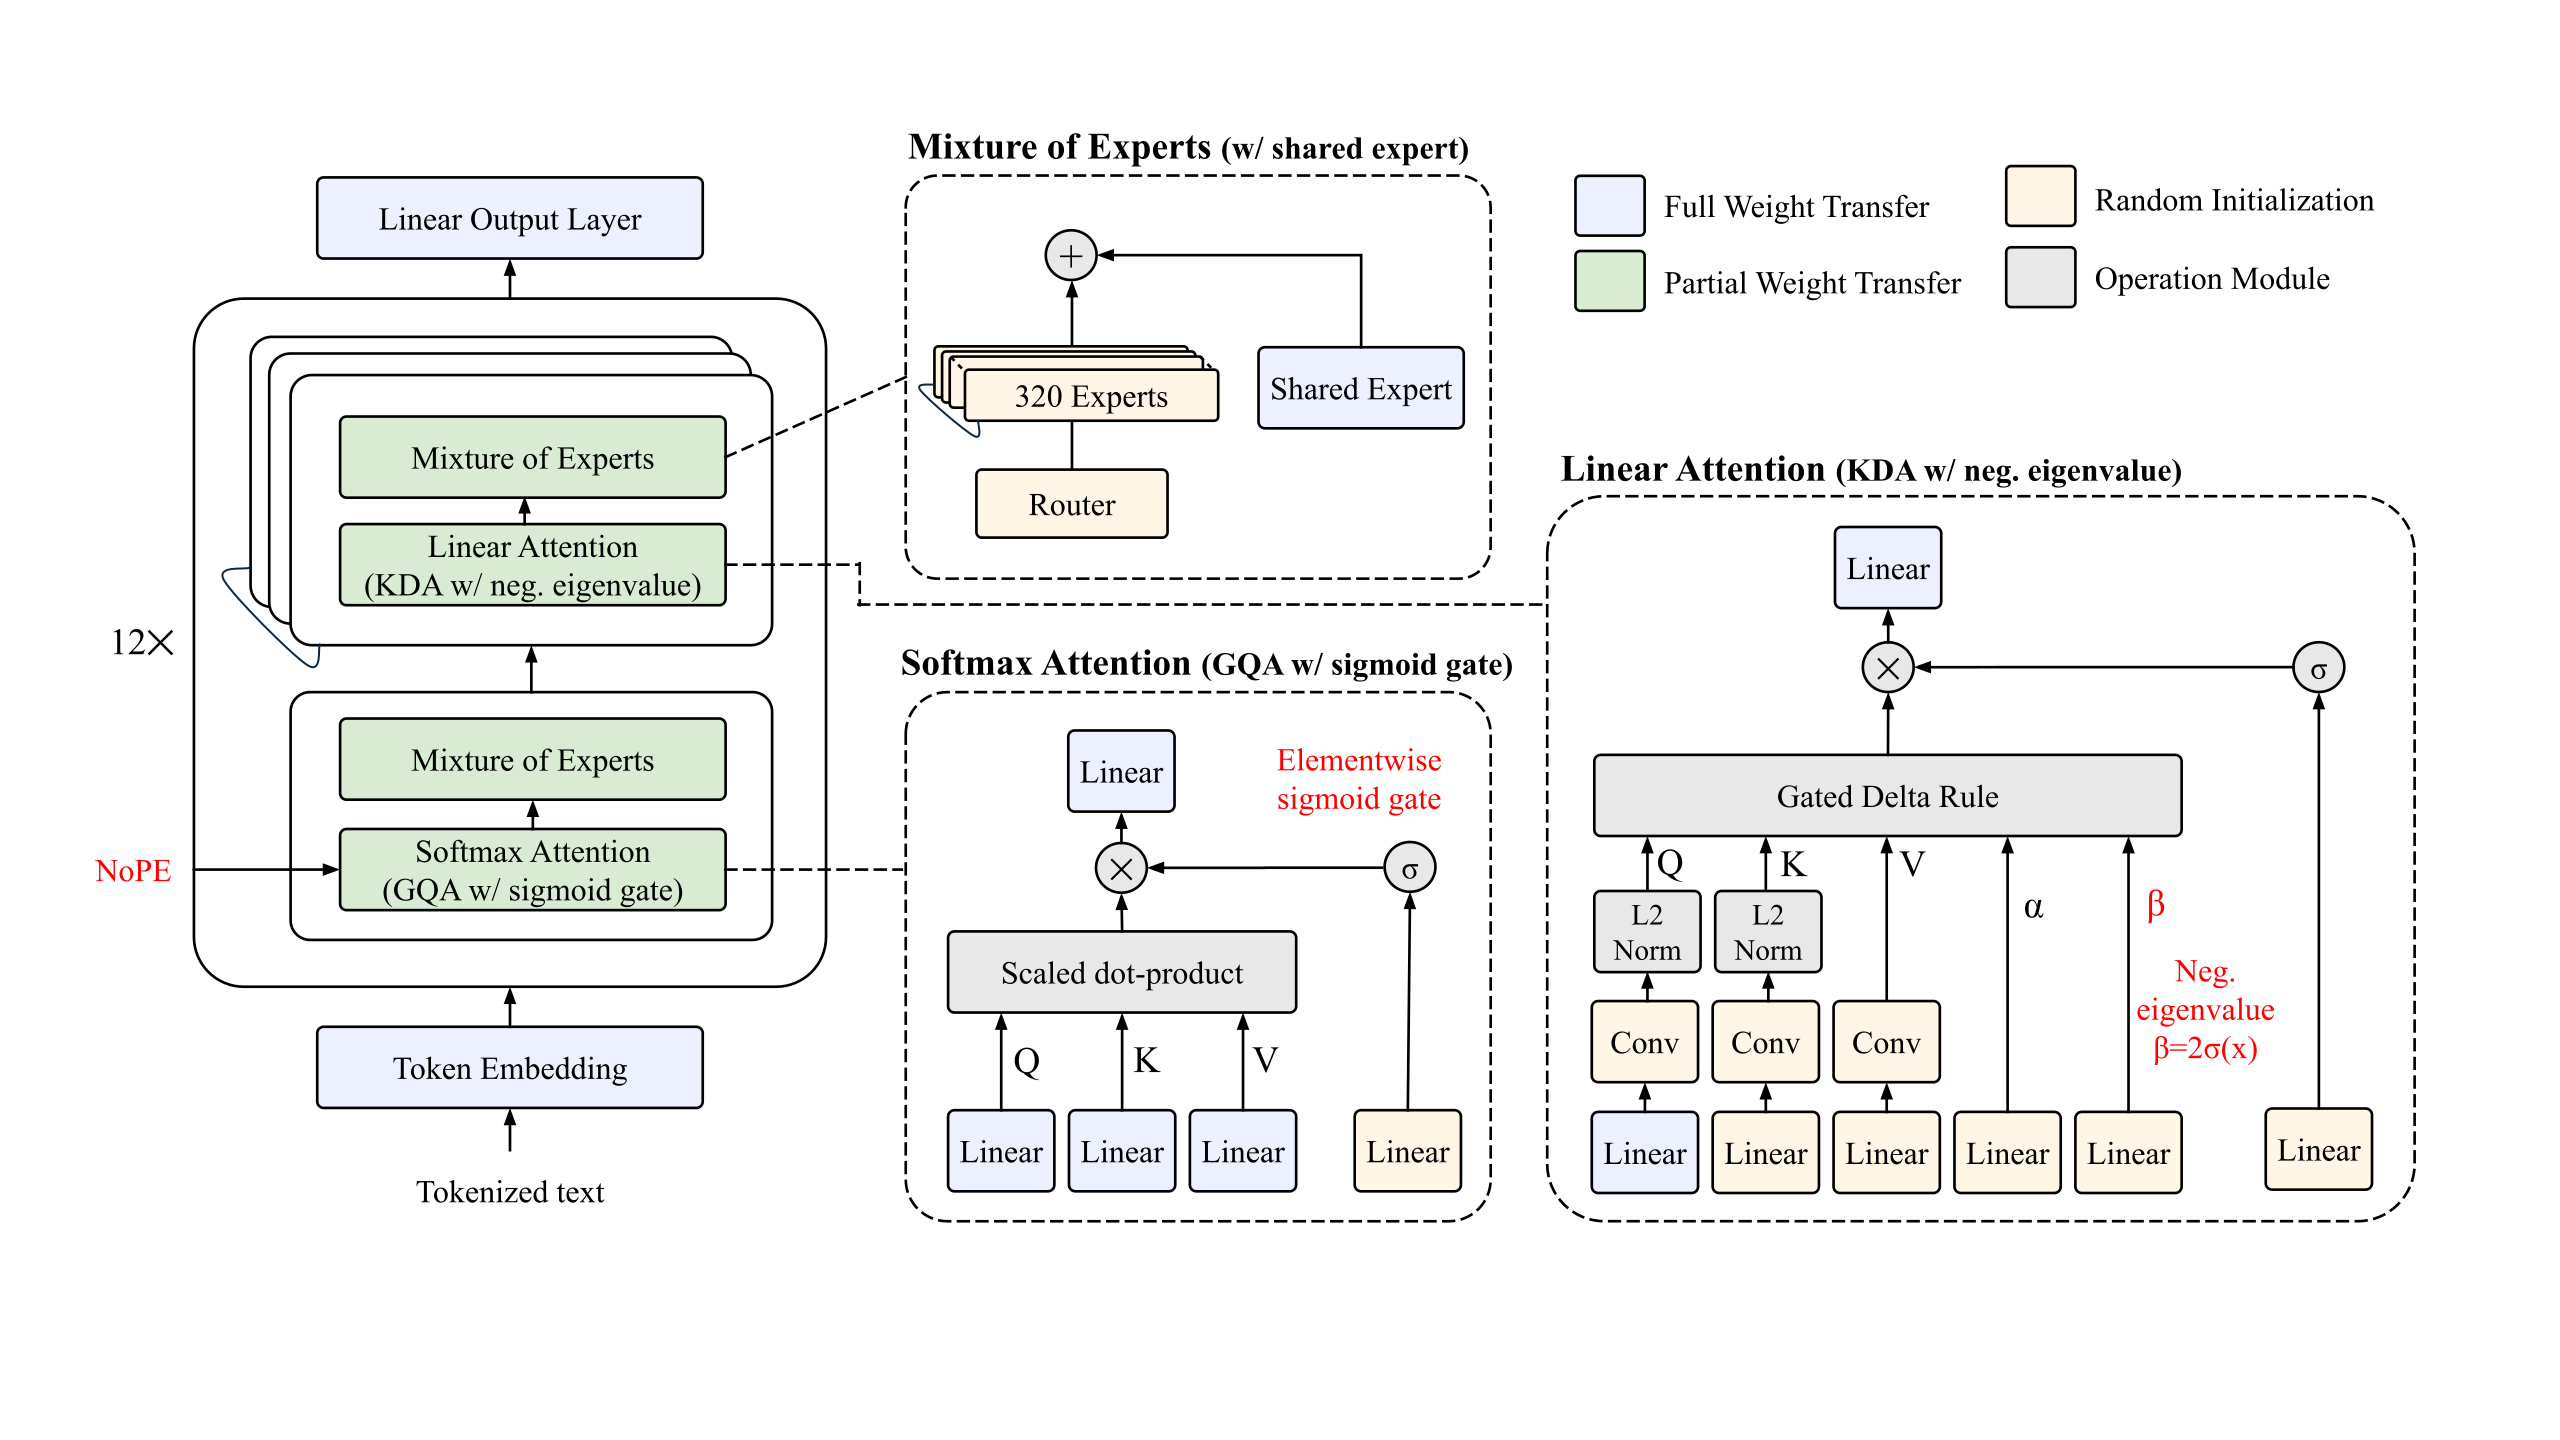
K-엑사원은 전문가 혼합(MoE) 구조입니다. 작은 신경망 여러 개를 전문가로 두고, 글자 조각(토큰)이 들어올 때마다 그중 몇 개만 골라 계산하는 방식입니다. 전체 파라미터는 크게 두면서 한 번에 돌리는 계산량은 작게 묶을 수 있어서, 이번에 비교 대상이 된 Qwen3.5와 GLM-5.1, 딥시크 V4 프로도 모두 이 구조를 씁니다.
2.0은 처음부터 새로 학습한 모델이 아닙니다. LG는 기술 보고서에 더 큰 모델을 처음부터 학습하면 1차 모델의 파라미터와 함께 거기에 들인 연산과 데이터, 학습 경험까지 버리게 된다고 적었습니다. 그래서 1차 모델의 가중치를 이어받아 깊이와 너비를 함께 늘리는 업사이클링을 택했습니다.
| 구분 | K-엑사원 1차 | K-엑사원 2.0 |
|---|---|---|
| 전체 파라미터 | 236B | 750B |
| 토큰당 활성 파라미터 | 23B | 37B |
| 레이어 | 48개 | 78개 |
| 전문가(전체/공용/활성) | 128 / 1 / 8 | 256 / 1 / 8 |
| 어휘 수 | 153,600 | 153,600 (그대로) |
| 최대 문맥 | 256K | 256K |
| 라이선스 | K-EXAONE 자체 약관 | 아파치 2.0 |
깊이는 레이어 네 개짜리 묶음(짧은 범위만 보는 어텐션 셋과 전체를 보는 어텐션 하나)을 12개에서 19개로 늘려 키웠고, 너비는 전문가를 하나씩 복제해 128개를 256개로 만들었습니다. 복제한 전문가는 처음에 똑같은 값을 받아 똑같이 학습되기 때문에, 작은 회전 잡음을 넣어 서로 다른 방향으로 갈라지게 했습니다. 토크나이저와 전문가를 고르는 방식은 1차 모델 그대로입니다.
키운 뒤에는 1차 모델 후반부 데이터로 몸을 푸는 단계를 거쳐 8조 토큰을 더 학습했습니다. 이어 문맥 64K에서 4,000억 토큰, 그보다 긴 문맥에서 4,000억 토큰을 학습하는 중간 훈련을 했고, 지도 학습에는 3,500억 토큰을 썼습니다. 1차 모델은 사전학습에 11조 토큰과 1.52×10²⁴ FLOPs의 연산을 썼습니다.
규모를 키우는 과정에서 생긴 문제도 보고서에 적혀 있습니다. 학습이 진행될수록 깊은 레이어의 일부 전문가 출력값이 다른 전문가보다 훨씬 커졌고, 이를 누르지 않고 재면 마지막 레이어에서 6,862까지 치솟았습니다. 이런 값은 FP8 같은 낮은 정밀도로 학습하거나 서비스할 때 계산을 망가뜨립니다. LG는 마지막 16개 레이어에서 두 갈래 값을 7.0에서 잘라 최대치를 48.96에 묶었고, 같은 방식을 오픈AI의 gpt-oss와 딥시크 V4도 쓴다고 밝혔습니다.
가중치를 이어받은 방식은 이 사업의 독자성 기준과도 닿아 있습니다. 과기정통부는 1월 1차 평가에서 남의 오픈소스를 쓰더라도 가중치를 초기화한 뒤 학습하는 것을 독자 모델의 최소 조건으로 제시했고, 네이버클라우드는 이 기준을 충족하지 못했다는 판단을 받아 2차에 오르지 못했습니다. 2.0이 이어받은 가중치는 LG가 그 평가를 통과한 자기 1차 모델의 것입니다.
장문과 도구 사용 비교에서 보도자료가 앞세운 상대는 중국 지푸의 GLM-5.1과 알리바바의 Qwen3.5입니다. 장문 이해 평가 OpenAI-MRCR에서 94.4점으로 GLM-5.1의 71.5점을, 한국어 장문 평가 Ko-LongBench에서 89.6점으로 GLM-5.1의 83.6점을 앞섰고, 에이전트 도구 사용 평가 τ³-Banking에서는 14.2점으로 GLM-5.1(11.5점)과 Qwen3.5(13.4점)를 앞섰다고 적었습니다. 모델 카드 첫머리에 올린 막대 그림도 이 두 모델과만 견줍니다.

같은 날 올린 기술 보고서의 표에는 비교 모델이 하나 더 있습니다. 딥시크 V4 프로(최대 추론)이고, 보도자료에서는 지시 이행과 안전성 비교에만 이름이 나옵니다. 이 모델까지 넣으면 τ³-Banking의 1위는 25.8점의 딥시크이고, Ko-LongBench에서는 딥시크(91.4점)와 Qwen3.5(91.3점)가 K-엑사원 2.0(89.6점)보다 높습니다. τ³-Banking 14.2점은 1차 모델과 같은 점수이기도 합니다.
| 평가 | K-엑사원 2.0 | K-엑사원 1차 | Qwen3.5 | GLM-5.1 | 딥시크 V4 프로 |
|---|---|---|---|---|---|
| OpenAI-MRCR (장문 검색) | 94.4 | 52.3 | 93.0 | 71.5 | 92.9 |
| Ko-LongBench (한국어 장문) | 89.6 | 86.8 | 91.3 | 83.6 | 91.4 |
| τ³-Banking (도구 사용) | 14.2 | 14.2 | 13.4 | 11.5 | 25.8 |
| SWE-Bench Verified (코딩) | 68.2 | 49.4 | 76.4 | 73.6 | 80.6 |
| Terminal-Bench 2.1 (터미널 작업) | 43.8 | 30.3 | 51.3 | 61.8 | 64.0 |
| KMMLU-Pro (한국어 전문 지식) | 69.1 | 67.3 | 77.4 | 75.8 | 80.5 |
| CLIcK (한국 문화·언어) | 84.2 | 83.9 | 88.9 | 88.7 | 91.6 |
| KGC-Safety (LG 자체 안전성) | 99.8 | 96.1 | 92.0 | 69.3 | 82.8 |
| ROK-Fortress (지정학 안전성) | 89.5 | 60.9 | 86.1 | 73.2 | 47.6 |
24개 지표를 모두 보면 K-엑사원 2.0이 비교한 세 모델보다 전부 높은 평가는 OpenAI-MRCR과 KGC-Safety, ROK-Fortress 셋입니다. 모델별로 세면 Qwen3.5보다 높은 평가가 5개, GLM-5.1보다 높은 평가가 6개, 딥시크 V4 프로보다 높은 평가가 3개입니다. 표의 점수를 그대로 더해 24로 나누면 딥시크 V4 프로 78.3점, Qwen3.5 76.6점, GLM-5.1 74.1점, K-엑사원 2.0 73.3점이 나옵니다. LG가 밝힌 평균 70.1점은 계산 방식이 공개되지 않아 이 값과 다릅니다.
보도자료는 장문과 에이전틱, 지시 이행 영역에서 글로벌 선도 모델보다 높거나 대등한 성능을 냈다고 적었습니다. 딥시크 V4 프로까지 넣은 보고서 표에서 이 세 영역 평가 7개 가운데 K-엑사원 2.0이 가장 높은 것은 OpenAI-MRCR 하나입니다. LG도 보고서 결론에 모든 벤치마크에서 앞서지는 않는다고 적고, 가장 분명한 강점으로 장문 검색과 안전성을 꼽았습니다.
한국어 영역만 떼어 보면 차이가 더 큽니다. 한국어 전문 지식을 묻는 KMMLU-Pro에서 K-엑사원 2.0은 69.1점으로, GLM-5.1(75.8점)과 Qwen3.5(77.4점), 딥시크 V4 프로(80.5점)보다 6.7~11.4점 낮았습니다. 한국 문화와 언어를 묻는 CLIcK에서도 84.2점으로 세 모델보다 4.5~7.4점 낮았고, 한국어 수학 HRM8K-KSM에서는 GLM-5.1보다 1.7점 높았지만 Qwen3.5보다 0.1점, 딥시크보다 3.2점 낮았습니다.
이 점수는 경쟁사가 스스로 낸 숫자도 아닙니다. 보고서는 비교 모델의 공식 점수가 없을 때 LG가 자기 환경에서 권장 설정으로 쟀다고 밝혔고, 한국어 세 평가의 비교 모델 점수에는 공식 발표치를 뜻하는 별표가 하나도 없습니다. 1월 보고서에서도 KMMLU-Pro는 Qwen3(71.6점)와 딥시크 V3.2(72.1점)가 K-엑사원(67.3점)보다 높았는데, 반년 뒤 두 회사의 새 모델과의 차이는 8.3점과 11.4점으로 커졌습니다.
보고서의 데이터 실험에 이유를 짐작할 단서가 있습니다. LG는 이번에 한국데이터산업진흥원과 한국지능정보사회진흥원, 국립국어원, 동북아역사재단 같은 공공기관 자료를 모아 학습에 넣었습니다. 기관 자료로 학습한 모델은 한국 문화·역사 평가에서 68.23점으로 공개 데이터 모델(67.19점)보다 높았지만, 지식·추론 평가에서는 46.47점으로 공개 데이터 모델(47.21점)보다 낮았습니다. LG는 일반 지식은 언어를 넘어 잘 옮겨 가고, 나라마다 다른 역사·문화 지식은 그 나라의 좋은 자료가 있어야 는다고 해석했습니다. 한국어 지식 시험에서 다국어 대형 모델이 앞선 결과도 같은 방향으로 설명됩니다.
보도자료의 「코딩 3개 지표 30% 상승」은 세 평가의 상승률을 평균한 값과 맞아떨어집니다. SWE-Bench Verified는 49.4점에서 68.2점으로 38.1%, Terminal-Bench 2.1은 30.3점에서 43.8점으로 44.6%, SciCode는 35.6점에서 37.4점으로 5.1% 올랐고, 셋의 평균이 29.2%입니다. 오른 폭 대부분은 실제 저장소를 고치고 터미널에서 여러 단계를 수행하는 두 평가에서 나왔습니다.
1차 모델이 가장 뒤처진 분야도 여기였습니다. 1월 기술 보고서에서 K-엑사원의 SWE-Bench Verified는 49.4점으로, 같은 표의 딥시크 V3.2(73.1점)와 gpt-oss-120b(62.4점)에 크게 못 미쳤습니다. LG는 이번 보고서에서 이전 모델의 개선 여지가 가장 컸던 분야로 추론과 에이전틱 코딩을 꼽았습니다.
다만 SWE-Bench Verified라는 시험 자체가 흔들리고 있습니다. 오픈AI는 2월 이 평가에 학습 데이터 유출과 잘못된 테스트가 섞여 있다며 더 쓰지 않겠다고 밝혔고, 7월에는 뒤이어 밀던 SWE-Bench Pro에서도 과제 약 30%가 깨진 문제라는 감사 결과를 내놓았습니다. K-엑사원 2.0의 68.2점은 오픈소스 에이전트 틀인 mini-SWE-agent로 과제당 최대 4시간을 주고 잰 값이라, 다른 회사의 점수와는 실행 조건부터 다릅니다.
반년 사이 가장 크게 오른 숫자는 OpenAI-MRCR입니다. 1차 모델의 52.3점이 94.4점이 됐습니다. 긴 대화 속에 비슷한 요청을 여러 개 섞어 두고 지정한 차례의 답을 정확히 되살려 내는지 보는 시험인데, 보고서에 따르면 LG는 이 평가가 지원하는 100만 토큰 구간 가운데 128K까지만 재서 평균을 냈습니다.
긴 문맥 속 문장 하나를 찾게 하는 니들 인 어 헤이스택 시험에서는 256K까지 모든 위치에서 만점을 받았다고 보고서에 적었습니다. 이런 검색형 시험의 만점을 실제 사용 능력으로 옮기기는 어렵습니다. 벡터 데이터베이스 회사 크로마가 지난해 7월 18개 모델에 19만 4,480번 질문을 던진 실험에서, 모델들은 이 시험에서 거의 만점을 받으면서도 입력이 길어질수록 성능이 고르지 않게 떨어졌습니다. 크로마는 이 시험이 글자를 그대로 맞춰 찾는 단순 검색이라 의미를 따져야 하는 작업을 대표하지 못한다고 지적했습니다.
한국어 모델의 비용은 토크나이저에서 갈립니다. 토크나이저는 문장을 모델이 처리하는 조각으로 자르는 장치인데, 한 조각에 담기는 글자가 적으면 같은 문서도 조각 수가 늘고 연산과 요금이 그만큼 붙습니다. 2.0은 1차 모델의 토크나이저를 그대로 물려받았고, 효율을 잰 숫자는 1차 기술 보고서에 있습니다.
LG는 1차 모델에서 어휘를 10만 개에서 15만 개(모델 카드 기준 153,600개)로 늘리고, 자주 붙어 나오는 단어 묶음을 한 조각으로 만드는 초단어 토큰을 넣었습니다. 초단어 토큰은 어휘의 약 20%이고 영어·한국어·기타 언어에 2 대 3 대 1로 나눴습니다. 그 결과 조각 하나가 담는 바이트가 이전 엑사원 4.0보다 이렇게 늘었습니다.
| 텍스트 | 조각당 바이트 증가 (엑사원 4.0 대비) |
|---|---|
| 영어 | 19.6% |
| 한국어 | 29.0% |
| 다국어 | 49.8% |
| STEM | 20.1% |
| 코드 | 26.7% |
한국어에서 조각당 바이트가 29% 늘면 같은 문서에 드는 조각 수는 1을 1.29로 나눈 0.775배, 약 22% 줄어듭니다. 토큰 단위로 매기는 요금도 그만큼 내려가고, 같은 문맥 한도에 넣을 수 있는 한국어 분량은 29% 늘어납니다. 계약서나 공공 문서처럼 긴 한국어 원문을 통째로 넣는 업무에서는 성능표보다 이 차이가 먼저 비용으로 나타납니다.
LG가 보도자료에서 따로 공을 들였다고 밝힌 영역은 안전성입니다. 1차 모델 때 만든 위험 분류 체계 K-AUT는 서구권 분류로는 한국 사회의 맥락을 담을 수 없다는 판단에서 출발했습니다. 2.0에서는 유네스코 아시아태평양국제이해교육원과 함께 세계시민교육을 가르치는 교사 46명으로 자문단을 꾸려, 4주 동안 직접 모델을 공격해 보고 기준을 고치는 과정을 거쳤습니다. 모집 공고에 400명 넘게 지원했고, 자문단의 76%인 35명이 교직 경력 10년 이상입니다.
| 영역 | 1차 | 2.0 | 새로 추가 |
|---|---|---|---|
| 보편적 인간 가치 | 55 | 69 | 14 |
| 사회 안전 | 75 | 89 | 14 |
| 한국적 민감성 | 60 | 87 | 27 |
| 미래 위험 | 36 | 51 | 15 |
| 합계 | 226 | 296 | 70 |
새로 늘어난 70개 가운데 27개가 한국적 민감성 영역입니다. 북핵 문제와 헌정 질서, 역사 왜곡, 재외동포 정체성 같은 항목이 들어갔고, 여러 차례 대화를 주고받으며 쌓이는 위험과 모델이 사용자 비위를 맞추는 아첨 같은 항목도 새로 생겼습니다. 이 기준으로 만든 KGC-Safety에서 K-엑사원 2.0은 99.8점을 받았습니다. 보고서는 사람 평가를 K-AUT를 설계한 AI 윤리 담당자들이 직접 했다고 적었습니다. 기준을 쓴 사람이 채점까지 맡아 기준과 판정의 차이를 줄였다는 설명이지만, 같은 팀이 만든 시험을 같은 팀이 채점한 점수이기도 합니다.
외부 연구진이 만든 ROK-Fortress에서도 89.5점으로 Qwen3.5(86.1점)와 GLM-5.1(73.2점), 딥시크 V4 프로(47.6점)를 앞섰습니다. 안보·공공 안전과 관련한 공격성 질문을 영어와 한국어, 미국 맥락과 한국 맥락으로 바꿔 가며 묻는 시험입니다. 보도자료의 안전성 평균 94.6점은 이 두 점수의 평균이고, 같은 계산으로 GLM-5.1은 71.3점, 딥시크 V4 프로는 65.2점, Qwen3.5는 89.0점입니다.
1차 모델의 K-EXAONE 약관도 상업적 이용 자체는 허용했습니다. 다만 모델이나 파생 모델을 제3자에게 상업적으로 배포하거나 제공하려면 LG와 따로 계약해야 했고, 파생 모델 이름은 K-EXAONE으로 시작해야 했습니다. 엑사원 4.0과 4.5는 비상업 약관이었습니다. 아파치 2.0에는 이런 조건이 없어서, 저작권과 라이선스 고지만 지키면 가중치를 고쳐 자기 이름으로 팔 수 있습니다.
같은 사업의 SK텔레콤은 이미 이 조건으로 모델을 풀어 왔습니다. 지난해 말 공개한 1차 모델 A.X K1부터 아파치 2.0이었고, 이틀 전 내놓은 688B 모델 A.X K2도 같은 라이선스입니다. 7월 22일 Solar Open 2를 공개한 업스테이지는 아파치 2.0을 바탕으로 하되, 파생 모델 이름을 Solar로 시작하고 「Built with Solar」를 표기하라는 조건을 붙인 자체 라이선스를 씁니다.
| 팀 | 모델 | 라이선스 | 붙은 조건 |
|---|---|---|---|
| LG AI연구원 | K-엑사원 1차 | K-EXAONE 약관 | 제3자 상업 제공은 별도 계약, 파생 모델 이름 K-EXAONE |
| LG AI연구원 | K-엑사원 2.0 | 아파치 2.0 | 저작권·라이선스 고지 |
| SK텔레콤 | A.X K1, A.X K2 | 아파치 2.0 | 저작권·라이선스 고지 |
| 업스테이지 | Solar Open 2 | Upstage Solar License | 파생 모델 이름 Solar, 「Built with Solar」 표기 |
평가 기준에도 공개가 들어 있습니다. 1월 1차 평가의 전문가 평가표는 10점짜리 「파급효과 및 기여계획」 항목에 AI 모델 공개를 통한 생태계 확장 실적과 계획을 넣었습니다. 과기정통부는 2월 모티프테크놀로지스를 추가 선정하면서, 기존 세 팀과 같이 모델을 상업용 오픈소스로 공개할 계획을 확인했다고 밝혔습니다. LG는 이번 약관 변경을 개방성을 높이는 조치로 설명했습니다.
라이선스가 풀렸다고 누구나 돌릴 수 있는 크기는 아닙니다. 모델 카드는 BF16 원본을 H200 8장짜리 서버 두 대, 모두 16장에 나눠 올리는 예시를 듭니다. 파라미터 7,494억 개를 2바이트씩 저장하면 가중치만 약 1.5TB입니다. LG는 원본과 함께 8비트(FP8)와 4비트(NVFP4) 버전도 올렸고, 보고서의 속도 측정은 FP8 버전을 H200 8장 서버 한 대에서 돌려 얻었습니다.
속도를 높이는 장치도 두 가지 붙였습니다. 다음 토큰 여러 개를 미리 추측해 두고 한꺼번에 검증하는 추측 디코딩 방식인데, 모델 카드는 두 방식 모두 생성 속도를 약 3~5배 높인다고 적었습니다. 그런데 보고서 표에서 H200 8장으로 잰 실제 속도 향상은 DSpark 방식이 1.81~2.57배, MTP 방식이 1.27~1.77배입니다. 3~5에 가까운 숫자는 속도보다 한 번 검증에 받아들여지는 토큰 수(DSpark 3.6~5.4개) 쪽입니다.
LG는 2차 심사 가운데 실제 사용성을 보는 대국민 평가 사이트 개발을 마무리하고 있고, 다음 주에 새 산업 특화 모델을 공개한다고 밝혔습니다. 4월에 낸 시각언어모델 엑사원 4.5는 행정안전부 AI 안전신문고에서 하루 3만 9,000건 넘는 안전 신고 분석을 맡게 됐고, 식약처 신약 심사 AI에도 탑재된다고 소개했습니다.
과기정통부는 7월 28일부터 8월 4일까지 일반 국민 평가단 200명을 모집하고, 8월 8일부터 11일까지 네 팀의 모델을 직접 써 보고 절대평가로 점수를 매기게 합니다. 이 점수가 2차 단계평가에 들어가고, 세부 평가 기준과 결과는 8월 중 한꺼번에 공개할 예정입니다. 1차 평가에서 LG는 벤치마크 33.6점, 전문가 31.6점, 사용자 25.0점으로 세 부문 모두 1위였습니다. 사용자 점수 25.0점은 1위 팀을 만점으로 놓고 나머지 팀을 환산한 방식에서 나온 값이고, 이번에는 국민 평가단이 처음 채점에 들어옵니다.
저는 이 사업의 성패가 순위표보다 공공 조달과 기업 도입에서 정해진다고 봐 왔습니다. 정부는 이 사업의 성능 목표를 최신 글로벌 모델 대비 95%로 잡았지만, GPU를 대 주면 모델은 나와도 그 모델을 실제 업무에 붙이는 일은 구매와 검증 제도가 정합니다. 아파치 2.0으로 푼 750B 가중치를 국내 기업 몇 곳이 내려받아 제품에 붙이는지가 그 첫 숫자가 됩니다.
읽어 주셔서 고맙습니다.
초이 드림