이 글 어땠어요?
메타는 모델마다 그 회사 에이전트 제품(Muse Code, Claude Code, Codex 등)을 붙여 쟀고, AA는 모든 모델에 Terminus 2라는 하네스 하나를 붙였습니다. 1.2는 메타 표 82.9%, AA 80.1%였고, 1.1은 메타가 범용 하네스 mini-swe-agent로 잰 76.2%, AA 77.9%였습니다.
입력과 출력을 제품 개선에 쓰는 데 동의하는 muse-spark-1.2-contributor를 고르면 100만 토큰당 입력 0.10달러, 캐시된 입력 0.002달러, 출력 0.20달러입니다. 동의하지 않는 기본 요금은 1.25달러, 0.15달러, 4.25달러로 1.1과 같습니다.
macOS와 리눅스 터미널에 설치 명령 한 줄로 깔고 Meta Model API 계정으로 씁니다. 메타는 1.2부터 이용 지역을 넓혔다고 밝혔습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
메타가 9월 23일 Connect 2026에서 모든 AI 안경에 개인 에이전트 Muse를 넣겠다고 발표했습니다. 1,299.99달러 VR 안경은 2027년 봄, 열쇠고리 기기 Muse Charm은 12월에 나오고, 한국에서는 같은 날 Meta Glasses 판매가 시작됐습니다.

마이크로소프트가 10월 7일(미국 시각) 윈도 행사에서 에이전트 격리 장치 MXC를 정식 출시하고 메타 Muse의 윈도 앱을 예고했습니다. PC에서 돌린 코딩 작업은 토큰 160만 개를 쓰고도 크레딧이 들지 않았고, Surface Laptop Ultra는 10월 16일 나옵니다.
메타가 10월 2일(미국 시각) Muse를 직접 만든 하드웨어에 잇는 Muse Gadgets를 공개했습니다. 집 안 와이파이에 꽂는 Home Link 5,000대를 미국 구독자에게 무료로 나눠 주고, 공개 당시 기기 스킬은 43개였습니다.
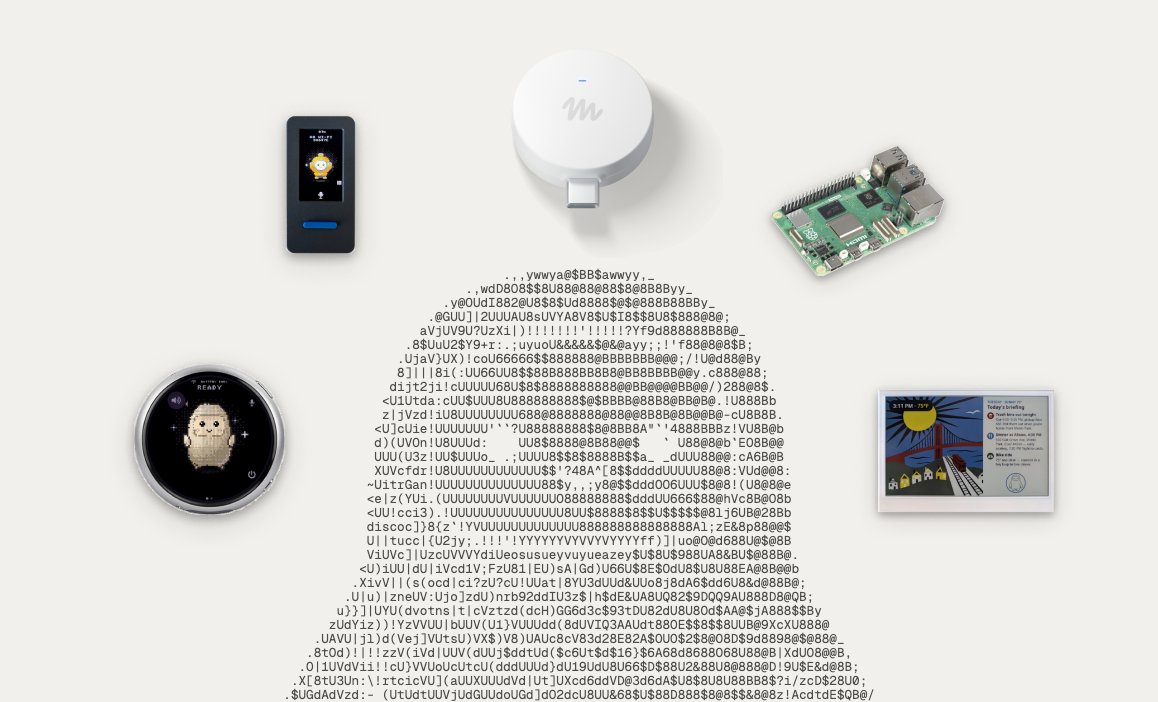
메타가 9월 23일 Connect 2026에서 모든 AI 안경에 개인 에이전트 Muse를 넣겠다고 발표했습니다. 1,299.99달러 VR 안경은 2027년 봄, 열쇠고리 기기 Muse Charm은 12월에 나오고, 한국에서는 같은 날 Meta Glasses 판매가 시작됐습니다.
마이크로소프트가 10월 7일(미국 시각) 윈도 행사에서 에이전트 격리 장치 MXC를 정식 출시하고 메타 Muse의 윈도 앱을 예고했습니다. PC에서 돌린 코딩 작업은 토큰 160만 개를 쓰고도 크레딧이 들지 않았고, Surface Laptop Ultra는 10월 16일 나옵니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@finkdX 게시물 · 원문 보기
마크 저커버그 CEO는 한국 시각 6일 새벽 4시 9분 X에 Muse Code 베타를 알리며 점수표 세 개를 한 장에 담아 붙였습니다. 터미널에서 명령을 이어 가며 과제를 푸는 Terminal-Bench 2.1, 실제 저장소의 코드를 고치는 DeepSWE 1.1, 메타 사내 코드로 만든 내부 코딩 평가입니다. 앞의 두 그래프에는 막대마다 모델 이름 아래 Claude Code, Codex, Grok Build 같은 이름이 작게 적혀 있는데, 그 모델을 돌린 하네스입니다.
하네스는 모델에 도구와 시스템 프롬프트, 작업 절차를 붙여 실제 과제를 하게 만드는 실행 틀입니다. 같은 모델이라도 어떤 틀에 넣느냐에 따라 도구를 부르는 방식과 문맥을 정리하는 방식이 달라지고, 점수도 달라집니다. 메타 표의 Terminal-Bench와 DeepSWE 막대 여섯 개는 모델과 하네스를 묶은 조합 여섯 개입니다.
Muse Code는 macOS와 리눅스 터미널에 명령어 한 줄로 설치하는 에이전트로, 큰 저장소를 맡아 변경 계획을 세우고 코드를 쓰고 결과가 통과하는지 확인합니다. 보조 에이전트들은 작업마다 새로 뜨지 않고 세션 내내 살아 있으면서 다음 할 일과 주 에이전트에 보고할 때를 스스로 정하고, 큰 작업은 서브에이전트를 격리된 워크트리(한 저장소에서 따로 꺼낸 작업 사본)로 나눠 보냅니다. 기본 명령은 작업을 승인용 계획으로 바꾸는 /plan, 그 계획의 허점을 찾는 /grill, 목표를 달성할 때까지 밀고 가는 /goal입니다.
모델 호출과 도구 실행, 승인, 편집은 전부 로컬 이벤트 로그에 차례로 쌓입니다. 메타는 이 로그 덕분에 실행 과정을 그대로 재현할 수 있고, 프로세스가 죽어도 멈춘 지점에서 이어 간다고 설명했습니다. 메타 슈퍼인텔리전스 랩(MSL)이 내놓은 첫 코딩 에이전트이고, 메타는 더 크고 훨씬 강한 모델이 오고 있다고 덧붙였습니다.
Muse Spark 1.2는 1.1을 코딩 쪽으로 다듬은 판입니다. 메타는 코딩 과제의 훈련 연산을 크게 늘렸고, 1.2를 Muse Code와 함께 훈련했다고 밝혔습니다. Muse Code에서 돌린 실행 기록 가운데 잘된 것을 골라 학습에 넣고, 목표 설정과 문맥 압축, 서브에이전트 운용 방식을 이 하네스에 맞춰 조정하고, Muse Code의 도구 세트를 훈련에 통합했습니다.
@alexandr_wangX 게시물 · 원문 보기
알렉산더 왕 최고 AI 책임자는 모델과 에이전트를 함께 훈련한 결과로 도구 호출의 첫 시도 성공률이 오르고, 계획 실행이 깔끔해지고, 다시 지시하는 시간이 줄었다고 적었습니다. 같은 글에서 이 모델을 엔비디아 호퍼 GPU의 커널 최적화에 붙여 24시간 동안 도구를 1,000번 넘게 부르게 한 사례도 소개했습니다.
하네스가 점수를 움직이는 이유는 모델이 틀의 습관을 배우기 때문입니다. 도구를 어떤 형식으로 부르는지, 문맥이 차면 언제 어떻게 줄이는지, 서브에이전트를 언제 띄우는지가 하네스마다 다릅니다. 문샷AI는 7월 Kimi K3 블로그의 한계 항목에, K3가 이전 사고 기록을 되돌려 받는 방식으로 훈련돼 하네스가 사고 기록을 전부 넘겨주지 않으면 생성 품질이 크게 흔들릴 수 있다고 적고 Kimi Code처럼 호환성이 검증된 하네스를 권했습니다. 자기 틀에 맞춰 훈련한 모델을 다른 틀로 옮길 때의 위험을 만든 회사가 직접 적은 사례입니다.
메타의 방향은 한 달 전과 다릅니다. 메타는 7월 Meta Model API와 함께 1.1을 낼 때 여러 하네스에 무리 없이 적응하도록 훈련했다고 썼고, 왕은 1.1이 OpenClaw와 HermesAgent 같은 다른 하네스에서 가장 잘 도는 모델 가운데 하나라고 자랑했습니다. 1.2 발표문에는 Muse Code와 짝을 이룰 때 최고 성능과 코딩 편의성이 나오도록 함께 훈련했다고 적었습니다.
메타는 점수표와 함께 3쪽짜리 평가 방법론 문서를 냈습니다. Terminal-Bench와 DeepSWE에서는 모델마다 그 회사가 고른 에이전트 제품을 붙였고, 추론 강도는 모델마다 가장 높은 설정을 썼다고 적었습니다. 세 그래프의 숫자를 모으면 다음과 같습니다.
| 모델 (추론 설정) | Terminal-Bench·DeepSWE 하네스 | Terminal-Bench 2.1 | DeepSWE 1.1 | 메타 내부 평가 |
|---|---|---|---|---|
| Claude Opus 5 (max) | Claude Code | 86.7% | 65.0% | 79.4% |
| Muse Spark 1.2 (xhigh) | Muse Code | 82.9% | 59.3% | 70.6% |
| GPT-5.6 Terra (max) | Codex | 81.8% | 64.8% | 65.4% |
| Grok 4.5 (high) | Grok Build | 81.6% | 56.6% | 표에 없음 |
| Gemini 3.6 Flash (high) | Antigravity CLI | 78.9% | 40.0% | 63.9% |
| Muse Spark 1.1 (xhigh) | mini-swe-agent | 76.2% | 53.0% | 68.3% |
Terminal-Bench 2.1은 과제 89개, DeepSWE 1.1은 저장소 91곳에서 뽑은 과제 113개(타입스크립트, 고, 파이썬, 자바스크립트, 러스트)이고, 메타는 과제마다 다섯 번 돌린 성공률의 평균을 적었습니다. DeepSWE를 도는 동안에는 인터넷을 막고 모델 API만 열어 뒀습니다. 내부 평가는 메타 사내 풀 리퀘스트에서 뽑은 과제 440개를 두 번씩 돌린 결과입니다.
1.2는 Terminal-Bench와 내부 평가에서 2위, DeepSWE에서는 GPT-5.6 Terra(64.8%)에 밀려 3위였습니다. 방법론 문서는 DeepSWE 공식 리더보드가 모든 모델에 mini-swe-agent라는 하네스 하나를 붙이는데, 메타 평가는 모델마다 다른 에이전트 제품을 써서 리더보드와 하네스 조건이 같지 않다고 적었습니다. 다른 회사 모델의 점수에는 이런 단서를 달았습니다.
우리 평가 환경의 도구와 시스템 프롬프트는 다른 회사의 독점 모델에 맞춰 조정하지 않았을 수 있습니다. 따라서 결과가 그 모델들의 최고 성능을 반영하지 못할 수 있습니다.— 메타, Muse Spark 1.2 평가 방법론 문서
표 안의 조건은 두 군데서 어긋납니다. 1.2는 자기 하네스와 함께 훈련받은 상태로 시험을 쳤고, 다른 회사 모델은 자사 에이전트 제품을 메타의 평가 환경 안에서 돌렸습니다. 직전 모델 1.1은 Muse Code가 아닌 범용 하네스 mini-swe-agent로 쟀습니다. 그래서 1.1에서 1.2로 오른 6.7점(Terminal-Bench)과 6.3점(DeepSWE)에는 모델이 좋아진 만큼과 하네스가 바뀐 만큼이 함께 들어 있습니다. 방법론 문서의 비교 모델 목록에는 Kimi K3와 Kimi Code 조합도 적혀 있지만, 공개된 그래프에 Kimi K3 막대는 없습니다.
두 효과를 나눠 볼 수 있는 숫자는 메타 밖에서 나왔습니다. AA는 Terminal-Bench 2.1을 모든 모델에 같은 하네스 Terminus 2를 붙여 샌드박스에서 돌리고, 과제마다 세 번 잰 평균을 냅니다. 저커버그 공지 2시간 23분 뒤 AA가 올린 분석에서 1.2는 80%, 1.1은 78%였습니다.
@ArtificialAnlysX 게시물 · 원문 보기
AA가 같은 날 올린 막대그래프에서 메타 표의 여섯 모델을 찾아 옮겼습니다. 하네스를 하나로 맞추자 순서가 달라집니다.
| 모델 | 메타 표 (각자의 하네스) | AA (Terminus 2 하나) |
|---|---|---|
| Claude Opus 5 | 86.7% | 89.1% |
| GPT-5.6 Terra | 81.8% | 88.0% |
| Grok 4.5 | 81.6% | 81.6% |
| Muse Spark 1.2 | 82.9% | 80.1% |
| Muse Spark 1.1 | 76.2% | 77.9% |
| Gemini 3.6 Flash | 78.9% | 77.5% |
메타 표에서 2위였던 1.2는 같은 틀에서 4위로 내려갑니다. GPT-5.6 Terra는 메타가 Codex로 잰 81.8%보다 AA에서 6.2점 높았고, 1.1은 메타가 mini-swe-agent로 잰 76.2%보다 AA에서 1.7점 높았습니다. 1.1과 1.2의 차이는 메타 표에서 6.7점, AA에서 2.2점입니다. 메타 자신의 내부 평가도 같은 방향입니다. 메타는 이 평가를 사내 하네스로 돌렸다고 적었고 그래프에도 모델별 하네스 이름이 없는데, 여기서 1.1과 1.2의 차이는 2.3점(68.3%에서 70.6%)이었습니다.
한 달 전 메타 자신이 적은 숫자도 있습니다. 메타는 7월 1.1을 발표하며 셸 명령 도구 하나만 쓰는 하네스로 잰 Terminal-Bench 2.1 점수를 80.0으로 적었습니다. 8월 표에서 같은 1.1은 mini-swe-agent로 잰 76.2%로 3.8점 낮게 적혔고, 7월 숫자를 기준으로 하면 1.2의 상승폭은 2.9점입니다. DeepSWE는 7월 53.3, 8월 53.0으로 거의 같았습니다.
하네스를 고정한 두 측정과 메타의 7월 숫자가 모두 2~3점대를 가리킵니다. 조건도 다 같지는 않습니다. 메타는 Daytona 샌드박스에서 다섯 번, AA는 e2b 샌드박스에서 세 번 쟀고, 이런 차이도 점수를 움직입니다. 그래도 1.1을 Muse Code로 잰 점수와 1.2를 범용 하네스로 잰 점수, 두 모델을 같은 틀에서 떼어 볼 수 있는 두 숫자는 메타 표에 없습니다.
모델과 하네스를 묶어 재는 방식이 잘못된 것은 아닙니다. 개발자가 실제로 쓰는 것도 Claude Code나 Codex처럼 모델과 하네스를 묶은 제품이고, AA도 조합 단위의 코딩 에이전트 지수를 따로 운영합니다. 7월 이 지수에서 1.1은 OpenCode 하네스로 69점을 받아 Codex에서 돈 GPT-5.5(71점)와 Claude Code에서 돈 Claude Opus 4.8(67점) 사이에 있었습니다. AA는 점수마다 어느 하네스였는지를 이름에 붙여 적습니다.
비교 상대를 고르는 방식은 회사마다 달랐습니다. 오픈AI 모델로는 최상위 GPT-5.6 Sol 대신 한 등급 아래 Terra가 들어갔고, AA 지능 지수로 Sol은 59점, Terra는 55점입니다. 3주 전 문샷AI는 Kimi K3 발표에서 자기 DeepSWE 점수를 Kimi Code 기준 67.5와 mini-SWE-agent 기준 67.3으로 둘 다 적었고, Terminal-Bench에서는 경쟁 모델마다 여러 하네스 가운데 가장 좋은 점수를 옮겼습니다.
Sol이 빠지지 않은 그래프도 하나 있습니다. 메타는 모델에게 도구 호출 1,000회 이상, 최대 24시간 동안 GPU 커널을 고치게 한 사례를 실었습니다. 대상은 문샷의 어텐션 구조 KDA와 딥시크가 처음 쓴 MLA의 커널이고, KDA의 기준 구현은 문샷이 공개해 온 KDA 커널이 속도를 견준 상대이기도 한 FLA의 Triton 구현입니다.

이 그래프에서 1.2는 기준 구현보다 68.7% 빠른 커널을 만들어 여섯 모델 가운데 4위였습니다. Opus 5가 74.0%, GPT-5.6 Sol이 71.2%, 한 세대 전인 Opus 4.8이 69.6%였고, 1.2는 Terra(65.1%)와 Gemini 3.6 Flash(62.5%)를 앞섰습니다.
AA 지능 지수로 1.2는 54점을 받아 1.1(51점)보다 3점, 4월 첫 모델보다 11점 올랐습니다. 1위 Claude Opus 5(61점) 아래로 Fable 5(60점), GPT-5.6 Sol(59점), Kimi K3(57점)가 있고, 미국 연구소 가운데서는 Grok 4.5를 낸 SpaceXAI와 공동 3위입니다. 상승분은 에이전트 평가에 몰렸습니다. 실제 직업 과제의 결과물을 맞대어 매기는 GDPval-AA v2에서 Elo가 1,371점에서 1,631점으로 260점 올랐고, Terminal-Bench와 은행 상담 과제 τ³-Banking이 2점씩 올랐습니다. 과학 코딩 SciCode는 2점, 고난도 문제 모음 HLE는 1점 내려갔습니다.
지식 평가 AA-Omniscience에서는 정답률이 41%에서 38%로 내려갔고, 모르는 문제에 틀린 답을 지어낸 비율(환각률)은 38%에서 28%로 줄었습니다. 정답을 더 맞혀서 줄어든 환각률은 아니고, 모르는 문제에서 틀린 답을 내는 대신 답을 보류한 경우가 늘었습니다. 금융과 코딩 과제로 만든 Vals 지수에서는 71.88%로 1.1보다 네 계단 오른 5위였는데, 과제 하나에 드는 비용은 0.50달러에서 0.69달러로, 걸린 시간은 389초에서 630초로 늘었습니다.
@alexandr_wangX 게시물 · 원문 보기
왕은 AA의 54점 분석을 인용하며 1.2를 괜찮은 반복 개선이라고 부르고, 더 크고 나은 것으로 넘어간다고 적었습니다. 메타 발표문도 1.2를 코딩에 초점을 둔 업데이트라고 소개했습니다.
1.2의 기본 요금은 1.1과 같습니다. 이번에는 입력과 출력을 제품 개선에 쓰는 데 동의하는 계정용 요금이 따로 붙었습니다.
| 100만 토큰당 | muse-spark-1.2 (제품 개선에 안 씀) | muse-spark-1.2-contributor (제품 개선에 씀) |
|---|---|---|
| 입력 | 1.25달러 | 0.10달러 |
| 캐시된 입력 | 0.15달러 | 0.002달러 |
| 출력 | 4.25달러 | 0.20달러 |
입력은 12.5분의 1, 캐시된 입력은 75분의 1, 출력은 약 21분의 1입니다. 발표문 본문에는 없던 표라, 메타 공식 발표 1시간 29분 뒤 한 개발자가 요금 페이지를 캡처해 올리며 학습에 쓰여도 괜찮다면 거의 공짜이고 오픈소스 기여자에게 좋다고 적었습니다.
코딩 에이전트의 입력에는 사내 저장소의 코드와 구조, 장애 기록이 그대로 들어갑니다. 코드를 이미 공개한 오픈소스 작업에는 할인 요금이, 비밀유지 조항에 묶인 사내 코드에는 기본 요금이 맞는 구조이고, 같은 모델을 쓰면서 데이터를 내주느냐에 따라 출력 단가가 21배 벌어집니다.
메타는 1.2부터 이용 지역을 넓혔다고 밝혔고, 왕은 Muse Code를 전 세계에서 쓸 수 있다고 적었습니다. 설치는 macOS와 리눅스 터미널에서 명령 한 줄이고, 요금은 Meta Model API 계정으로 나갑니다.
도입을 검토하는 회사가 이 표에서 옮겨 쓸 수 있는 숫자는 쓰려는 조합에 따라 다릅니다. 메타 표의 82.9%는 Muse Code와 함께 훈련한 1.2가 Muse Code 안에서 낸 점수라, 같은 모델을 다른 하네스나 사내 도구에 붙이면 그 숫자를 그대로 기대하기 어렵습니다. 반대로 Muse Code를 통째로 쓸 생각이라면 메타 표가 실제 사용 조건에 더 가깝습니다. 메타 스스로도 공개 벤치마크 둘과 별도로 사내 풀 리퀘스트 440개로 만든 평가를 표에 넣었습니다.
메타는 발표문에 더 크고 훨씬 강한 모델이 오고 있다고 적었고, 왕도 같은 날 더 큰 것으로 넘어간다고 했습니다. 다음 모델이 나오면 1.1을 Muse Code로 잰 점수처럼 이번 표에 없던 숫자가 나오는지 다시 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림


