이 글 어땠어요?
알리바바는 발표에서 다음 주 가중치를 공개하겠다고 밝혔고, 라이선스는 발표문에 없었습니다. 라이선스가 제약이 적은 형태인지 자체 조건이 붙는지에 따라 국내 기업이 고쳐 쓸 수 있는 범위가 달라집니다.
총 2.4조 파라미터라 가중치가 풀려도 개인이나 대부분의 기업이 직접 돌리기는 어렵습니다. 함께 예고된 27B가 사내 서버나 고성능 PC에서 돌릴 수 있는 크기입니다.
자체 표의 SWE-bench Pro는 Claude Code 하네스로 저장소 버그를 고치는 채점이고, 아레나는 사람이 두 결과물을 보고 더 나은 쪽을 고르는 방식입니다. SWE-bench Pro에서 Fable 5보다 12.3점 낮았던 모델이 아레나 프런트엔드 코드에서는 Fable 5보다 38점 높았습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
알리바바 Qwen 팀이 9월 20일 생성부 7B의 이미지 생성·편집 모델 Qwen-Image-2.1 가중치를 공개했습니다. 자체 채점표 29개 모델 가운데 7위로 Nano Banana 2.0보다 0.46점 높았고, 상업 이용에는 별도 라이선스가 필요합니다.

알리바바가 8월 14일 Qwen3.8-27B 가중치를 Apache 2.0으로 공개했습니다. 파라미터 수와 구조가 4월 Qwen3.6-27B와 똑같은데 DeepSWE는 13.3에서 42.2로 올랐고, 4비트 판은 24GB 그래픽카드에 들어갑니다.
샤오미 MiMo-V2.6-Pro가 AA 지능 지수 46점으로 오픈웨이트 1위에 올랐습니다. 같은 점수의 Grok 4.7이 과제당 3.74달러를 쓸 때 Pro는 0.13달러였고, 강화학습 6일에 든 262만 달러까지 공개됐습니다.
알리바바 Qwen 팀이 9월 20일 생성부 7B의 이미지 생성·편집 모델 Qwen-Image-2.1 가중치를 공개했습니다. 자체 채점표 29개 모델 가운데 7위로 Nano Banana 2.0보다 0.46점 높았고, 상업 이용에는 별도 라이선스가 필요합니다.

알리바바가 8월 14일 Qwen3.8-27B 가중치를 Apache 2.0으로 공개했습니다. 파라미터 수와 구조가 4월 Qwen3.6-27B와 똑같은데 DeepSWE는 13.3에서 42.2로 올랐고, 4비트 판은 24GB 그래픽카드에 들어갑니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
발표문은 Qwen3.8-Max를 지금까지 나온 Qwen 모델 가운데 가장 뛰어난 모델이라고 소개했습니다. Qwen3.5의 구조를 바탕으로 크기를 2.4조까지 키웠고, 어려운 질문에 답하는 데서 그치지 않고 코딩과 업무, 연구, 긴 작업을 끝까지 해내 믿고 쓸 만한 결과물을 내는 데 맞췄다는 설명입니다. 지금 쓸 수 있는 곳은 알리바바의 모델 서비스 QwenCloud의 API입니다.
QwenCloud 가격표를 보면 입력으로 텍스트와 이미지, 영상을 받고 출력은 텍스트입니다. 한 번에 넣을 수 있는 입력은 99만 1,000토큰, 출력은 13만 1,000토큰까지입니다. 7월 19일 나온 프리뷰는 구독 크레딧으로만 쓸 수 있었는데, 8월 3일부터 일반 API로 열렸습니다.
알리바바는 그동안 Max급 모델을 자사 서비스와 API로만 냈습니다. 4월 18일 나온 Qwen3.6-Max-Preview가 그랬고, 5월 20일 나온 Qwen3.7-Max는 발표문에서 스스로를 독점(proprietary) 모델이라고 불렀습니다. 가중치를 푸는 쪽은 늘 한 등급 아래 모델이었고, 4월 22일 Apache 2.0으로 나온 Qwen3.6-27B가 그 예입니다.
| 날짜 | 모델 | 공개 방식 |
|---|---|---|
| 4월 18일 | Qwen3.6-Max-Preview | 자사 서비스·API |
| 4월 22일 | Qwen3.6-27B | 가중치 공개(Apache 2.0) |
| 5월 20일 | Qwen3.7-Max | API(독점 모델) |
| 7월 19일 | Qwen3.8-Max 프리뷰 | 구독 크레딧 전용 |
| 8월 3일 | Qwen3.8-Max 정식판 | API, 가중치는 다음 주 |
가중치는 한 번 나가면 되돌릴 수 없습니다. 서버에서만 도는 모델은 회사가 값과 사용 조건을 언제든 바꿀 수 있지만, 파일로 나간 모델을 다스리는 수단은 라이선스 문구 정도만 남습니다. 발표문에는 가중치를 어떤 라이선스로 풀지가 적혀 있지 않았습니다. 저는 알리바바가 최상급 모델의 사용료를 지키는 것보다 업계가 기본으로 쓰는 모델이 되는 쪽을 택했다고 봅니다.
| 모델 | 입력(100만 토큰) | 출력(100만 토큰) |
|---|---|---|
| Qwen3.8-Max | 2달러 | 6달러 |
| Qwen3.7-Max (5월) | 2.5달러 | 7.5달러 |
| Kimi K3 | 3달러 | 15달러 |
| Claude Opus 5 | 5달러 | 25달러 |
직전 플래그십 Qwen3.7-Max의 가격은 입력 2.5달러, 출력 7.5달러였습니다. 모델은 커졌는데 입력과 출력이 모두 20% 내려갔고, 앞부분이 같은 요청에 붙는 캐시 입력값은 0.5달러에서 0.25달러로 절반이 됐습니다. 사용자가 직접 만든 캐시를 다시 읽을 때는 0.17달러입니다.
앤트로픽이 7월 24일 내놓은 Opus 5와 비교하면 출력값은 24%로 4분의 1에 못 미칩니다. 문샷AI의 Kimi K3와 견줘도 출력값이 5분의 2입니다. 발표 며칠 전인 7월 말에는 오픈AI가 GPT-5.6 계열 API 가격을 최대 80% 내렸는데, 이때 가장 비싼 Sol의 표준 가격은 그대로 두었습니다.
| 평가 | Qwen3.8-Max | Opus 4.8 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|
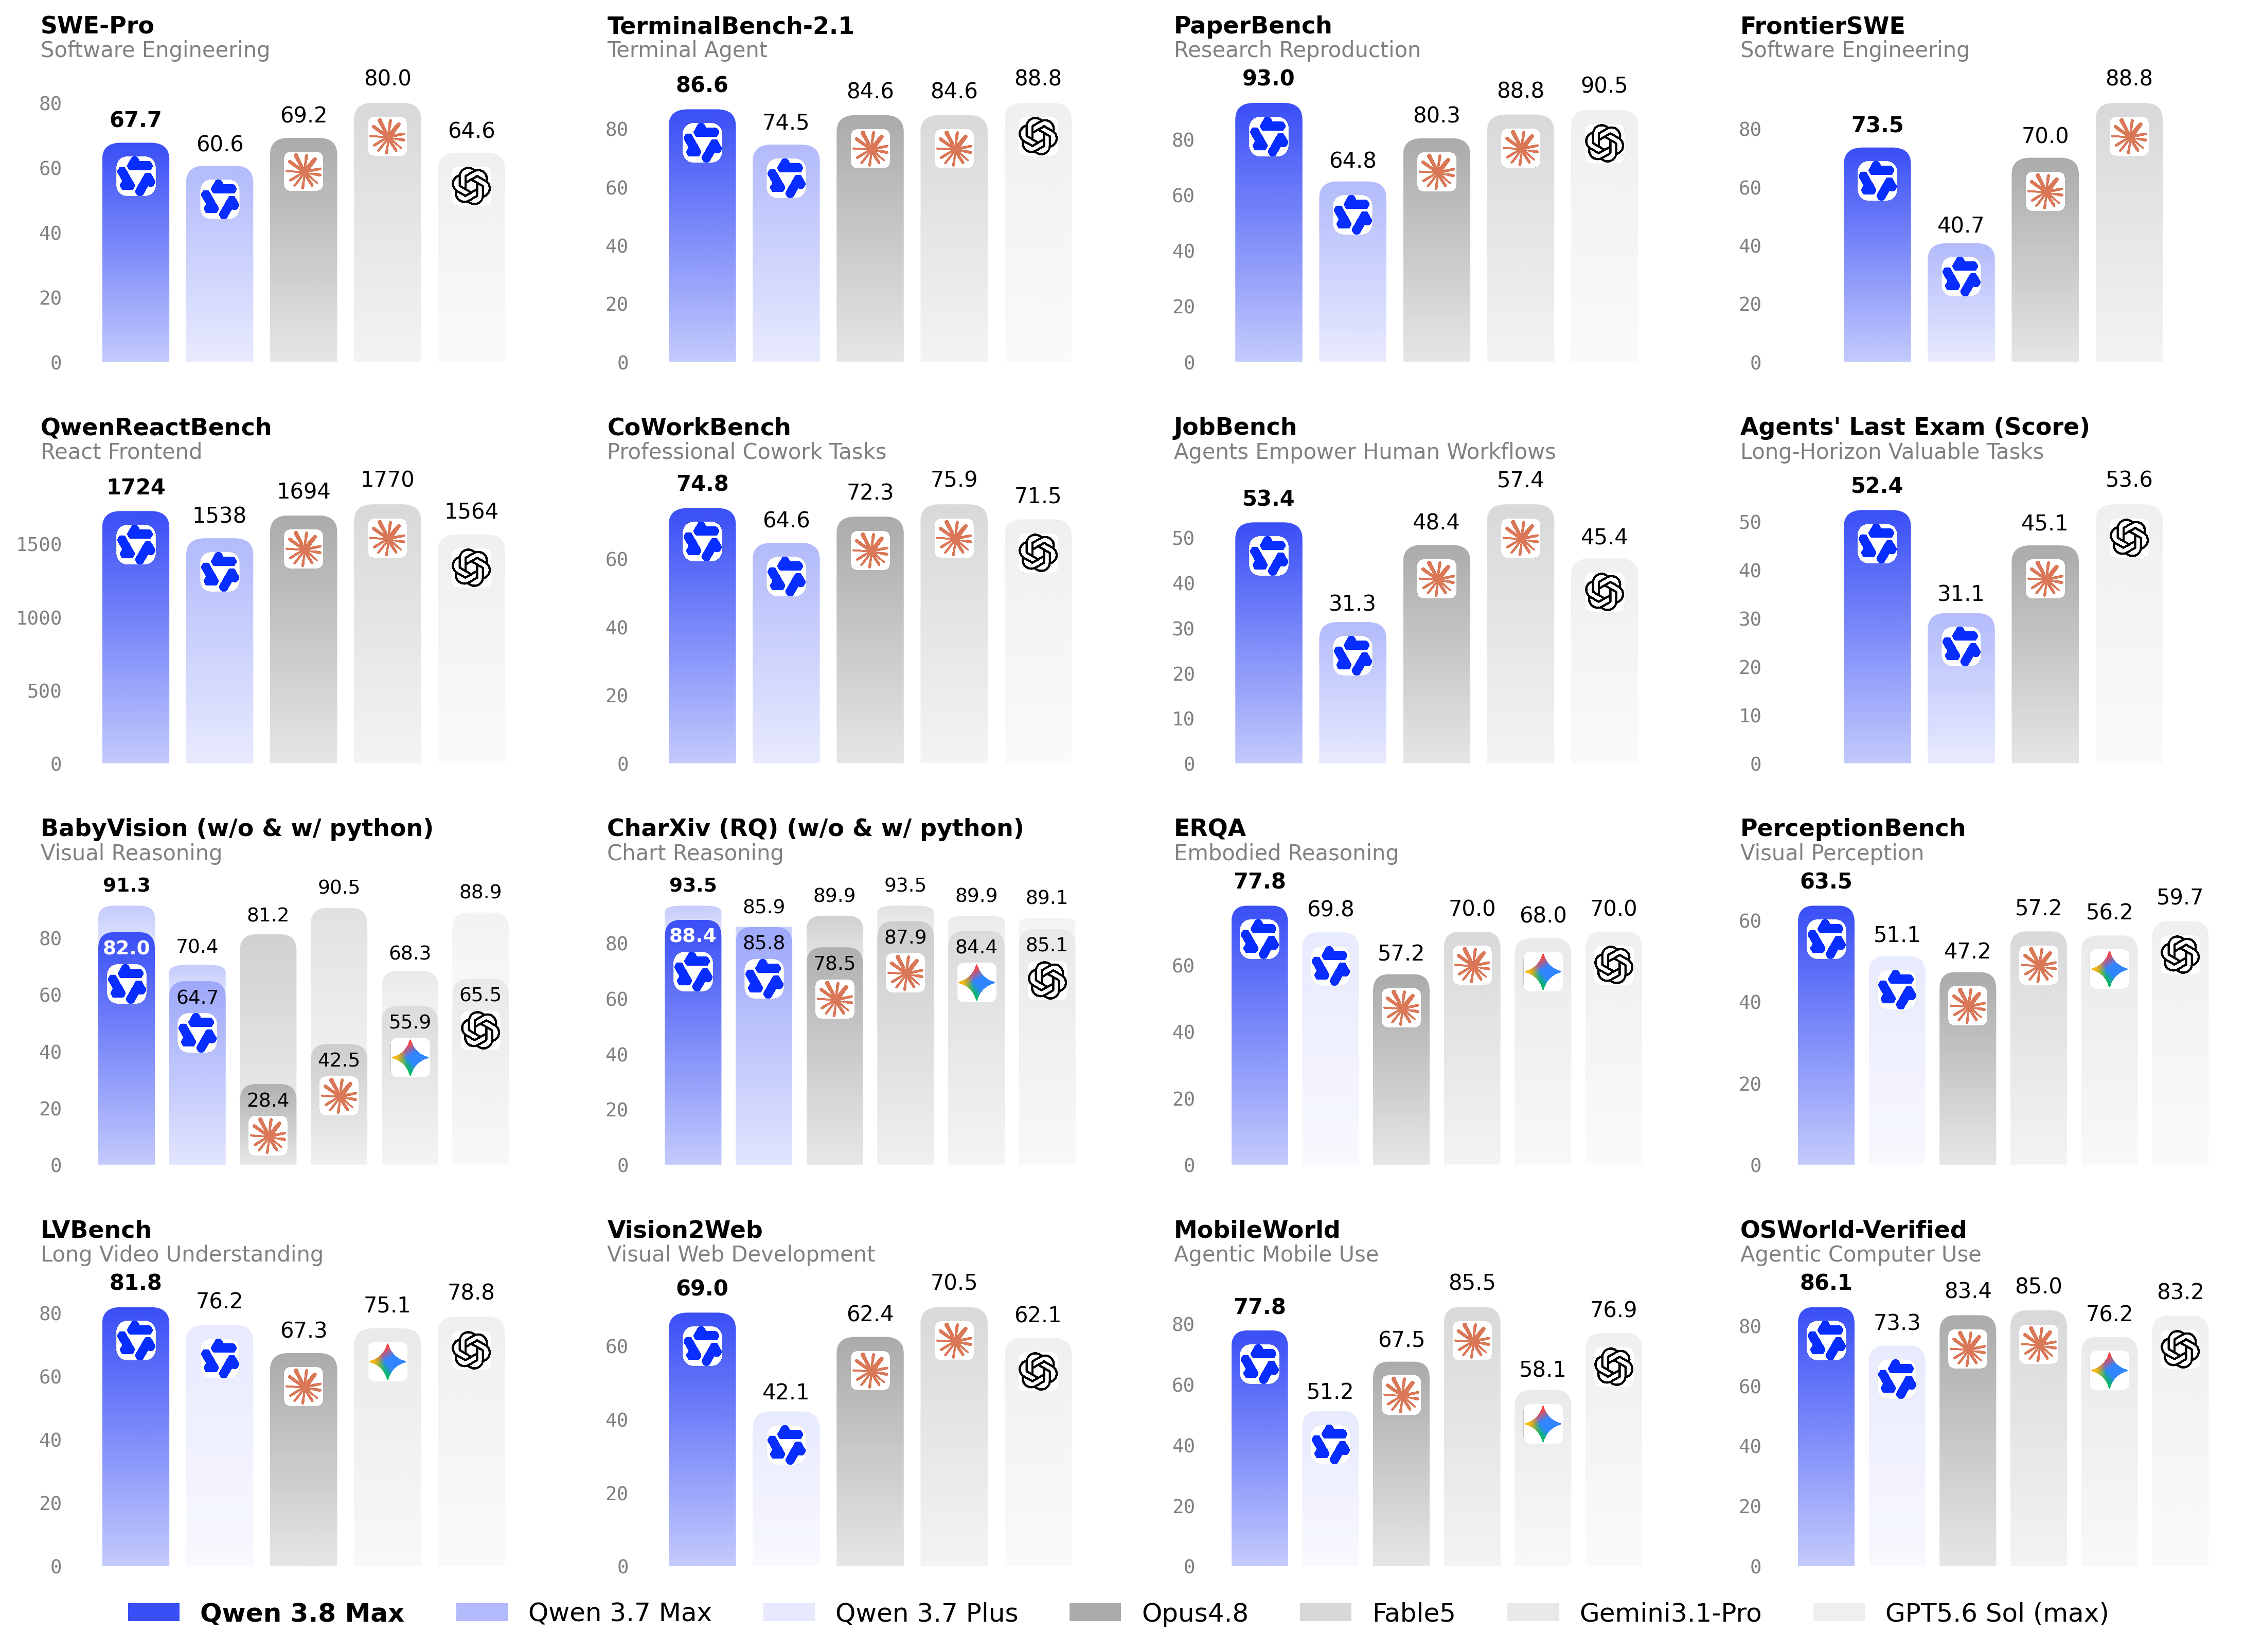
| PaperBench (논문 재현) | 93.0 | 80.3 | 88.8 | 90.5 |
| IFBench (지시 따르기) | 82.8 | 62.2 | 63.5 | 72.7 |
| WideSearch (대규모 검색) | 81.9 | 72.9 | 81.2 | - |
| Terminal-Bench 2.1 (터미널 작업) | 86.6 | 84.6 | 84.6 | 88.8 |
| SWE-bench Pro (저장소 버그 수정) | 67.7 | 69.2 | 80.0 | 64.6 |
| DeepSWE 1.1 (코딩 에이전트) | 56.6 | 59.0 | 70.0 | 73.0 |
| HLE (다분야 난제) | 43.6 | 45.7 | 53.3 | 47.2 |
논문 한 편을 코드로 재현하는 PaperBench에서 93.0점으로 GPT-5.6 Sol보다 2.5점 높았고, 지시를 그대로 따르는 IFBench와 대규모 검색 WideSearch도 비교 모델 가운데 가장 높았습니다. 반면 SWE-bench Pro는 Fable 5보다 12.3점, DeepSWE 1.1은 GPT-5.6 Sol보다 16.4점 낮았고, 어려운 지식 문제를 모은 HLE는 세 경쟁 모델 모두에 못 미쳤습니다.
직전작과 비교하면 이 모양이 더 뚜렷합니다. 터미널 작업은 74.5점에서 86.6점으로 12.1점, DeepSWE는 21.6점에서 56.6점으로 35점 올랐습니다. 같은 기간 HLE는 41.4점에서 43.6점, GPQA는 92.4점에서 92.6점으로 거의 그대로였습니다.
알리바바가 비교 상대로 고른 모델은 Opus 4.8과 Fable 5, GPT-5.6 Sol 셋입니다. 7월 24일 나온 Opus 5와, 문샷AI가 7월 27일 가중치를 푼 Kimi K3는 표에 없습니다.
공개 당일 나온 사람 심사 결과에서는 이 둘이 Qwen3.8-Max보다 위에 있었습니다. 아레나는 같은 요청에 대한 두 모델의 답을 사람에게 보여 주고 더 나은 쪽을 고르게 해서 점수를 매기는데, 프런트엔드 코드 부문에서 Qwen3.8-Max는 1,668점으로 4위였습니다. 1위 Claude Opus 5 Max(1,705점), 2위 Kimi K3(1,676점), 3위 Opus 5 High(1,669점) 다음이고, Fable 5(1,630점)와 GPT-5.6 Sol(1,620점)은 그 아래였습니다.
자체 표에서 SWE-bench Pro가 Fable 5에 12.3점 밀린 모델이, 사람이 결과물을 보고 고른 순위에서는 Fable 5보다 38점 위에 섰습니다. 다만 표본이 1,563표라 잠정 표시가 붙었고, 예상 순위 범위도 2위에서 4위까지 넓게 잡혀 있었습니다. 비전 부문은 1,305점으로 2위, 텍스트 부문은 1,496점으로 5위였고, 텍스트의 분야별 순위는 의료·헬스케어 1위, 소프트웨어·IT 9위, 글쓰기 14위로 편차가 컸습니다.
표 아래 각주에는 점수를 움직일 조건이 적혀 있습니다. 첫 줄에 Fable 5 결과에는 폴백(안전장치에 걸린 요청을 다른 모델이 대신 답하는 방식)이 섞였을 수 있다고 적었습니다. 앤트로픽은 Opus 5를 내놓으면서 Fable 5에서 막힌 요청을 Opus 4.8 대신 Opus 5가 받도록 바꿨습니다. 터미널 작업과 SWE-bench Pro, 자체 평가 대부분은 앤트로픽의 Claude Code 하네스(모델에 도구를 쥐여 주고 실행 결과를 되돌려 주는 실행 틀)로 쟀습니다. 논문 재현 PaperBench의 채점은 Claude Opus 4.6이 맡았습니다.
독립 지수는 발표 당일 비어 있었습니다. 아티피셜애널리시스의 지능 지수 4.1에서 Opus 5는 60.7점, Fable 5는 59.9점, GPT-5.6 Sol은 58.9점, Kimi K3는 57.1점인데 Qwen3.8-Max는 아직 등재되지 않았습니다. 직전작 Qwen3.7-Max가 46점이었고 이번에 크게 오른 항목이 에이전트 쪽에 몰려 있어, 저는 50점대 초중반에 들 것으로 봅니다.
알리바바는 같은 모델을 자사 QwenWork와 앤트로픽의 Claude Code, 오픈AI의 Codex, OpenClaw, Hermes로 재도 점수가 비슷하게 나온다는 그림을 실었습니다. 사무 업무 평가 CoWorkBench에서 하네스별 점수는 73.2~75.8점으로 2.6점 안에 모였습니다. 경쟁사가 만든 실행 틀 두 개가 자사 도구와 함께 측정 환경으로 들어가 있습니다.

발표가 맨 앞에 세운 사례는 저장소 하나입니다. 빈 폴더에서 oh-my-cli라는 명령줄 도구를 만들게 했고, 요구사항이 GitHub 이슈로 올라오면 에이전트가 맡아 구현하고 테스트와 CI를 통과해야 병합되는 구조를 모델이 직접 짰습니다. 7월 30일 기준 약 16일 동안 사람 손 없이 커밋 265개와 PR 127개, 이슈 151개가 쌓였습니다. 저장소가 공개돼 있어 기록을 누구나 볼 수 있고, 발표 날 제가 다시 열어 봤을 때 커밋은 424개로 늘어 있었습니다.
두 번째 사례에서는 최신 논문 한 편과 GPU만 주고 약 125시간 동안 혼자 코드 7,600줄을 짜고 GPU 학습을 33번 돌리게 했더니, 논문의 주요 결과 여섯 가지를 재현한 뒤 수학 평가 AIME24 점수를 논문 방식(49.58%)보다 2.71점 높은 52.29%로 올렸습니다. 세 번째로는 알리바바 클라우드 톈츠에서 열린 멀티모달 대화 의도 인식 대회에 24시간 제한으로 참가해, 45번 제출 끝에 정확도 0.853으로 사람 팀 526곳 가운데 458곳을 앞섰습니다.
긴 작업 사례로는 암호 연산용 하드웨어 가속기 설계가 있습니다. 정답 회로 없이 빈 템플릿과 시뮬레이션·합성·배치 도구만 주고 약 500턴 동안 혼자 설계를 고치게 했는데, 처음 작동한 설계의 게이트(논리 회로의 기본 단위) 8,298개가 마지막에 678개가 됐습니다.
| 구간 | 한 일 | 게이트 수 |
|---|---|---|
| 시작 | 처음 작동한 설계 | 8,298 |
| 22턴 | 나눗셈 회로를 뺄셈 반복 구조로 교체 | 2,010 |
| 35~48턴 | 중복 단계 제거, 비트 폭 축소 | 1,304 |
| 60~113턴 | 레지스터와 제어 회로 정리 | 907 |
| 170~252턴 | 모듈 합치기, 뺄셈기 공유 | 765 |
| 443~500턴 | 게이트 단위 마무리 | 678 |
22턴째 한 번의 구조 변경으로 6,288개가 줄었고, 쉬운 개선이 끝난 443턴 이후에도 87개를 더 줄였습니다. 실제 배치까지 돌린 칩 면적은 106×106µm²에서 46×46µm²로 81% 줄었고, 500MHz 타이밍 조건도 맞췄습니다.
1년짜리 상점 운영 시뮬레이션(E-Commerce Bench)도 있습니다. 타오바오·티몰 거래 데이터로 만든 환경에 상품 7,000개와 공급업체 약 600곳을 두고 초기 자금 10만 위안으로 여러 상점을 운영하게 했는데, 공급업체 가운데 152곳은 회비 사기와 미끼 가격을 쓰는 가짜였습니다. Qwen3.8-Max는 1년 뒤 잔고 41만 6,252위안으로 초기 자금을 4.16배로 불렸고, 2위 GLM 5.2보다 38% 많았습니다.
모든 사례는 알리바바가 직접 돌린 시연입니다. oh-my-cli처럼 기록이 공개된 사례도 있지만, 나머지는 같은 결과를 다시 얻는 조건과 시도 횟수가 발표에 없습니다.
알리바바가 이런 결과의 배경으로 든 것은 강화학습 환경입니다. 과제는 한 개에서 여러 개로, 다시 여러 날짜리로 늘렸고, 작업 공간은 파일 몇 개에서 계층 폴더와 복잡한 폴더 묶음으로 넓혔으며, 하네스는 종류와 버전, 스킬별로 갖췄습니다. 세 축을 따로 늘려 조합하면 환경 수가 곱으로 불어납니다.
채점기는 하나로 묶었습니다. 코드를 실행해 확인하는 방식과 기준표에 따라 글과 화면을 판정하는 방식, 에이전트가 결과를 직접 점검하는 방식을 한 보상 체계 안에 넣었고, 과제마다 채점기를 따로 두면 기준이 서로 어긋난다는 이유를 들었습니다. 학습 묶음마다 과제와 난이도, 작업 공간, 하네스의 분포를 고르게 맞추는 장치도 따로 뒀습니다.

그림에서 10여 개 평가의 종합 점수는 지도학습만 마친 상태의 0.474에서 시작해 환경 4,000개일 때 0.725로 가장 높았고, 5,000개에서는 0.689로 내려갔습니다. 그림은 환경 4,000개 지점을 가장 좋은 체크포인트로 표시했습니다.
알리바바의 돈은 모델 사용료만으로 벌리지 않습니다. 알리바바가 실적 발표에서 밝힌 숫자로 클라우드 외부 매출은 40% 늘었고, AI 관련 제품 매출은 11개 분기 연속 세 자릿수 성장을 이어 가 분기 90억 위안, 연환산 53억 달러가 됐습니다. 앞으로 3년 동안 3,800억 위안을 인프라에 넣겠다는 계획도 내놓았습니다. 오픈웨이트 모델이 널리 쓰일수록 그 모델을 돌릴 연산 수요 일부가 자사 클라우드로 들어올 여지가 커집니다.
시장은 발표만으로 값을 매기지 않았습니다. 7월 프리뷰가 공개된 직후 알리바바 주가는 3.7% 올랐다가, 같은 주 안에 상승분을 거의 반납했습니다.
2.4조 모델의 가중치가 풀려도 개인이나 대부분의 기업이 직접 돌리기는 어렵습니다. 함께 예고된 27B는 사내 서버나 고성능 PC에서 돌릴 수 있는 크기라, 국내 팀이 먼저 비교해 볼 대상은 이쪽입니다. 7월 업스테이지가 공개한 Solar Open 2(전체 250B, 활성 15B)와 7월 31일 LG AI연구원이 공개한 K-엑사원 2.0(750B)도 이제 이 27B와 비교됩니다.
라이선스는 발표에 한 줄도 없었습니다. 문샷AI는 7월 27일 Kimi K3 가중치를 올리면서 커널과 통신 라이브러리, 에이전트 환경 도구까지 MIT 라이선스로 풀었습니다. Qwen3.8-Max 가중치가 제약이 적은 라이선스로 나오는지, 자체 라이선스로 나오는지에 따라 국내 기업이 모델을 고쳐 상용 서비스에 얹을 수 있는 범위가 달라집니다.
읽어 주셔서 고맙습니다.
초이 드림