이 글 어땠어요?
원소들의 집합 위에 결합법칙을 지키는 연산 하나가 있는 구조입니다. 군과 달리 항등원과 역원이 없어도 되고, 원소가 6개면 6×6 곱셈표 하나로 정해집니다.
유한 기저가 없는 6차 반군이 4개뿐이라는 결론은 2012년에 나왔습니다. 이번에는 나머지 1만 5,969개 모두에 실제 기저 목록을 붙이고 전부를 Lean으로 검증했는데, 그중 1만 4,534개는 그동안 기저가 있다는 것만 알려져 있었습니다.
공략할 반군을 고르고, 저장소 반영을 승인하고, 멈춘 에이전트를 다시 시작했습니다. Codex 에이전트에 440번, 심판 에이전트에 674번 지시했고 증명은 쓰지 않았습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
오픈AI가 8월 1일 미출시 모델 Astra로 27년 열려 있던 비소픽 군 문제를 포함해 난제 열 건을 풀고 249쪽 논문과 Lean 인증서를 공개했습니다. 성공한 해답에 쓴 토큰은 약 2,000달러어치였고, 실패한 시도의 수는 알 수 없습니다.
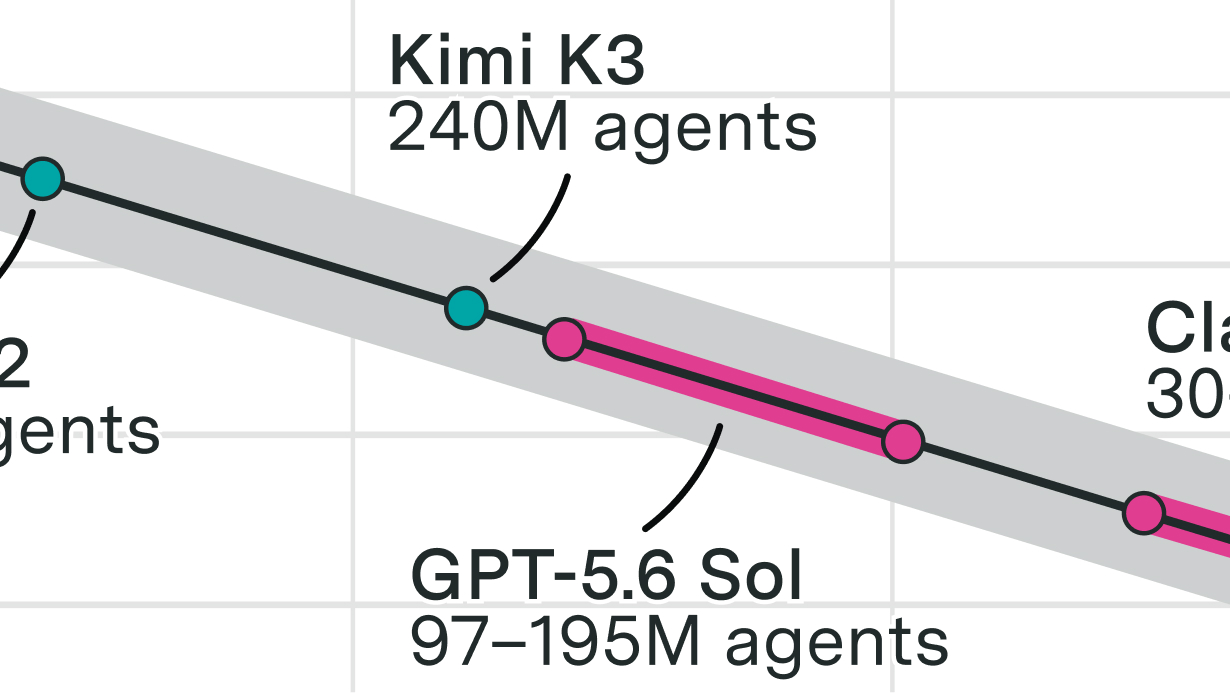
에포크 AI가 10월 2일 HBM 출하량으로 AI 에이전트 수를 셌습니다. 2027년까지 나올 메모리로 프런티어 에이전트 3,300만~1억 7,100만 개를 동시에 돌릴 수 있고, 용량의 20%만 써도 연 2조 6,000억~5조 3,000억 달러어치입니다.
모델의 첫 실질 응답은 지시를 거절한 것이었습니다. 후보 106개 어디에도 부분 증명이라 부를 줄기가 없다고 적었습니다. 결과는 실패가 남긴 장애물 기록에서 나왔고, 두 세션 3,100만 토큰이 들었으며, 리만 가설 자체는 조금도 가까워지지 않았습니다.
오픈AI가 8월 1일 미출시 모델 Astra로 27년 열려 있던 비소픽 군 문제를 포함해 난제 열 건을 풀고 249쪽 논문과 Lean 인증서를 공개했습니다. 성공한 해답에 쓴 토큰은 약 2,000달러어치였고, 실패한 시도의 수는 알 수 없습니다.
에포크 AI가 10월 2일 HBM 출하량으로 AI 에이전트 수를 셌습니다. 2027년까지 나올 메모리로 프런티어 에이전트 3,300만~1억 7,100만 개를 동시에 돌릴 수 있고, 용량의 20%만 써도 연 2조 6,000억~5조 3,000억 달러어치입니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@nasqretX 게시물 · 원문 보기
나스크렝츠키는 논문보다 4일 앞선 10월 3일 새벽 X에 결과를 먼저 알렸습니다. Codex와 Claude Code로 돌린 AI 에이전트 여럿이 3개월 동안 쉬지 않고 일해 6차 반군 1만 5,973개 전부의 분류를 마쳤다는 내용입니다. Lean 코드는 그보다 앞서 깃허브에 올렸고, 같은 날 새벽 Zenodo에 1.0.0판(파일 7,397개, 590만 줄)으로 보관했습니다. 논문 「Proving at Scale for Universal Algebra」는 NeurIPS 2026 수학·AI 워크숍(MATH-AI)용 원고로, 10월 7일 새벽 공저자인 체코공대 미콜라시 야노타의 홈페이지에 올라왔습니다.
반군은 원소들의 집합과 그 위의 연산 하나로 이뤄집니다. 조건은 결합법칙 하나뿐이라서, 어떤 세 원소를 골라도 (x∗y)∗z와 x∗(y∗z)가 같기만 하면 됩니다. 정수의 덧셈처럼 0과 음수가 갖춰진 군(group)과 달리 항등원이나 역원이 없어도 됩니다. 원소가 유한하면 연산 전체를 곱셈표 한 장으로 적을 수 있고, 원소가 6개면 6×6 곱셈표 하나가 반군 하나입니다.
가장 쉬운 예는 원소 2개짜리 「왼쪽 사영」입니다. 무엇을 곱하든 왼쪽 원소를 답으로 내놓는 규칙(x∗y=x)인데, 이 규칙은 결합법칙을 지킵니다. 원소 이름만 바꾼 것과 곱셈표를 대각선으로 뒤집은 것을 같은 것으로 치면, 크기별 반군의 수는 다음과 같습니다.
| 원소 수 | 반군 수 | 그 가운데 멱영 반군 |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 4 | 1 |
| 3 | 18 | 2 |
| 4 | 126 | 10 |
| 5 | 1,160 | 93 |
| 6 | 1만 5,973 | 2,813 |
| 7 | 83만 6,021 | 61만 6,830 |
멱영 반군은 원소를 일정 개수 이상 곱하면 늘 0이 되는 반군입니다. 짧은 등식만 따지면 돼서 이번 문제에서는 쉬운 쪽이고, 6차에서는 6분의 1이지만 7차에서는 4분의 3을 차지합니다.
항등식은 변수에 어떤 원소를 넣어도 늘 성립하는 등식입니다. 0과 1 두 원소로 덧셈을 하는 군(Z₂)에서는 x+x=0이 항등식이고, x+x+x+x=0도 성립하지만 앞의 식에서 바로 따라 나옵니다. 이 군에서 성립하는 모든 등식은 군의 공리와 x+x=0에서 유도되는데, 이렇게 모든 항등식을 유도해 내는 유한한 목록을 항등식 기저라고 부릅니다. 앞의 왼쪽 사영에서는 xy=x 하나가 기저입니다.
1968년 폴란드 출신 논리학자 알프레트 타르스키는 유한한 대수마다 이런 유한 기저가 있는지 물었습니다. 유한군은 1964년 늘 유한 기저를 가진다는 것이 증명됐지만, 1996년 랠프 매켄지는 유한 대수에 유한 기저가 있는지 판정하는 일반 절차가 없다는 것을 보였습니다. 반군에서는 판정이 가능한지조차 아직 열려 있습니다.
유한 기저가 없는 가장 작은 반군은 원소가 6개이고, 2012년 에드먼드 리 등이 그런 반군이 정확히 4개라는 것을 보였습니다. 이 4개에는 변수를 점점 더 많이 쓰는 등식이 끝없이 이어지고, 변수가 k개 이하인 등식만으로는 그중 일부를 끝내 유도하지 못합니다. Lean으로 옮긴 논증은 L이 Zhang·Luo(2011), B₂¹이 Perkins(1969)와 Sapir(1988), A₂¹이 Trahtman(1987)과 Sapir(1988)의 것입니다.
| 반군 (Smallsemi 번호) | 끝없이 이어지는 등식 | Lean 분량 |
|---|---|---|
| L (3,843번) | x y₁²⋯yₙ² x ≈ x yₙ²⋯y₁² x | 파일 6개, 5,337줄 |
| B₂¹ (8,564번) | x y₁⋯yₙ x yₙ⋯y₁ ≈ x yₙ⋯y₁ x y₁⋯yₙ | 파일 8개, 1만 2,747줄 |
| A₂¹ (1만 3,747번) | X y X′ y X ≈ X y X′ y X y X′ y X (X=x₁⋯xₙ, X′은 역순) | 파일 8개, 1만 502줄 |
| A₂ᵍ (8,878번) | (x₁²⋯xₙ²)² ≈ (x₁²⋯xₙ²)³ | 파일 2개, 2,625줄 |
이번 결과의 수학적 결론 자체는 새것이 아닙니다. 4개만 예외라는 사실은 2012년에 나왔고, 리와 장원팅(Wen Ting Zhang)은 2015년 129쪽 논문에서 6차 반군을 자세히 다뤘습니다. 다만 Zenodo 기록에 따르면 그중 1만 4,534개는 유한 기저가 있다는 충분조건으로 처리돼, 기저가 존재한다는 것만 알았지 실제 목록은 적혀 있지 않았습니다.
SemiBase라는 이름의 이번 프로젝트는 1만 5,969개 모두에 실제 기저 목록을 붙이고, 그 목록이 정말 기저라는 증명과 나머지 4개에 기저가 없다는 증명을 모두 Lean 커널에 통과시켰습니다. 결과는 SemiBase.order6_classification이라는 정리 하나로 묶였습니다. 저자는 포르투갈 리스본 신대학교의 조앙 아라우주, 체코공대의 얀 훌라와 미콜라시 야노타, 미국 노바사우스이스턴대의 에드먼드 리, 폴란드 아담 미츠키에비치대와 바르샤바공대에 적을 둔 나스크렝츠키입니다. 2015년 논문을 쓴 리가 이번에도 저자로 들어 있습니다.
증명된 기저를 비교하는 작업도 함께 했습니다. 인증된 서로 다른 기저 536개는 자동 정리 증명기 Vampire로 군더더기를 덜어 내자 항등식 7,919개가 1,781개로 줄었고, 기저들이 정의하는 다양체(같은 항등식을 만족하는 대수 전체의 모임)는 505개로 정리됐습니다. 505개 사이의 포함 관계 1만 3,325개, 바로 위아래로 이어지는 쌍 1,317개, 더 위가 없는 다양체 87개도 모두 밝혔는데, 이 부분은 Vampire 증명과 곱셈표 평가로 얻었고 Lean으로는 형식화하지 않았다고 논문은 밝혔습니다. 증명을 찾다가 만난 어려운 문제 289개는 자동 정리 증명기의 성능을 재는 TPTP 문제 모음용으로 정리했습니다. 공개 웹사이트에서는 반군마다 곱셈표와 기저, Lean 증명 위치를 찾아볼 수 있습니다.
작업은 에이전트 여럿이 나눠 맡았습니다. 수학을 하는 작업자 에이전트 3개와 일을 배분하고 빌드를 돌리는 조정 에이전트 1개는 Codex 에이전트(GPT-5 계열 모델)이고, 후보 기저를 인증하고 에이전트 사이의 다툼을 정리하는 심판은 Claude 에이전트입니다. 논문은 심사하는 쪽과 심사받는 쪽이 서로 다른 모델 계열에서 오도록 짰다고 적었습니다.
| 맡은 쪽 | 한 일 | 규모 (6월 9일~9월 6일) |
|---|---|---|
| 사람 | 공략할 반군 선택, 저장소 반영 승인, 멈춘 에이전트 재시작 | 지시 1,114번 (Codex 쪽 72일간 440번, 심판 쪽 61일간 674번) |
| 작업자·조정 에이전트 (Codex) | 후보 기저 제안, 반례 탐색, 증명과 증명 생성기 작성, 빌드 | 세션 약 2,260개, 로그 100GB 넘게 |
| 심판 에이전트 (Claude) | 후보 인증, 다툼 정리, 목록 반영 결정 | 모델 턴 4만 3,236번, 출력 토큰 4,190만 개 |
| Lean 빌드 | 증명 검사와 전체 감사 | 빌드 작업 1만 8,222건, 약 1,500 코어시간 |
반군의 94%인 1만 4,989개는 에이전트가 6~7월에 사람의 지시로 짠 스크립트가 언어 모델 없이 처리했습니다. 짧은 항등식을 범위를 정해 훑거나 문헌의 기저를 가져와 붙이는 방식이었고, 남은 984개는 에이전트가 하나씩 매달렸습니다. 후보 기저를 내고, 그 후보를 깨는 반례를 찾고, 여러 반군이 함께 쓰는 「가족 증명」과 반군별 증명을 찍어 내는 생성기를 썼습니다. Codex 세션은 6월 약 660개, 7월 약 1,510개, 그 뒤 약 90개였고, 저장소에는 커밋 4,923개가 쌓였습니다.
심판 에이전트는 검증을 맡지 않습니다. 일을 나누고 다툼을 정리할 뿐이고, 한 반군은 전체 감사에서 Lean 커널이 증명을 다시 검사했을 때만 받아들여집니다.— SemiBase 논문
거르는 장치도 바쁘게 돌았습니다. 공동 기록을 쓰기 시작한 8월 8일부터 9월 6일까지 후보 76개가 Lean을 쓰기 전에 반례로 탈락했고, 독립 커널 검사 443건 가운데 143건이 증명을 작성자에게 돌려보냈습니다. 심판 기록 385건 가운데 약 106건은 제안을 반려하거나 거두거나 보류한 기록입니다. 작업자는 두 번(나중에는 세 번) 실패하면 멈추고 심판에게 보고해야 했습니다.
성공한 완전성 증명은 모두 같은 모양이었습니다. 단어(변수를 곱해 늘어놓은 식)의 표준형을 하나 정하고, 기저에서 끌어낸 고쳐 쓰기 규칙 몇 개로 어떤 단어든 표준형까지 끌고 갑니다. 그다음 표준형이 곱셈표가 알아볼 수 있는 몇 가지 특징, 예를 들어 글자들이 처음 나오는 순서와 마지막으로 나오는 순서, 글자마다 나온 횟수의 홀짝으로 정해진다는 것을 보입니다. 기저가 같은 반군들은 이 증명을 함께 쓰고, 표마다 기저의 항등식이 성립하는지만 계산으로 확인합니다.
가족 증명으로 처리하지 못한 445개 반군에는 기계가 생성한 증명이 하나씩 붙었습니다. 가장 흔한 방법은 이미 끝낸 반군에서 기저를 옮겨 오는 것입니다. 기저 B가 증명된 반군 S가 목표 반군 T의 곱셈 구조 안에 특정한 방식으로 담기면 T의 항등식은 모두 S에서도 성립하므로 B에서 유도되고, T가 B를 만족하는지만 표에서 확인하면 B가 T의 기저가 됩니다. 원소 5개 이하 반군 1,309개의 결과는 6차 반군 대부분에서 이 옮겨 오기의 출발점으로 쓰였습니다.
기저는 대부분 짧습니다. 공개 웹사이트 집계로 1만 5,969개 가운데 1만 228개는 가장 짧게 알려진 기저가 항등식 2개이고, 1개로 끝나는 반군도 265개입니다. 인증 당시 가장 긴 기저는 2,582번 반군의 항등식 3,513개였는데, 줄여 보니 3개면 충분했습니다.
가장 오래 걸린 것은 3,842번 반군이었습니다. 유한 기저가 없는 L과 곱셈표 36개 항목 가운데 딱 두 항목이 다른데, 이 차이 때문에 L에서 유한 기저를 막던 등식 가족이 끊겨 유한 기저를 갖습니다. 처음 후보는 변수 3개 이하 항등식 9개였고 심판도 승인했습니다. 8월 29일 한 작업자가 원소 20개짜리 반군을 찾아 이 후보를 깼는데, 9개를 다 만족하면서도 3,842번 반군의 항등식 하나를 어기는 반군이었습니다.
에이전트들은 리와 장원팅이 2015년 논문에 적은 기저(항등식 38개)로 갈아탔지만, 그 기저가 완전하다는 증명이 한 주 넘게 닫히지 않았습니다. 9월 5일 심판 에이전트가 이 반군에서 두 단어가 같아지는 조건과 표준형을 구조 분석으로 찾아냈고, 그 조건은 변수 4개 이하, 길이를 제한한 단어 전부에서 계산으로 먼저 확인된 뒤 증명 계획으로 에이전트에게 넘어갔습니다. 9월 6일 전담 에이전트가 새 모듈 25개(2,918줄, 정리 169개)로 증명을 끝냈고, 같은 날 전체 감사가 1만 5,973개를 함께 인증했습니다. 저장소에서 이 증명 파일의 이름은 Order6Astra인데, 저장소 설명은 증명을 쓴 에이전트의 이름을 땄다고만 적었습니다.
Lean 증명을 믿는다는 말은 Lean 커널과 사람이 읽은 정의를 믿는다는 말입니다. 그래서 저장소는 읽는 사람이 확인할 범위를 따로 적어 두었습니다. 단어와 항등식, 유도, 기저의 정의가 담긴 파일 세 개의 앞 80줄, 무엇을 주장하는지 적은 파일의 앞 80줄, 곱셈표 데이터, 최종 정리 파일입니다. 나머지는 모두 커널이 검사하는 증명입니다. 쓰인 공리는 Lean의 기본 공리 세 개뿐이고, 증명을 건너뛰는 sorry나 계산을 커널 밖으로 넘기는 native_decide는 없습니다.
곱셈표가 진짜 6차 반군 목록인지도 따로 확인할 수 있게 해 두었습니다. 표는 수학 계산 시스템 GAP의 Smallsemi 0.7.2에서 내보냈고, 파일 해시를 고정해 두었으며, 따로 처음부터 다시 생성한 목록과도 1만 5,973개 모두 일치했습니다. 9월 6일 최종 감사는 모듈 약 7,200개를 2일 동안 일곱 번 돌렸고, 마지막 증분 실행은 코어 4개로 4시간 6분이 걸렸습니다. 독립 재인증에서는 새로 내려받은 저장소를 병렬 작업 96개로 약 2시간 만에 다시 빌드해 실패 없이 통과했습니다. 수학 라이브러리 Mathlib 없이 Lean 4.28만으로 빌드되고, 24코어·메모리 220GB 장비 한 대로 처음부터 빌드하면 20시간 40분이 걸립니다.
| 증명 종류 | 개수 | 중앙값 | 가장 긴 것 | 합계 |
|---|---|---|---|---|
| 반군 하나씩 기계로 생성한 증명 | 445개 | 334줄 | 33만 3,557줄 | 322만 줄 |
| 에이전트가 쓴 가족 증명 파일 | 2,443개 | 170줄 | 9,568줄 | 83만 3,000줄 |
| 감사 모듈 | 1,213개 | 32줄 | 3,626줄 | 23만 줄 |
증명 크기는 1만 배 가까이 차이 납니다. 가족 증명은 중앙값 170줄로 사람이 읽을 만하지만, 생성 증명 9개는 10만 줄을 넘겨 생성 증명 전체 분량의 절반 가까이를 차지합니다. 가장 긴 12,824번 반군의 증명은 코어 하나로 빌드하는 데 하루가 넘게 걸렸습니다. 논문은 수학이 담긴 곳으로 가족 증명과 공용 라이브러리를 꼽았습니다. 가장 큰 증명들은 기계로 찍어 냈고, 2,918줄짜리 3,842번 증명에는 4주가 걸렸습니다.
비용은 끝으로 갈수록 커졌습니다. 8월 14일에 1만 5,583개가 끝나 97.6%를 채웠는데, 남은 390개에 23일이 더 들었습니다.
| 날짜 | 끝난 반군 |
|---|---|
| 스크립트 단계 | 1만 4,989개 |
| 8월 14일 | 1만 5,583개 |
| 8월 29일 | 1만 5,856개 |
| 9월 1일 | 1만 5,921개 |
| 9월 4일 | 1만 5,932개 |
| 9월 6일 | 1만 5,973개 |
논문은 증명의 어려움이 긴 꼬리 모양이라고 정리했습니다. 대부분은 거의 기계적인데 마지막 몇 개에 엄청난 자원이 들고, 그 끝 어딘가에서 에이전트가 실패하는 사례를 만날 가능성이 높다고 적었습니다. 가장 시간을 아낀 결정으로는 여러 반군이 한 기저를 나눠 쓰게 한 것과 Lean을 쓰기 전에 반례부터 찾은 것을, 가장 비싼 실수로는 기저를 찾을 때 단어 길이 한도를 너무 짧게 잡은 것과 반군을 한 묶음씩 따로 검사한 것을 꼽았습니다.
논문이 올라오고 약 4시간 뒤인 10월 7일 아침, 오픈AI가 내부 모델이 쓴 수학 원고 722편을 372개 묶음으로 깃허브에 공개했습니다. 오픈AI는 모델에 약 4,000개 문제를 냈고 결과 하나에 ChatGPT Pro의 사고 연산을 평균 3시간 썼다고 밝혔습니다. 저장소의 형식화 목록에 주 결과가 Lean으로 형식화된 원고로 올라 있는 것은 162편이고, 저장소 설명에는 형식화되지 않은 결과 일부에 문제가 있을 수 있다는 문장이 들어 있습니다.
@nasqretX 게시물 · 원문 보기
나스크렝츠키는 그날 아침 오픈AI 발표를 인용해 결과를 경탄하며 보고 있다고 썼습니다. 속도는 여기서 더 빨라질 뿐이라는 말과 함께, 곧 알릴 큰 소식이 있는데 그 목록에는 없는 것이라고 덧붙였습니다.
두 공개를 나란히 놓으면 내놓은 것이 다릅니다. 오픈AI 쪽은 처음 나온 결과가 많고 722편 가운데 162편에 Lean 형식화가 붙었으며, SemiBase는 이미 알던 결론을 1만 5,973건 모두 커널 검사로 닫았습니다. 9월 22일 오픈AI가 난제 100건과 독립 수학 자문그룹을 함께 발표했을 때 남은 물음은 그 결과를 누가 어떤 기준으로 확인하느냐였습니다. SemiBase는 사람이 읽을 범위를 정의 몇 파일로 줄이고 나머지 확인을 커널에 넘기는 방식으로 답을 냈습니다.
Lean으로 큰 묶음을 확인하는 일은 이 사이트에서도 몇 번 다뤘습니다. 9월 4일 앤트로픽은 페르마의 마지막 정리 증명 전체를 Claude 에이전트로 11일 만에 Lean으로 옮겼다고 밝혔습니다. 2024년 테렌스 타오가 제안한 등식 이론 프로젝트(ETP)도 사람의 증명과 자동 정리 증명기를 함께 써서 마그마(연산 하나만 있고 결합법칙도 요구하지 않는 구조)의 법칙 사이 함의 관계를 Lean으로 확인했고, SemiBase 논문은 ETP를 가장 가까운 비교 대상으로 들었습니다.
이번 작업의 에이전트는 일반 사용자도 쓰는 도구 위에서 돌았습니다. 작업자는 Codex CLI, 심판은 Claude Code였고, 사람이 넣은 지시는 3개월 동안 1,114번입니다. 논문은 달러로 환산한 비용을 밝히지 않았고 세션 수와 토큰, 코어시간만 적었습니다. 빌드 장비도 만만하지 않습니다. 저장소 설명에 따르면 가장 큰 생성 파일 하나를 컴파일하는 데 메모리가 약 50GB 들었습니다.
연구진의 다음 목표는 7차 반군 83만 6,021개입니다. 쉬운 멱영 반군을 빼도 21만 9,191개로, 6차의 비멱영 반군 1만 3,160개보다 16배 넘게 많습니다. 6차에는 3개월과 에이전트 세션 약 2,260개, 빌드 1,500 코어시간이 들었고 비용 대부분이 꼬리에 몰렸습니다. 논문은 7차로 가려면 지금까지의 기법을 다듬어 꼬리까지 자동으로 처리하게 만드는 일이 먼저라고 적었습니다.
7차는 수학적으로도 6차와 다릅니다. 유한 기저가 없는 7차 반군의 전체 목록은 아직 알려져 있지 않아서, 같은 작업이 7차에서 끝나면 사람이 몰랐던 분류가 처음으로 나옵니다. 논문은 이 작업 방식이 대상마다 주장을 따로 확인할 수 있고 증명 보조기로 진술할 수 있는 목록이라면 어디에나 옮겨 쓸 수 있다고 적었습니다.
읽어 주셔서 고맙습니다.
초이 드림


