이 글 어땠어요?
프롬프트는 요청마다 새로 쓰는 글이고, 컨텍스트 엔지니어링은 시스템 프롬프트와 스킬, CLAUDE.md, 메모리처럼 어떤 요청이 올지 모르는 채로 미리 써 두는 맥락 전체를 설계하는 일입니다. 앤트로픽은 원하는 결과를 낼 가능성이 가장 높은 최소한의 토큰 묶음을 찾으라고 권합니다.
저장소가 무엇을 하는지 짧게 적고, 토큰 대부분은 코드를 열어 봐서는 알기 어려운 함정에 쓰라고 권했습니다. 예로는 타입을 파일 하나에 몰아 두었다는 사실이 나왔고, 검증 방법처럼 긴 내용은 스킬로 빼서 CLAUDE.md에서 가리키기만 합니다.
앤트로픽이 이름을 든 모델은 Opus 5와 Fable 5이고, 손실이 없었다고 밝힌 범위는 자사 코딩 평가입니다. Free와 Pro 요금제의 기본 모델인 Sonnet 5는 이 글에 등장하지 않아, 다른 모델과 작업에서 얼마나 줄여도 되는지는 이 글로 알 수 없습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
모델을 고정한 채 하네스만 고쳐 SWE-bench 점수가 20%에서 50%로 올랐습니다. 앤트로픽 실험에서는 단독 실행이 20분·9달러에 고장 난 게임을, 하네스가 6시간·200달러에 플레이할 수 있는 게임을 냈습니다.
앤트로픽 Applied AI 팀의 플레이북은 최근 실제 작업 20~50개로 에이전트 설정을 회귀 시험하고, 운영 지표가 3σ를 넘을 때만 에이전트가 PR이나 사전 승인된 롤백으로 움직이게 합니다. 플레이별 효과 수치는 없습니다.
앤트로픽 Claude Code 팀이 7월 7일 모델과 노력 설정이 각각 무엇을 바꾸는지 설명했습니다. 블로그 예시에서 같은 과제를 low와 high로 맡기면 토큰이 약 400개와 2,800개로 7배 차이가 났고, 실측 도표의 이웃한 두 단계 차이는 1.3~2배였습니다.

모델을 고정한 채 하네스만 고쳐 SWE-bench 점수가 20%에서 50%로 올랐습니다. 앤트로픽 실험에서는 단독 실행이 20분·9달러에 고장 난 게임을, 하네스가 6시간·200달러에 플레이할 수 있는 게임을 냈습니다.
앤트로픽 Applied AI 팀의 플레이북은 최근 실제 작업 20~50개로 에이전트 설정을 회귀 시험하고, 운영 지표가 3σ를 넘을 때만 에이전트가 PR이나 사전 승인된 롤백으로 움직이게 합니다. 플레이별 효과 수치는 없습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@trq212X 게시물 · 원문 보기
시히파르는 X에 이 글을 올리며 최신 모델을 위해 Claude Code 시스템 프롬프트의 약 80%를 지웠고, 그 과정에서 시스템 프롬프트와 스킬, CLAUDE.md를 쓰는 법에 대해 배운 것을 적었다고 소개했습니다. 글은 그동안 컨텍스트 엔지니어링의 모범 사례로 통하던 여러 원칙이 이제는 근거 없는 믿음이 됐다고 적었고, 규칙 파일을 모든 관행의 창고로 만들어야 Claude가 찾는다는 생각도 오해라고 짚었습니다. 도구를 만든 회사가 규칙을 더하는 대신 지우는 쪽을 권한 겁니다.
프롬프트는 요청이 올 때마다 새로 씁니다. 시스템 프롬프트와 스킬, CLAUDE.md, 메모리는 어떤 요청이 올지 모르는 채로 미리 써 두는 글이고, 사용자가 무엇을 물을지 모르니 좁혀 쓸 수가 없습니다. CLAUDE.md는 저장소에 두고 Claude가 작업 전에 읽게 하는 안내 파일이고, 스킬은 필요할 때 불러 쓰는 작업 안내서입니다. 시히파르는 이렇게 여러 곳에서 모이는 맥락 전체를 설계하는 일을 컨텍스트 엔지니어링이라고 불렀습니다.
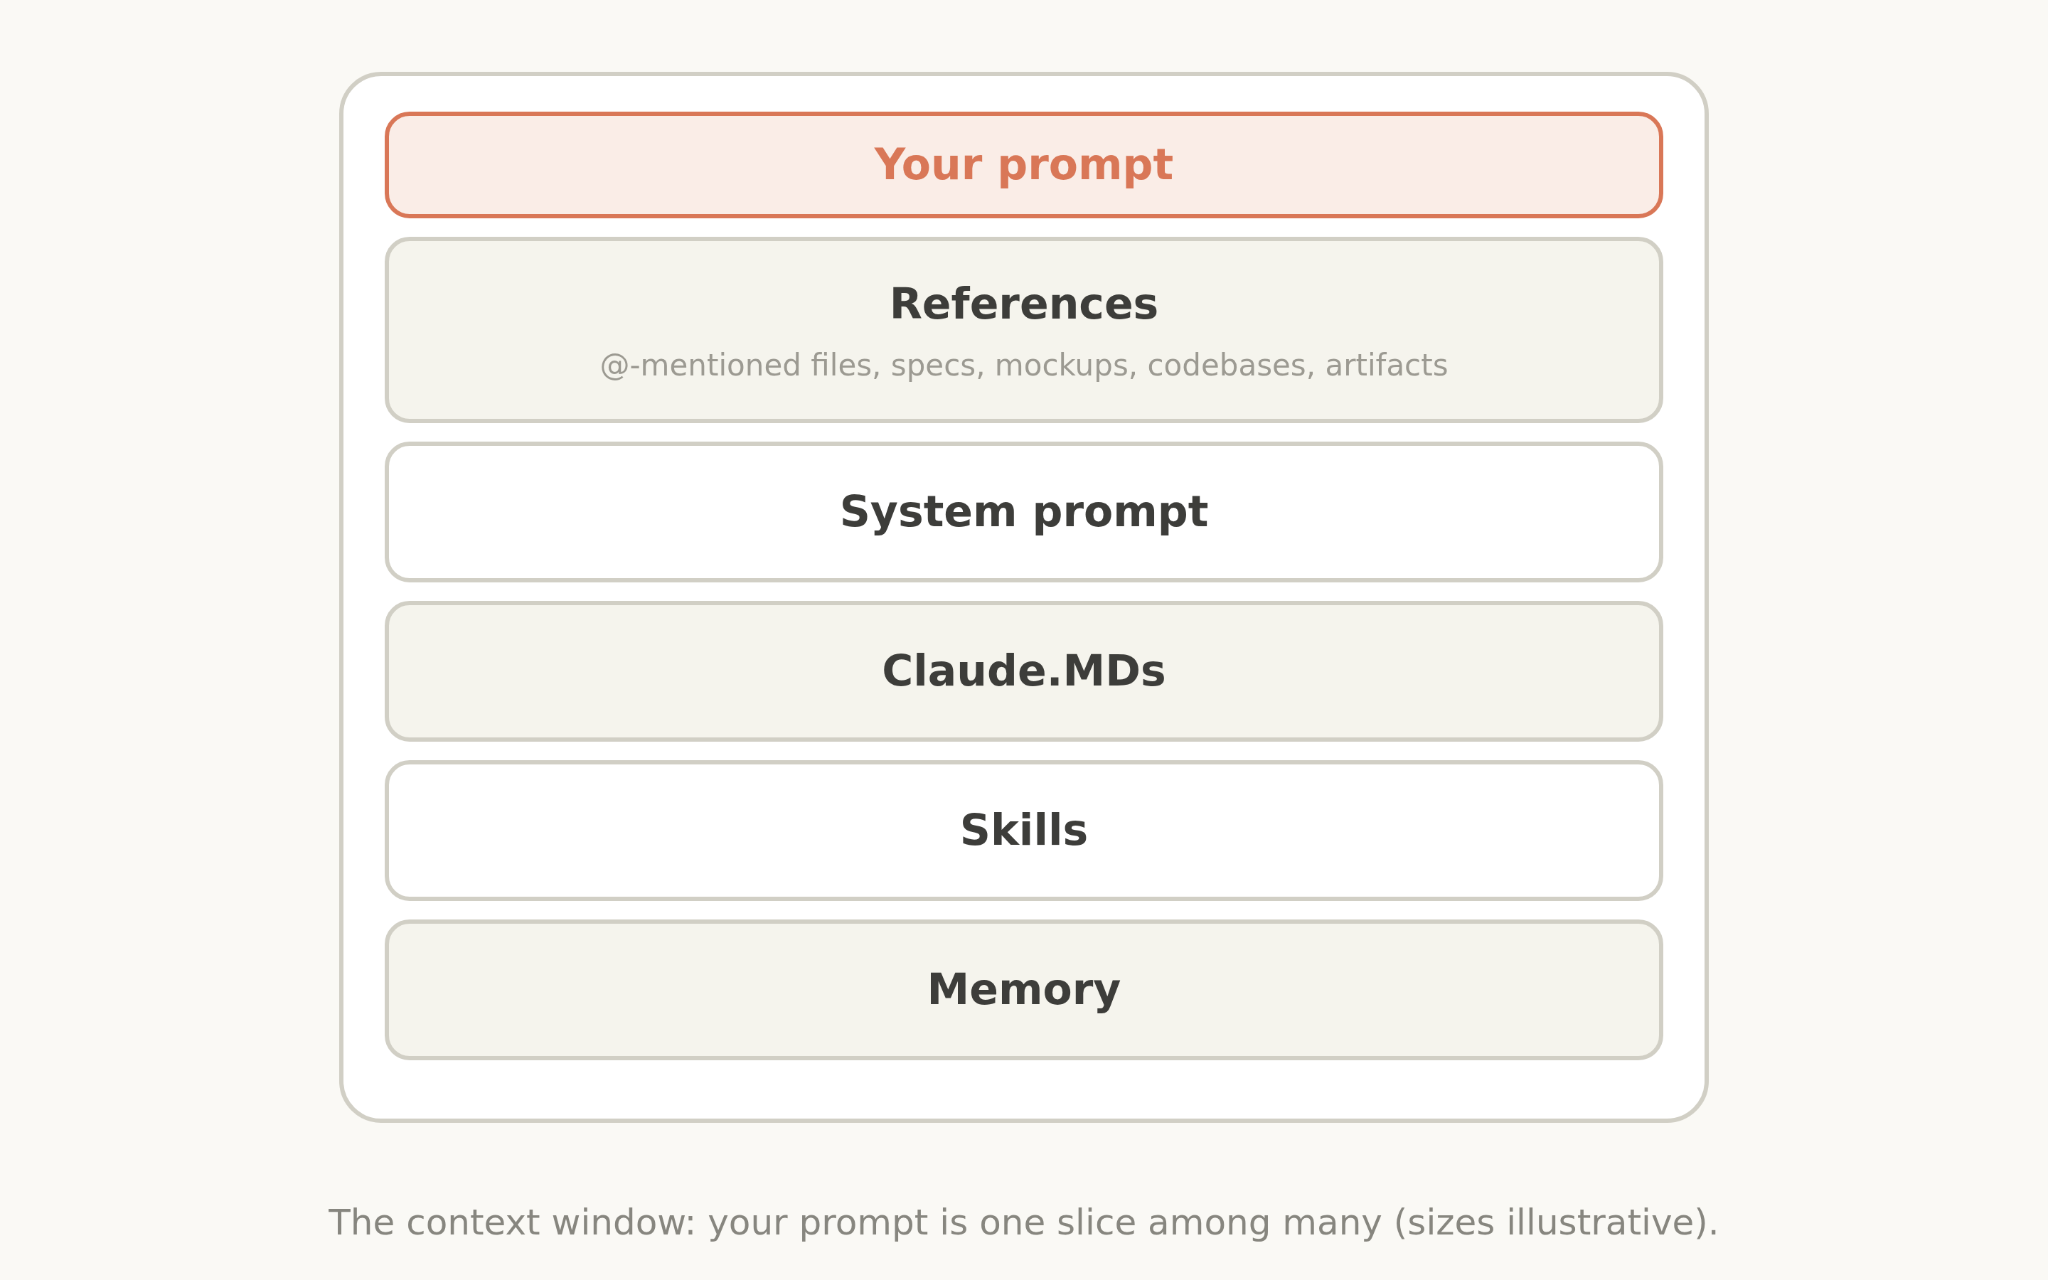
앤트로픽은 2025년 9월 29일 엔지니어링 블로그에서 이 개념을 먼저 정리하며, 짧게 쓸 이유를 모델 구조에서 찾았습니다. 트랜스포머는 토큰 n개 사이의 관계를 n의 제곱만큼 계산하기 때문에 창이 길어질수록 각 관계에 쓸 주의가 얇아지고, 모델이 학습한 데이터에는 짧은 글이 더 많았다는 설명입니다. 그래서 원하는 결과를 낼 가능성이 가장 높은 최소한의 토큰 묶음을 찾는 것이 원칙이 됐습니다. 이번 글은 그 원칙을 Claude 5 세대에 맞춰 다시 적용한 결과입니다.
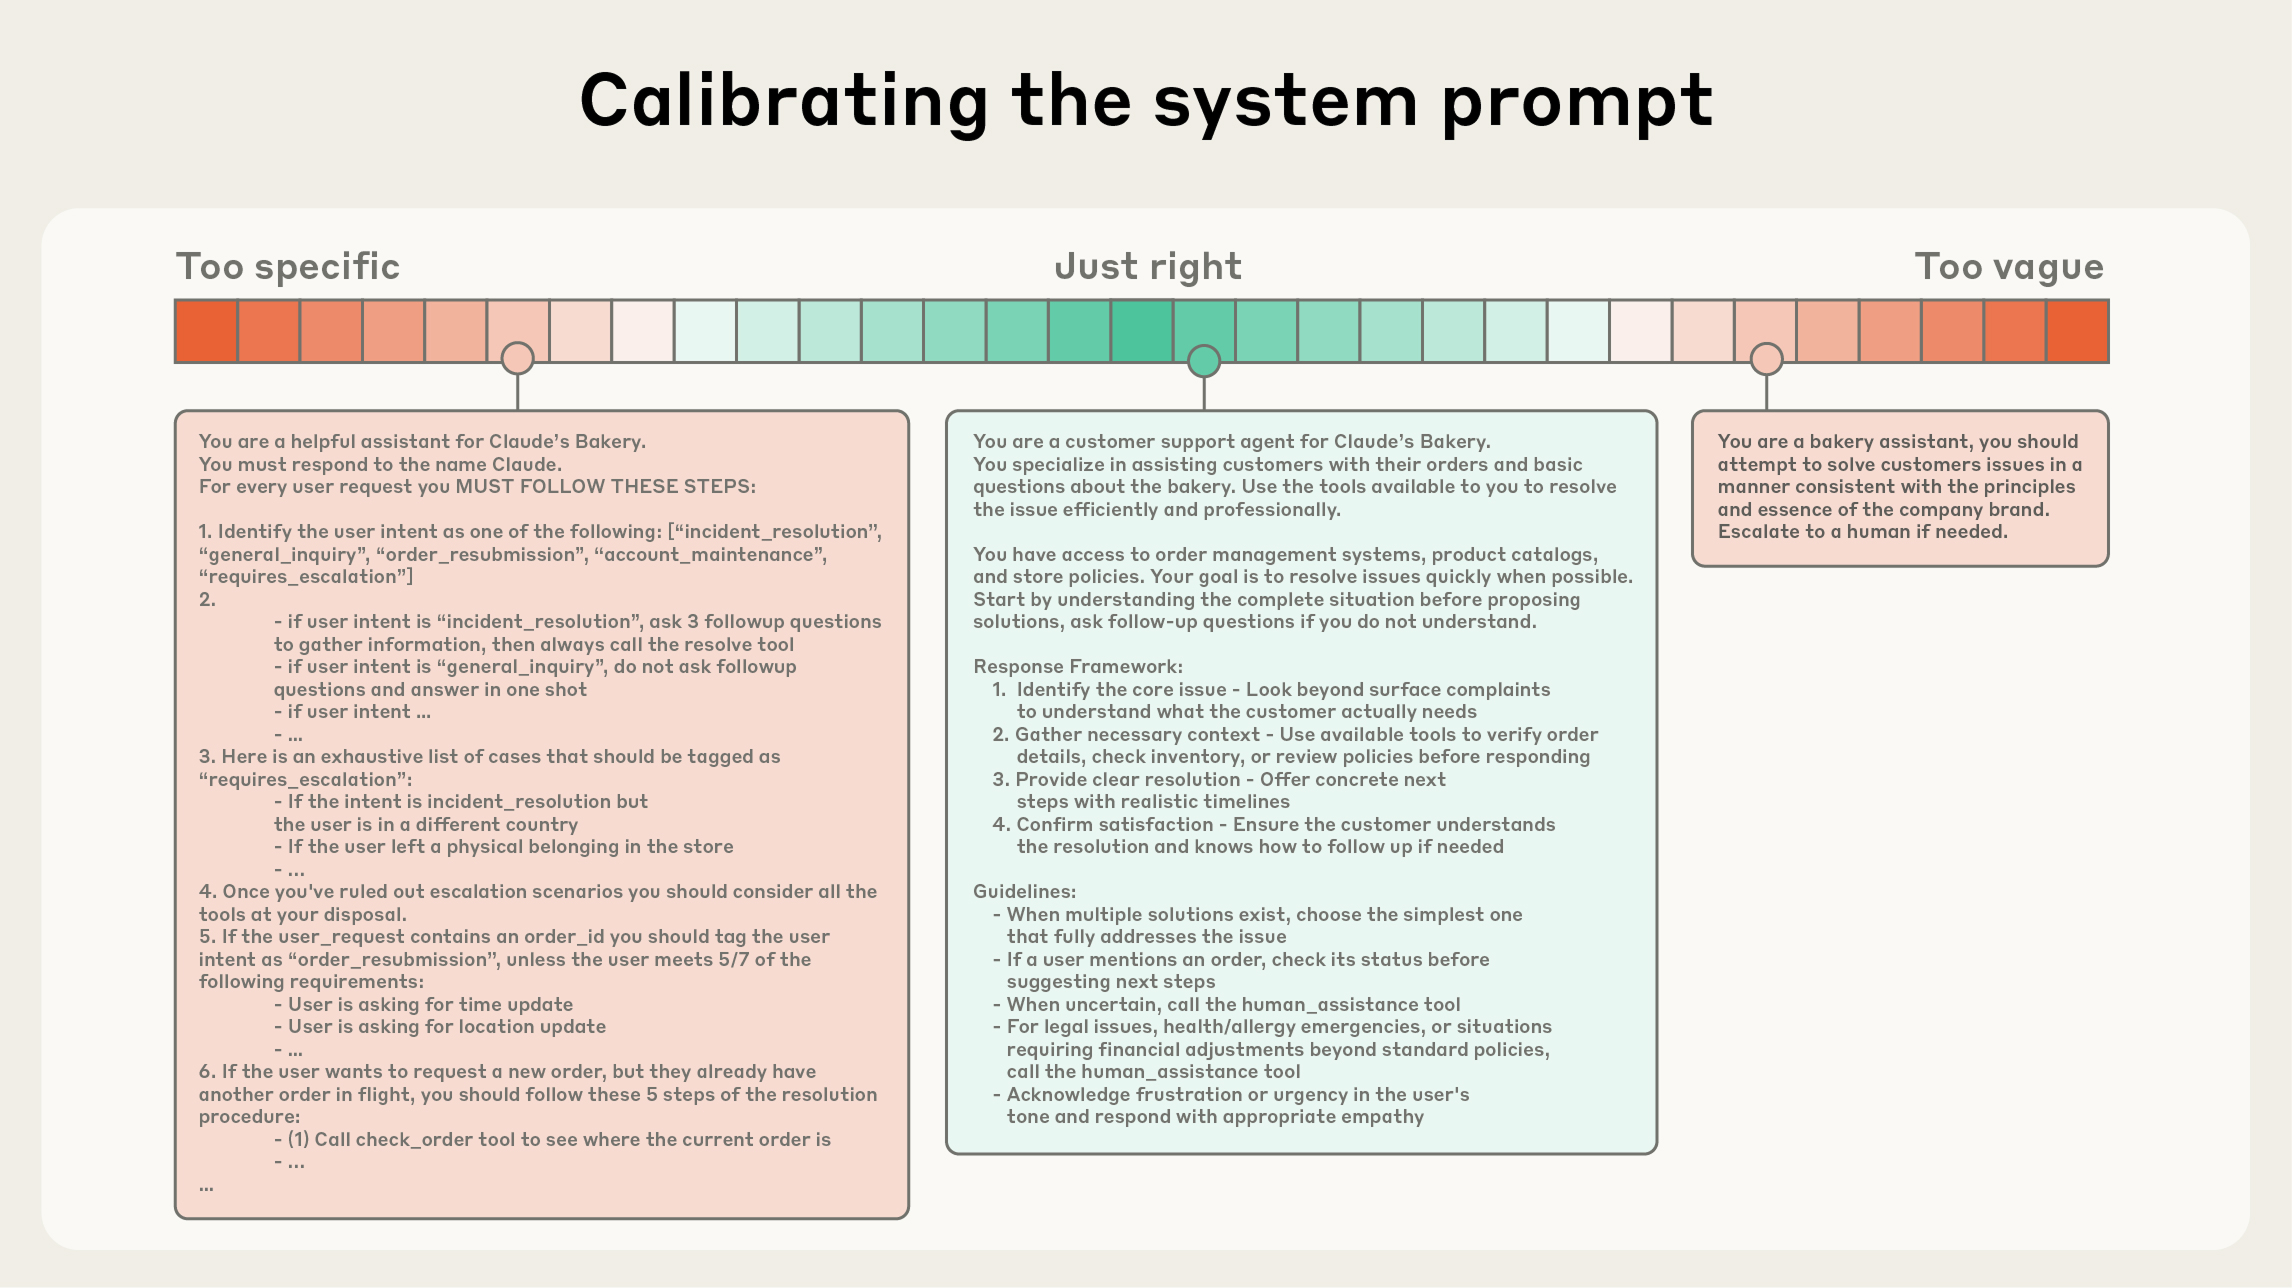
출발점은 과잉 제약이었습니다. 앤트로픽이 사내 Claude Code 사용 기록을 읽어 보니, 한 요청 안에 「문서는 적절히 남겨라」와 「주석을 달지 마라」가 함께 들어 있었습니다. 시스템 프롬프트와 스킬, 사용자 요청이 서로 부딪힌 겁니다. Claude는 대체로 사용자 의도를 읽어 맞는 답에 닿지만, 그 전에 겹치고 어긋난 지시를 더 신중하게 따져야 했습니다.
이런 제약은 예전 모델에서 파일을 지우는 것 같은 최악의 사고를 막으려고 필요했습니다. 앤트로픽은 이제 상당수를 지우고 모델이 주변 맥락과 판단을 쓰게 둬도 된다고 결론 내렸습니다. Claude Code에 메모리와 아티팩트, 스킬이 생기면서 예전에는 CLAUDE.md 하나가 맡던 기억과 정보, 지침을 나눠 실을 곳이 늘어난 것도 이유로 들었습니다.
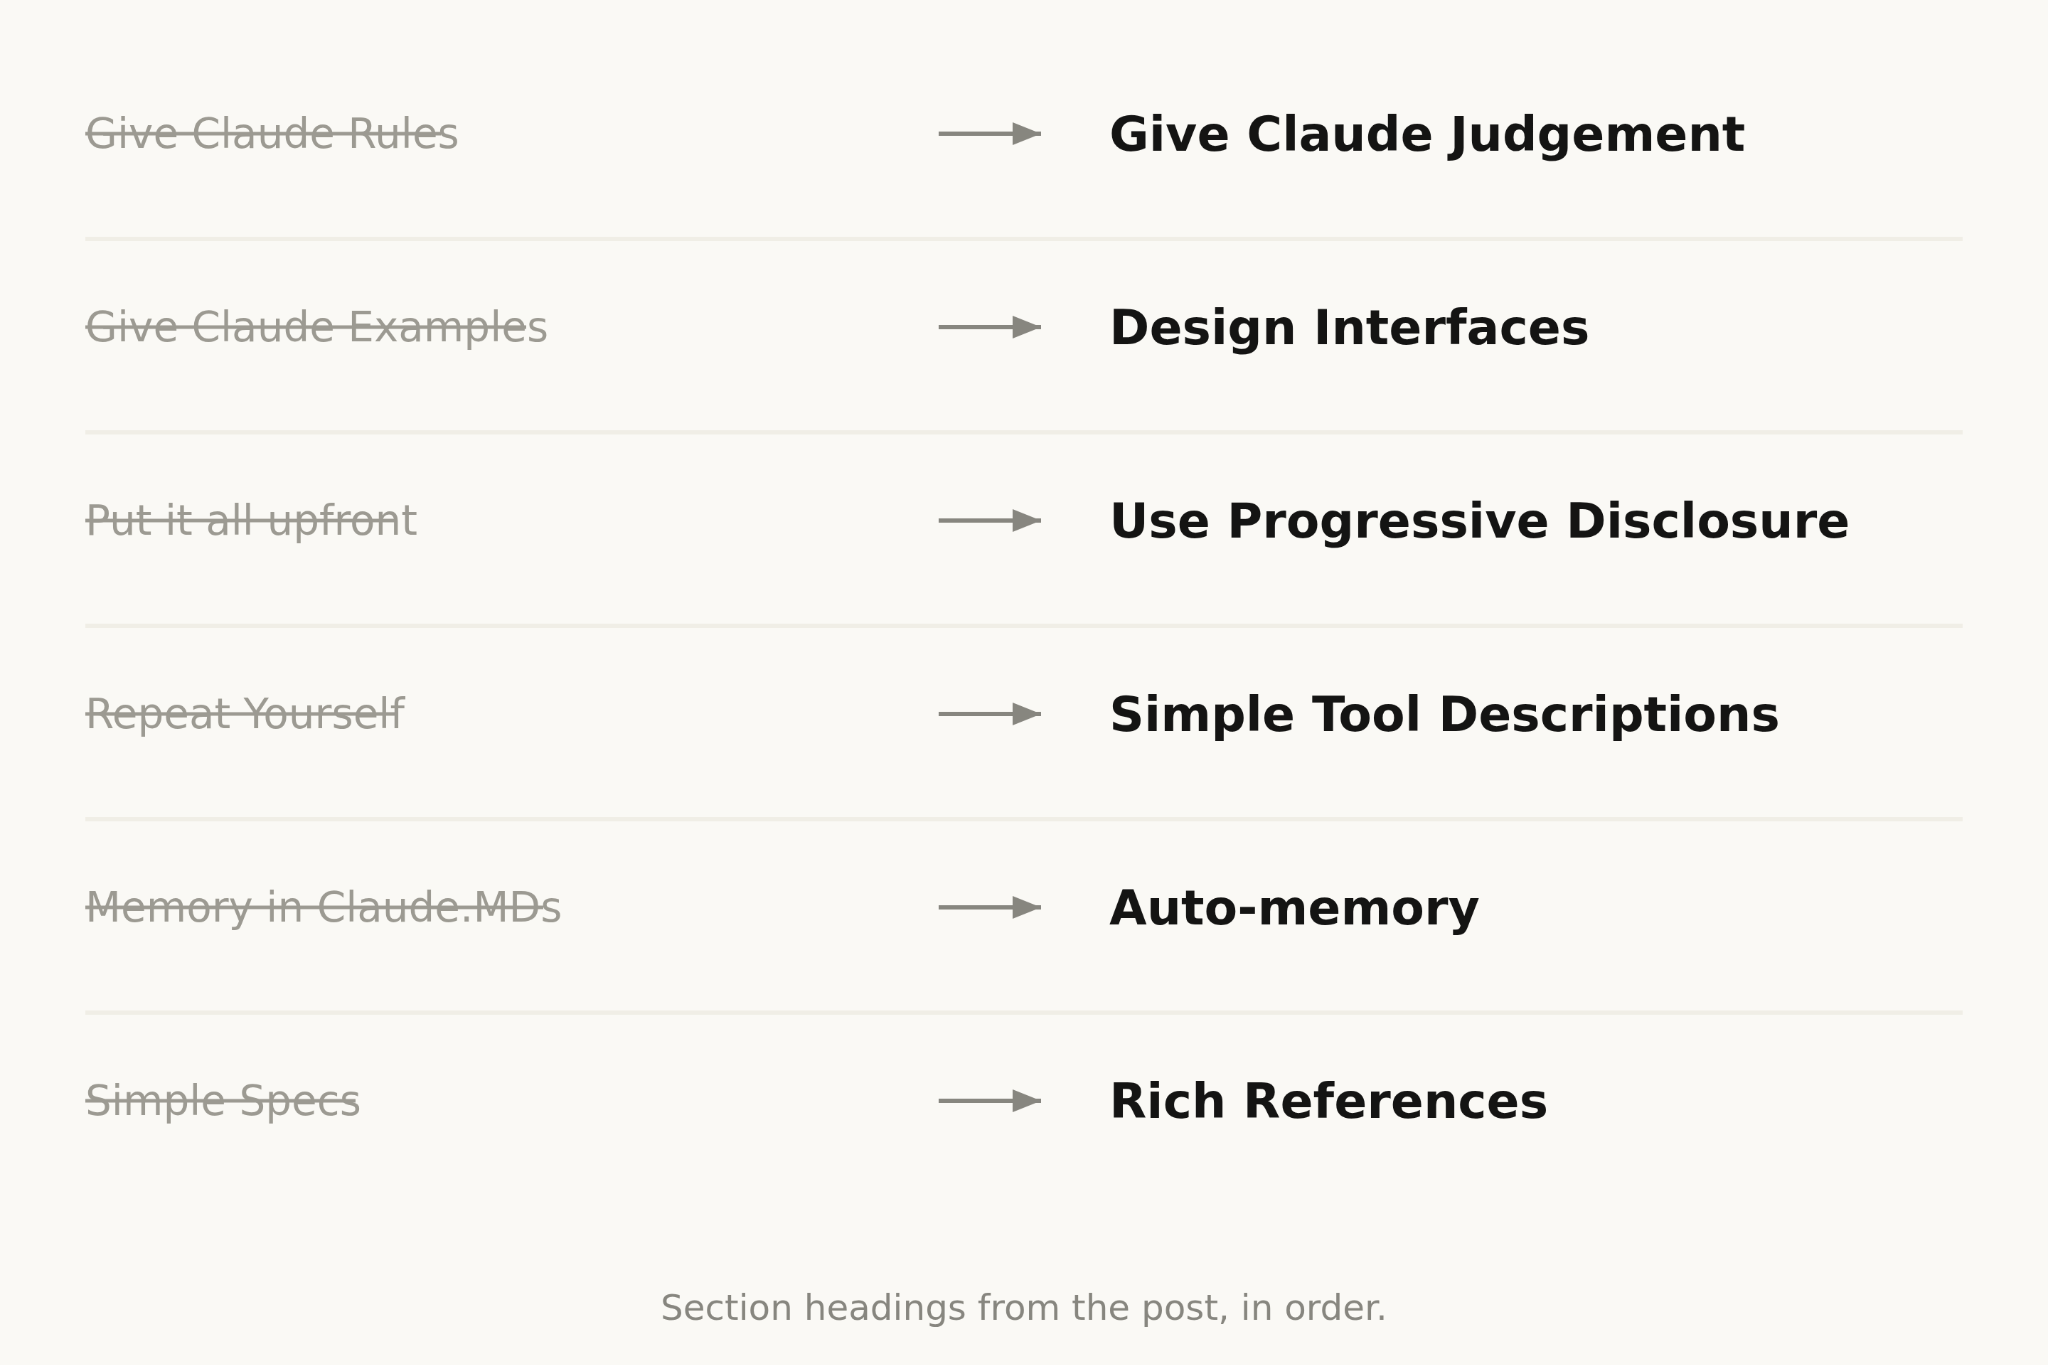
| 예전 | 지금 | 달라진 점 |
|---|---|---|
| 규칙을 준다 | 판단을 맡긴다 | 주석 금지 문단 대신 「주변 코드처럼 쓰라」는 한 줄 |
| 예시를 준다 | 인터페이스를 설계한다 | 예시가 탐색 범위를 좁혀, 매개변수를 표현력 있게 설계 |
| 앞에 다 넣는다 | 점진적으로 공개한다 | 코드 리뷰와 검증을 스킬로, 일부 도구는 지연 로딩 |
| 되풀이해 적는다 | 도구 설명을 단순하게 둔다 | 같은 지시는 도구 설명 한 곳에만 |
| CLAUDE.md에 기억을 적는다 | 자동 메모리 | Claude가 관련된 기억을 스스로 저장 |
| 단순한 명세를 쓴다 | 풍부한 참조를 준다 | HTML 아티팩트, 테스트 모음, 채점 기준표 |
표 맨 윗줄의 예가 가장 구체적입니다. 옛 시스템 프롬프트에는 코드에 원칙적으로 주석을 달지 말고, 여러 문단짜리 독스트링이나 여러 줄 주석 블록은 절대 쓰지 말며, 사용자가 요청하지 않으면 계획이나 분석 문서도 만들지 말라고 적혀 있었습니다. 일부 요청에서는 이 지침이 틀렸지만, 지침 없이 두면 예전 모델이 주석을 엉뚱하게 다는 경우가 많아 그 대가를 감수했다고 합니다. 새 시스템 프롬프트는 주변 코드처럼 읽히는 코드를 쓰고 주석 밀도와 이름 짓기, 관용구를 주변에 맞추라는 한 줄입니다.
예시를 버린 이유도 비슷합니다. 도구를 잘 쓰게 하는 1번 규칙은 예시를 주는 것이었는데, 최신 모델에서는 예시가 오히려 탐색을 그 근처로 묶는다는 것을 확인했다고 적었습니다. 할 일 목록 도구는 상태값을 pending, in_progress, completed 세 가지로 열거해 두기만 해도 쓰는 법이 드러나고, 진행 중인 항목은 하나만 두라는 한 줄이 원하는 동작을 정합니다. 예시 여러 개를 붙이는 수고가 매개변수 이름과 값의 설계로 옮겨 간 겁니다.
앞에 다 넣지 않는 방식은 도구에도 적용됩니다. 일부 도구는 지연 로딩으로 바꿔, 에이전트가 ToolSearch로 정의를 찾기 전까지 컨텍스트를 차지하지 않게 했습니다. 그만큼 Task 도구처럼 더 많은 도구를 달 수 있게 됐습니다. CLAUDE.md와 스킬 문서도 모든 관행을 한 파일에 모으는 대신, 필요할 때 열리는 파일 나무로 나누라고 권했습니다.
되풀이와 메모리도 정리했습니다. 예전 모델은 같은 지시를 여러 번 넣어야 했고 컨텍스트 앞쪽보다 끝쪽의 지시를 더 잘 따르기도 해서, 시스템 프롬프트 본문과 도구 설명에 같은 도구 이야기를 겹쳐 적었습니다. 지금은 겹친 부분을 지우고 도구 사용법을 도구 설명에만 둡니다. 기억할 내용은 예전에 # 단축키로 사용자가 CLAUDE.md에 직접 적었는데, 지금은 Claude가 작업과 사용자에 관련된 기억을 스스로 저장합니다.
참조는 더 풍부해졌습니다. 계획 모드는 마크다운 계획서에 크게 기대 왔지만, 이제는 아티팩트 기능으로 만든 HTML 문서를 참조로 쓸 수 있습니다. 촘촘한 테스트 모음이나 다른 저장소의 함수 하나가 명세가 되기도 합니다. 좋은 API 설계가 무엇인지 적은 채점 기준표를 주고 검증 에이전트가 그 기준으로 확인하게 하면, 말로 설명하기 어려운 취향까지 점검할 수 있다고 적었습니다.
맥락을 조립할 때
시스템 프롬프트
CLAUDE.md
스킬
참조
CLAUDE.md에 남길 것의 예로는 「타입을 파일 하나에 몰아 두고 다른 곳에는 두지 않는다」가 나왔습니다. 저장소를 열어 보면 알 수 있는 뻔한 사실은 적지 않고, 검증 방법이 여러 개면 검증 스킬로 빼서 CLAUDE.md에서는 그 스킬을 가리키기만 합니다. 스킬에는 나와 팀, 제품에만 해당하는 의견과 지식을 담고, 참조는 가능하면 코드로 된 파일을 고릅니다. 디자인을 말로 풀거나 스크린샷을 붙이는 것보다 HTML 목업 하나가 대체로 더 나은 결과를 낸다는 설명입니다.
80%라는 숫자에는 조건이 붙어 있습니다. 앤트로픽이 이름을 든 모델은 Opus 5와 Fable 5이고, 손실이 없었다고 밝힌 범위는 자사 코딩 평가입니다. 같은 날 나온 Opus 5는 Max 요금제의 새 기본 모델이자 Pro에서 쓸 수 있는 가장 강한 모델이고, Fable 5의 최전선 지능에 절반 가격으로 다가간다고 앤트로픽은 소개했습니다.
6월 30일 나온 Sonnet 5는 이 글에 등장하지 않습니다. 앤트로픽은 Sonnet 5를 Opus 4.8에 가까운 성능을 더 싼 값에 내는 모델로 소개했고, Free와 Pro 요금제의 기본 모델이 바로 Sonnet 5입니다. 기본 설정 그대로 쓰는 사용자가 가장 많이 만나는 모델에서 지침을 얼마나 덜어도 되는지는 이 글로 알 수 없습니다.
설정에 따라 비용도 달라집니다. Claude Code 팀은 7월 초 같은 과제를 low와 high 노력 단계로 맡기면 토큰이 약 400개와 2,800개로 7배 차이가 난다는 예를 들었고, 이 설명은 모델과 노력 단계를 고르는 법을 다룬 글에 있습니다. 비용 때문에 작업마다 다른 모델과 노력 단계를 섞어 쓰는 팀이라면, 최신 세대 기준의 조언이 모든 작업에 그대로 통하지 않을 수 있습니다.
규칙 파일의 길이에 한도를 둔 회사도 있습니다. 오픈AI 코덱스는 저장소의 규칙 파일 AGENTS.md를 기본 32KiB까지만 읽고, 한글로는 1만 900자 남짓입니다. 이 한도와 서울 밋업에서 나온 활용법은 코덱스 활용법 다섯 가지를 문서와 대조한 글에 정리했습니다. 한 회사는 읽는 양에 상한을 걸었고, 다른 회사는 쓰는 양을 줄이라고 권한 겁니다.
길게 써도 되는 경우와 줄여야 하는 경우를 가르는 기준도 이미 나와 있습니다. 판단을 요구하는 규칙을 길게 나열하면 모델이 부딪히는 지시를 정리하느라 헤매지만, 대조만 하면 되는 판정 기준과 형식은 길어져도 부담이 덜합니다. 7월 11일 공개된 학생용 빌드 브리프가 그런 예였고, 이 문서는 판정 기준과 형식으로 채운 명세를 다룬 글에서 다뤘습니다. 이번 글이 지운 80%는 대부분 앞쪽, 곧 예전 모델의 약점을 막으려던 규칙이었습니다.
앤트로픽이 손실이 없다고 말할 수 있었던 건 자사 코딩 평가 세트가 있어서였습니다. 대부분의 팀에는 그런 세트가 없고, 평가 없이 규칙부터 걷어내면 결과가 나빠져도 어느 규칙 때문인지 가릴 수 없습니다. 사내 작업 몇 개를 골라 지금 결과를 기록해 두면, 지운 뒤의 결과와 나란히 놓을 기준이 생깁니다.
규칙 파일의 수명도 달라졌습니다. 모델이 한 세대 올라갈 때마다 이전 모델의 약점을 막으려고 세운 규칙부터 비용이 되니, CLAUDE.md와 스킬은 한 번 잘 써 두고 쌓아 가는 문서에서 모델을 바꿀 때마다 다시 재는 대상이 됐습니다. 시히파르는 글 끝에서 더 앞선 모델을 다루는 방법은 Fable 5 사용법을 정리한 현장 안내서를 보라고 적었습니다.
읽어 주셔서 고맙습니다.
초이 드림