
어텐션
attention · 주의 기전
입력의 어느 부분을 얼마나 참고할지 정하는 트랜스포머의 계산 구조입니다. 길이가 늘수록 비용이 빠르게 커져서, 긴 컨텍스트 처리 비용의 대부분이 여기서 나옵니다.
‘어텐션’ 이 나오는 글8
GLM이 자기를 돌릴 시스템을 짰다, 13일 만에 처리량 3.22배
첫 구동 13일 뒤 처리량은 처음의 3.22배가 됐습니다. 파이썬 GIL 하나 때문에 20% 넘게 벌어지던 성능 차이를 1% 아래로 줄였고, 에이전트가 찾은 정밀도 문제의 수정은 오픈소스 라이브러리 Flash Linear Attention에 병합됐습니다.
100만 토큰을 0.9GB에, 딥시크 V4.1 논문이 KV 캐시를 줄인 방법
딥시크 V4.1-Flash 보고서가 9월 17일 arXiv에 올라왔습니다. 전역 KV 캐시는 토큰당 890바이트로 V4-Flash의 4분의 1, SSD에 두는 캐시는 8분의 1이고, 문맥을 4K에서 1M으로 늘려도 토큰 하나 생성 계산은 4분의 1만 늘었습니다.

튜링상 야오 이름 올린 바이트댄스 논문, '읽으며 배우는' 기억을 다시 짰습니다
8월 27일 arXiv에 올라온 Falcon은 선형 어텐션의 기억 갱신을 작은 예측기의 실시간 학습으로 보고 규칙 여섯 개를 내놨습니다. 32자리까지 배운 덧셈을 33~48자리로 늘린 시험에서 87.2%로 트랜스포머(65.8%)를 앞섰습니다.

벤치마크 1위, 총점 4위… 모티프 이의 제기에 독파모 세부 점수가 공개됐습니다
과기정통부가 8월 27일 공개한 독파모 2차 세부 점수에서 모티프는 벤치마크 1위(24.6점), 총점 4위(65.8점)였습니다. 전문 사용자와 국민 두 평가단 모두 모티프에 5점 만점 평균 2.8점대를 줬고, 다른 세 팀은 3.6~3.9점이었습니다.

같은 날 같은 값에 나온 Qwen과 GLM, 알리바바만 사업 조건을 붙였습니다
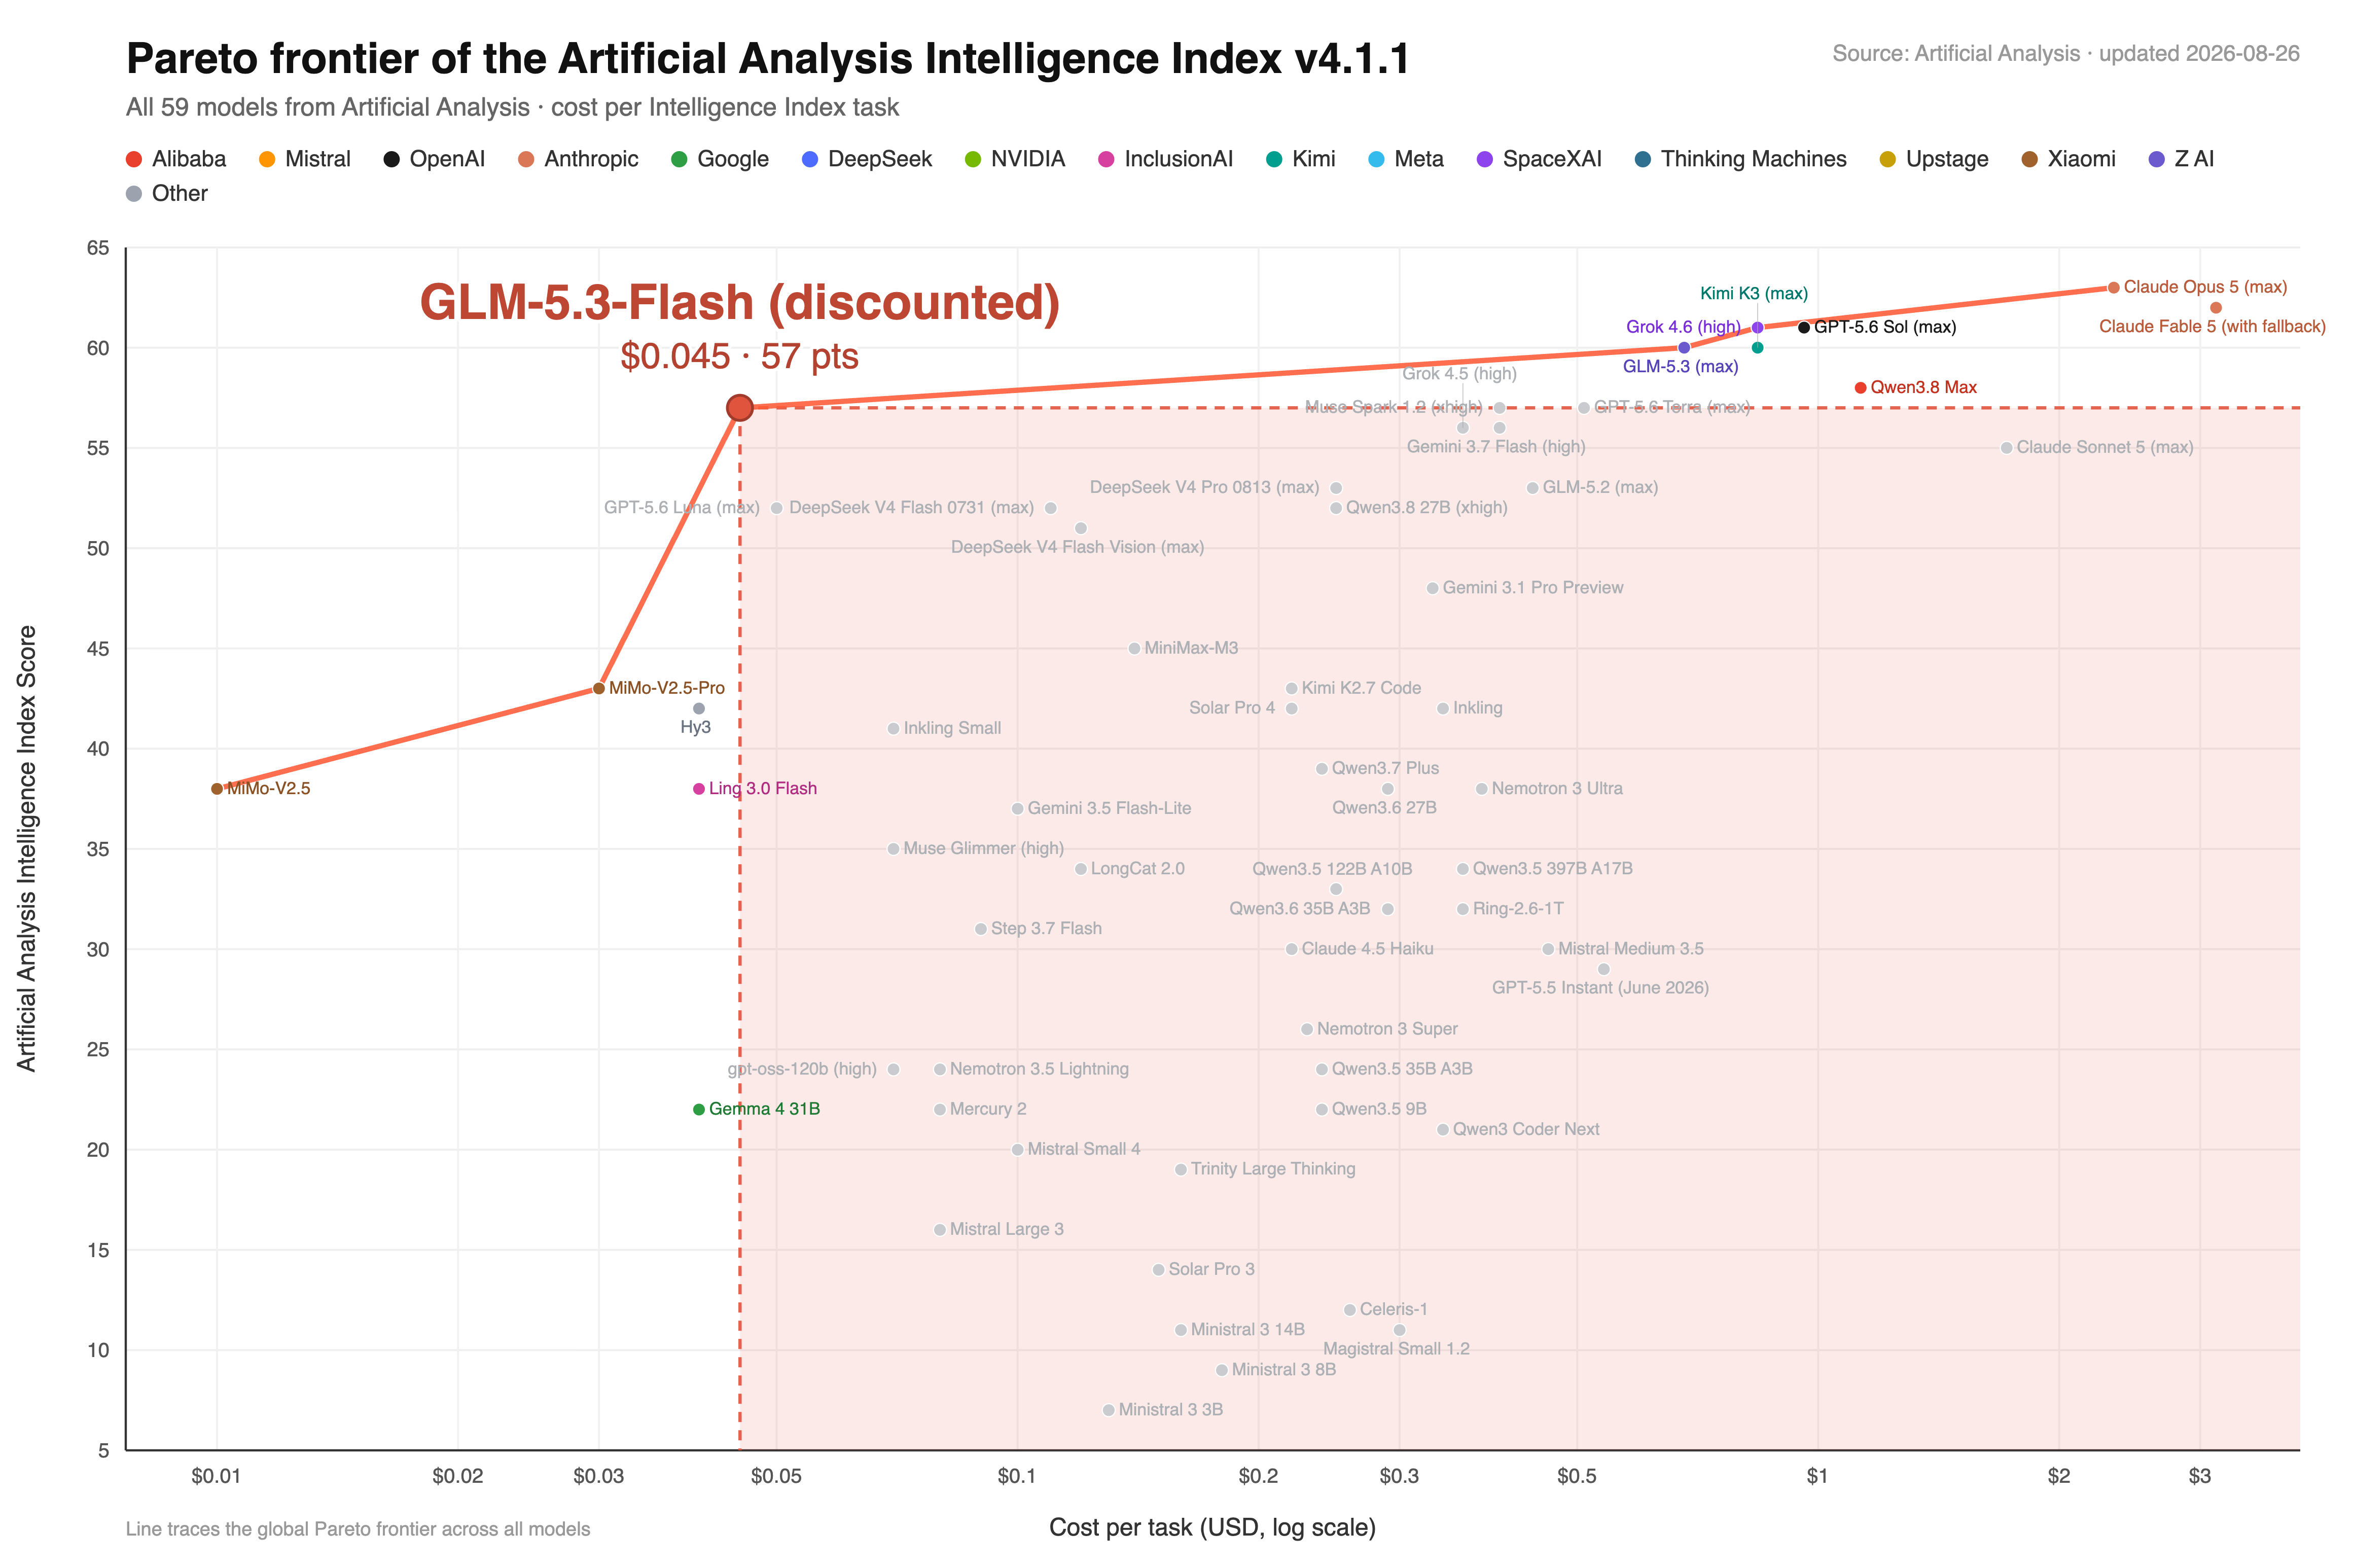
8월 26일 같은 날 공개된 Qwen3.8-Flash-Next와 GLM-5.3-Flash는 설계와 API 가격까지 닮았지만 라이선스가 갈렸습니다. GLM은 조건 없는 MIT로 풀렸고, Qwen에는 모델 API나 AI 도구 사업이면 별도 계약을 받으라는 조항이 붙었습니다.
문샷이 같은 밤에 모델과 커널과 통신 라이브러리를 통째로 풀었습니다
7월 27일 문샷AI가 Kimi K3 가중치 파일 96개(1.56TB)와 기술 보고서, FlashKDA·MoonEP·AgentENV를 같은 날 MIT로 공개했습니다. 발표 때 주장이던 숫자가 파일에서 확인됐고, MoonEP 지원 목록에는 중국산 가속기 진우 PPU가 올라 있습니다.

함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 선형 어텐션입력이 길어져도 계산량이 제곱으로 늘지 않도록 고친 어텐션 계열입니다. 전체 어텐션 층과 섞어 쓰는 하이브리드 구성이 표준이 됐고, Qwen3.8은 층 대부분을 Gated DeltaNet으로 두고 16개 층만 전체 어텐션으로 남겨 멀리 떨어진 정보를 다시 연결합니다.
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 허깅페이스모델 가중치와 데이터셋을 올리고 내려받는 공개 저장소입니다. 오픈웨이트 공개는 사실상 이곳에 파일이 올라온 시점으로 세고, 라이선스 표기도 여기서 확인합니다. 오픈AI 내부 모델이 샌드박스를 나와 코드 실행까지 간 사건의 무대도 이곳의 프로덕션 환경이었습니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.