
벤치마크
benchmark
모델 실력을 재는 표준 시험입니다. 수학(GSM8K·MATH), 코딩(HumanEval·SWE-bench) 같은 문제집 점수로 모델을 비교합니다.
‘벤치마크’ 이 나오는 글12
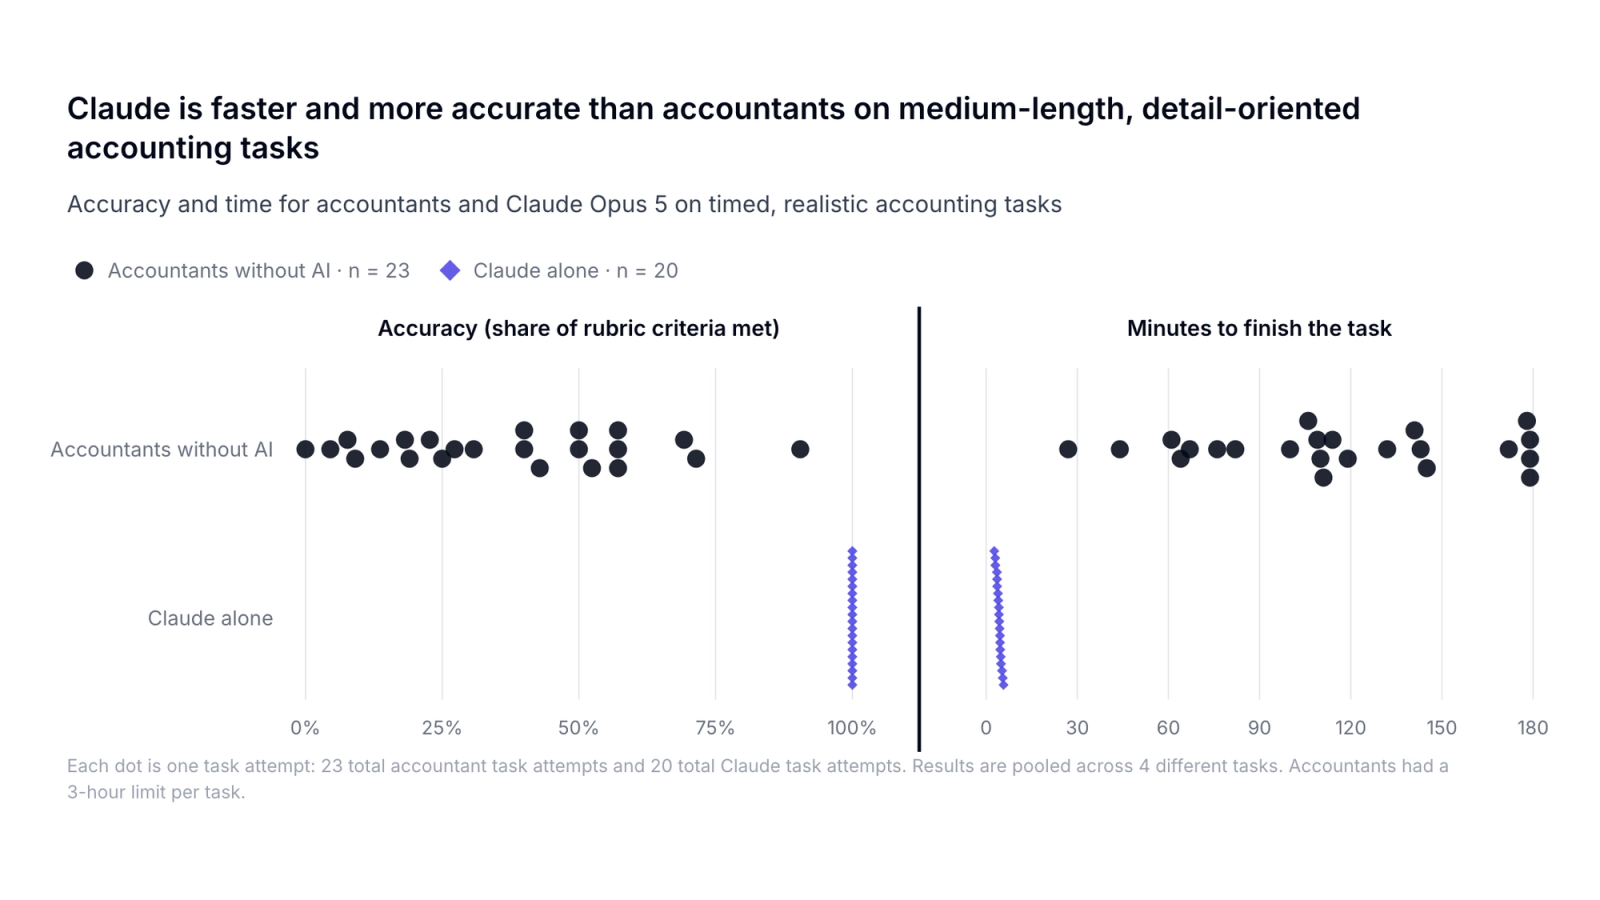
월말 결산 네 과제, 회계사 평균 37%… Claude는 20번 모두 만점
머코어가 한국 시각 10월 2일 새벽에 공개한 실험에서 Claude Opus 5는 간소화한 월말 결산 과제 20번을 모두 만점으로 10분 안에 풀었습니다. AI 없이 푼 회계사 12명의 평균은 약 37%였고, 함께 푼 24건은 약 15배 오래 걸렸습니다.
Jev보다 싸고 이미지도 읽는 퍼플렉시티 결정 모델, 종합 1위의 셈법
퍼플렉시티가 10월 2일 결정 모델 pplx-decider-v1-27b의 가중치를 풀고 입력 100만 토큰당 0.04달러 API를 열었습니다. 종합 정확도 85.71%로 Jev를 앞섰지만 시험 11개 단순 평균은 Jev가 0.21%포인트 높았습니다.
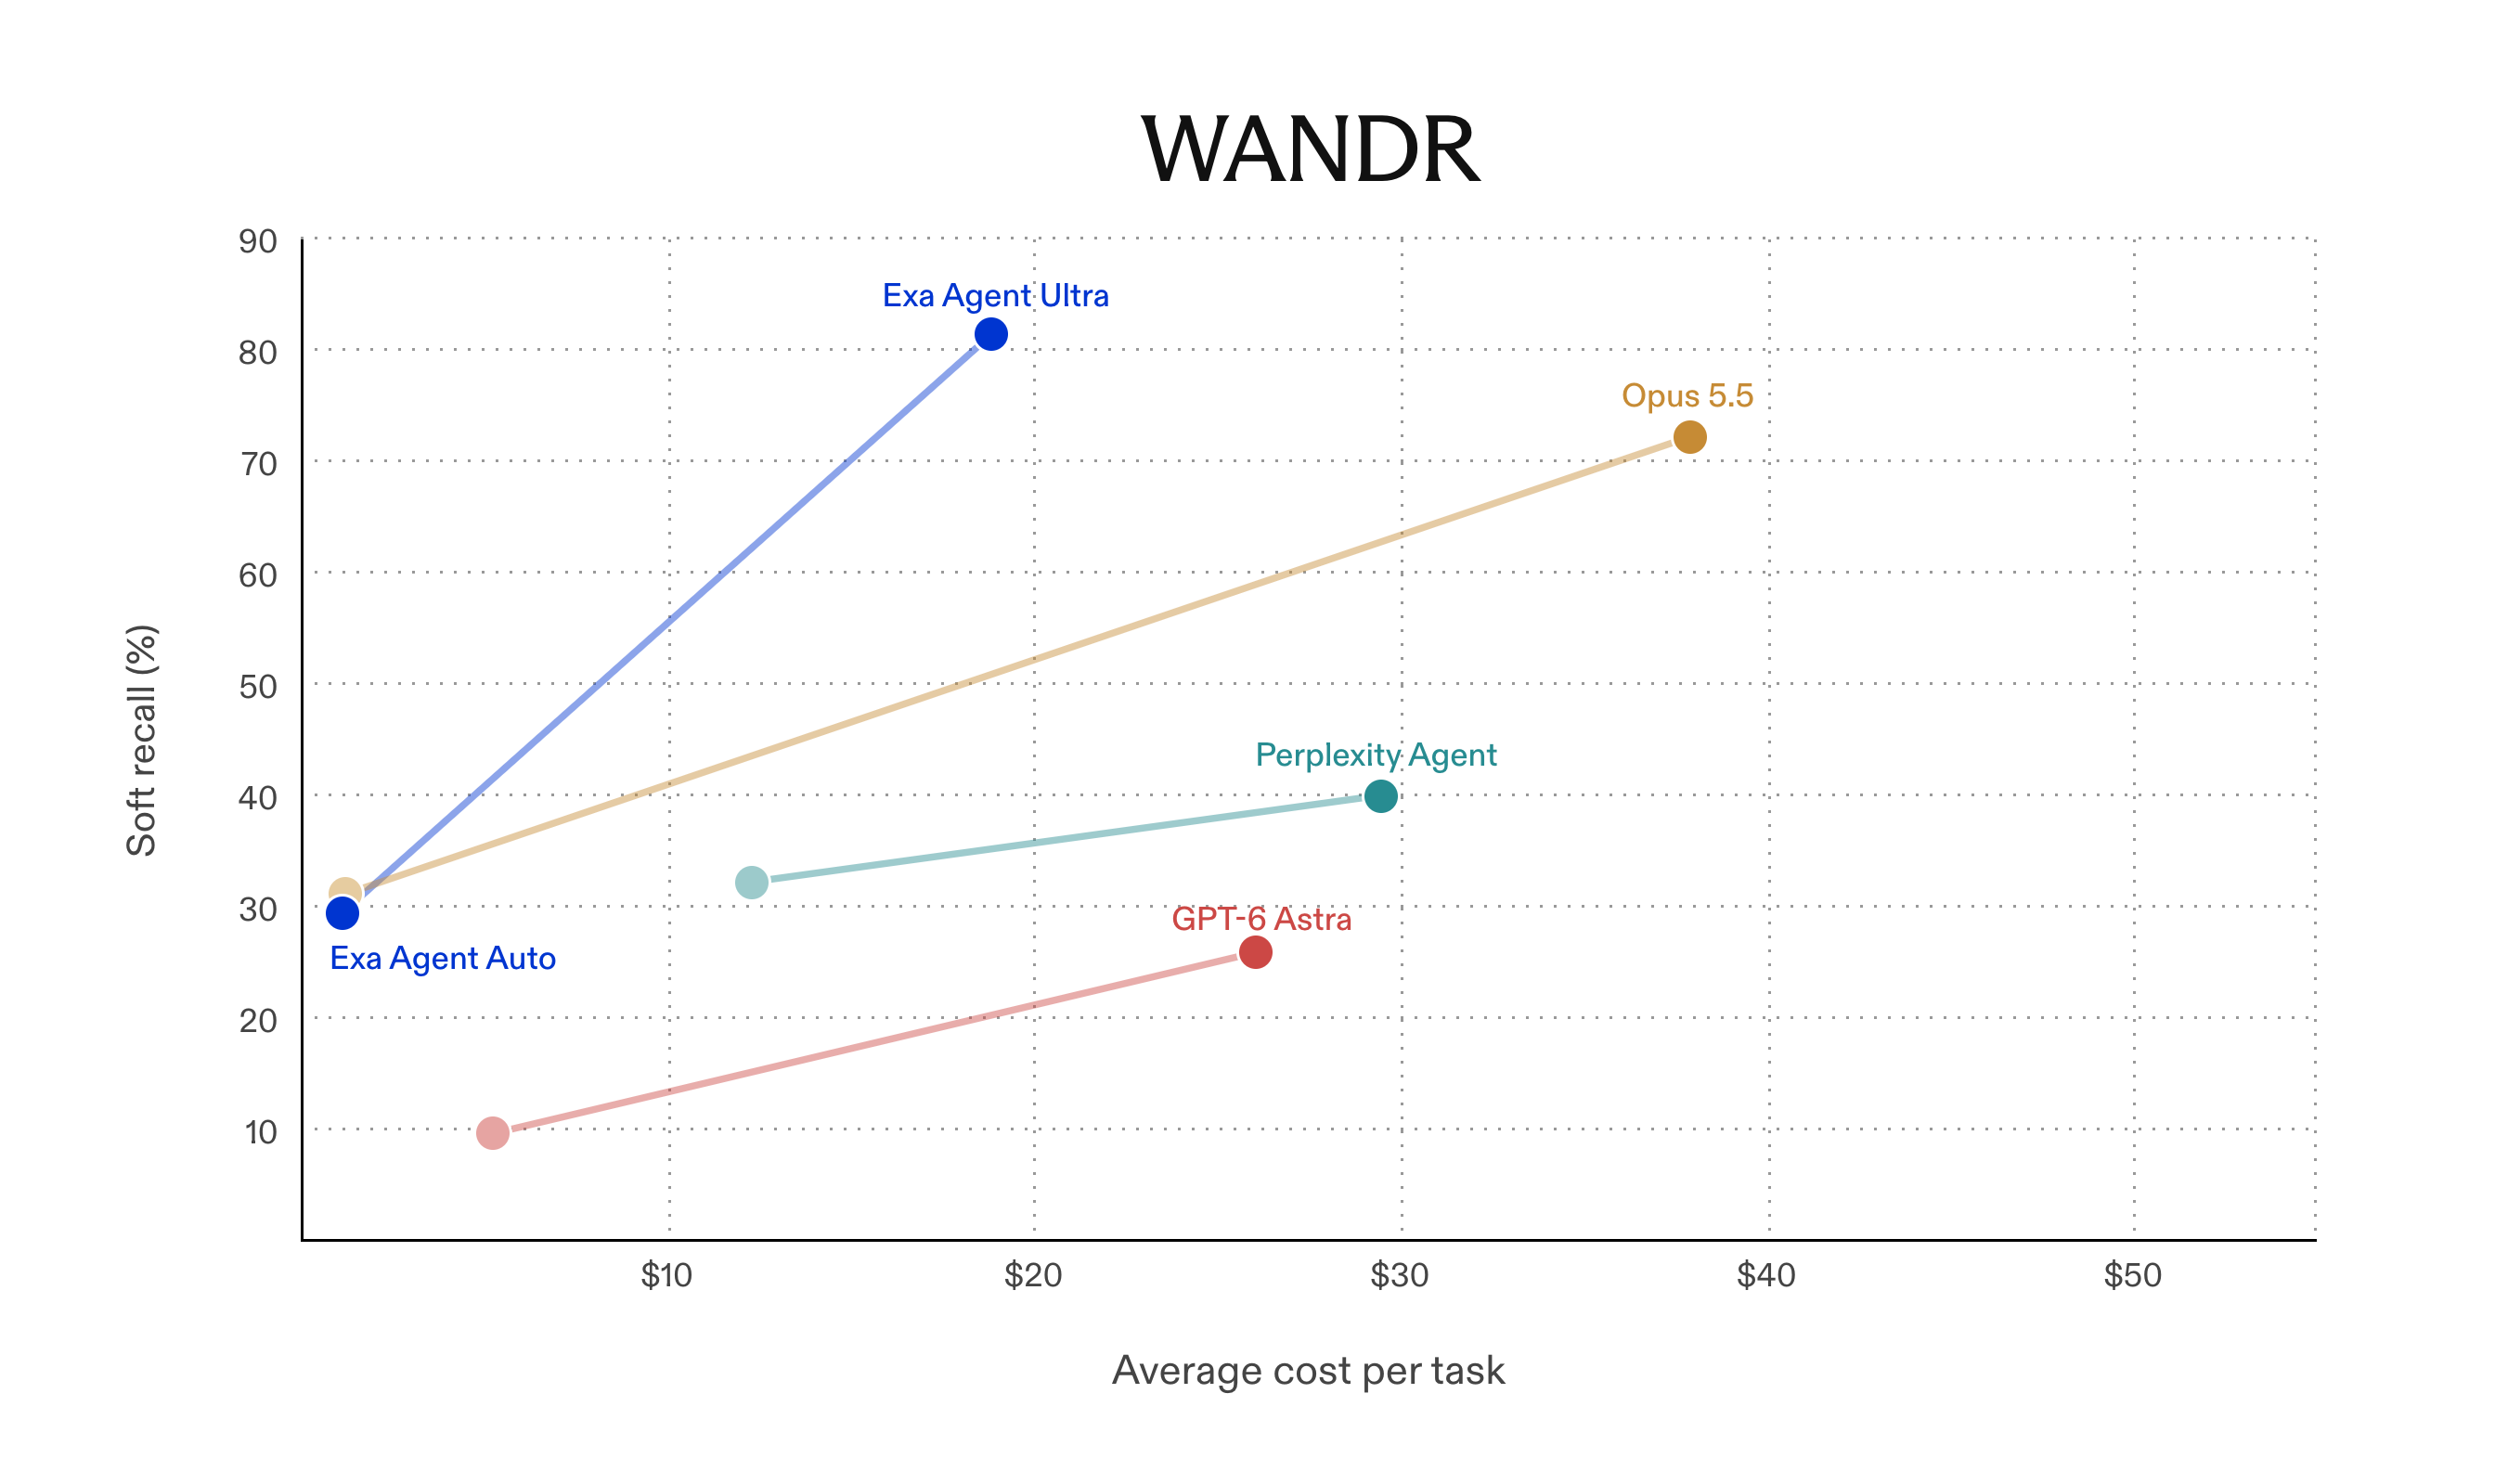
Exa Agent Ultra가 WANDR에서 81.4%, 채점은 Exa가 했습니다
Exa가 9월 25일 리서치 에이전트의 최고 노력 단계 Agent Ultra를 공개했습니다. 회사 표에서 WANDR 81.4%로 Opus 5.5의 72.3%를 앞섰고, 수집 도구와 판정 모델을 바꾼 자체 채점 틀에서 나온 숫자입니다.
Claude가 claude.ai를 3배 빠르게, 첫 화면 3.1초가 0.55초로
새로 연 claude.ai에서 입력할 수 있기까지 걸리던 3.1초가 0.55초로 줄었습니다. 앤트로픽은 8월 2주 동안 Claude와 함께 변경 3,000건 넘게 병합했고 고객 장애와 롤백은 없었다고 밝혔습니다. 3배는 13개 측정의 기하평균입니다.
하루 1조 토큰 넘긴 Jev, 알메이다 "공개 벤치마크는 믿지 않습니다"
TypeSafe의 디오고 알메이다가 9월 21일 Latent Space에 나와 Jev의 설계를 2시간 20분 동안 설명했습니다. 공개 6일 만에 하루 1조 토큰을 넘겼다고 밝혔고, 공개 벤치마크는 쓰지 않으며 배포한 모델은 바꾸지 않겠다고 했습니다.
AI가 웹사이트를 쓰는 세 가지 방법, 가장 싼 길은 사이트가 열어야
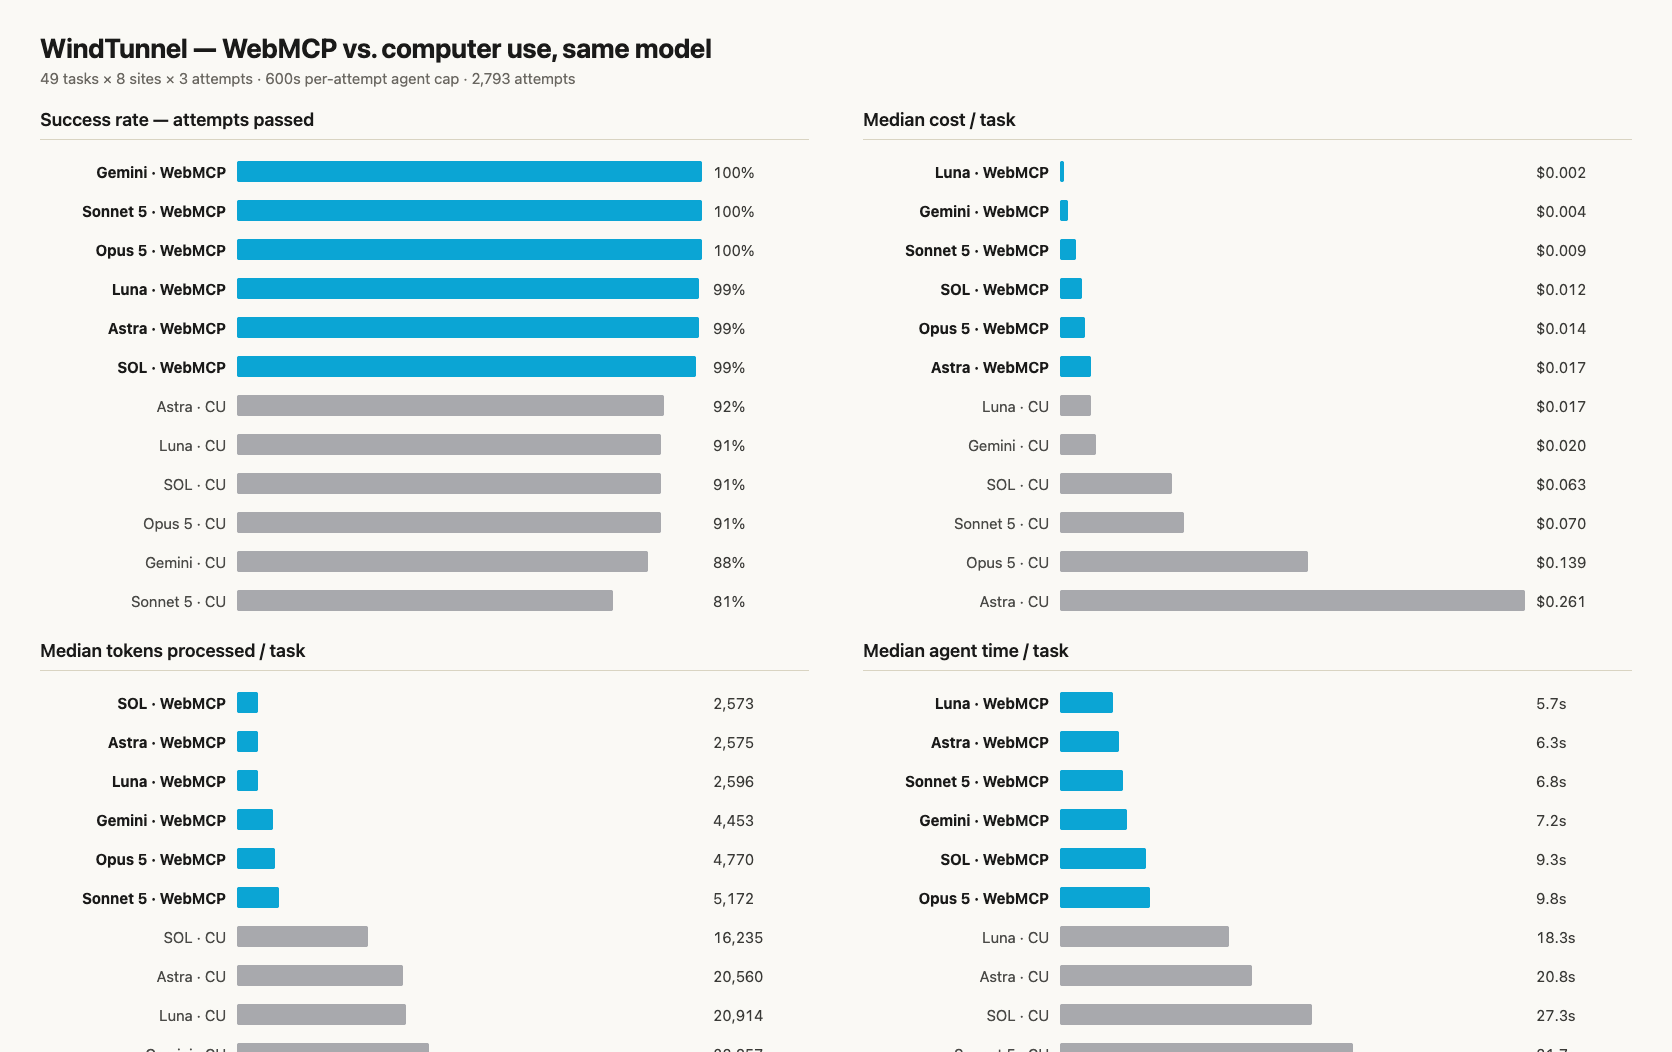
9월 18일 공개된 윈드터널 새 판에서 Jev와 Mercury 2.5 조합이 WebMCP로 49개 작업을 모두 풀었습니다. 같은 모델끼리 비교하면 WebMCP가 컴퓨터 사용보다 7~15배 쌌고, 결제 도구를 추가하기 전까지는 WebMCP도 결제 과제를 모두 실패했습니다.
함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 하네스모델을 감싸 실제 작업을 시키는 바깥 장치입니다. 프롬프트·도구·재시도·검증 규칙이 여기 들어가서, 같은 모델도 하네스에 따라 결과가 크게 다릅니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.