
체크포인트
checkpoint · 학습 중간 저장본 · 실행 상태 저장
중단 후 이어 가거나 이전 상태를 비교하기 위해 특정 시점의 상태를 저장한 것입니다. 모델 학습에서는 가중치·옵티마이저 상태 등을, 에이전트 업무에서는 중간 결과·진행 단계 등을 저장할 수 있습니다. 외부 결제나 발송까지 중복 없이 복구하려면 별도의 멱등성 설계가 필요합니다.
‘체크포인트’ 이 나오는 글6
나노바나나급 Qwen-Image-2.1 공개, 이번엔 상업 이용을 막았습니다
알리바바 Qwen 팀이 9월 20일 생성부 7B의 이미지 생성·편집 모델 Qwen-Image-2.1 가중치를 공개했습니다. 자체 채점표 29개 모델 가운데 7위로 Nano Banana 2.0보다 0.46점 높았고, 상업 이용에는 별도 라이선스가 필요합니다.

앤트로픽이 정렬을 AI에 맡기자 Sonnet 5가 Opus 4.8을 가르쳤습니다
앤트로픽이 8월 28일 Claude에게 정렬 연구를 맡긴 실험 보고서를 공개했습니다. Claude는 사람 연구자 28명의 아이디어를 평균 6.4시간 만에 넘어섰고, 에이전트 한 대의 비용은 시간당 약 4달러였습니다. 지시 따르기 점수는 열 과제 모두에서 내려갔습니다.
문샷이 같은 밤에 모델과 커널과 통신 라이브러리를 통째로 풀었습니다
7월 27일 문샷AI가 Kimi K3 가중치 파일 96개(1.56TB)와 기술 보고서, FlashKDA·MoonEP·AgentENV를 같은 날 MIT로 공개했습니다. 발표 때 주장이던 숫자가 파일에서 확인됐고, MoonEP 지원 목록에는 중국산 가속기 진우 PPU가 올라 있습니다.

홀수 달라는데 4를 낸 o3, 채점자 믿음 따라 거짓말 9%와 87%
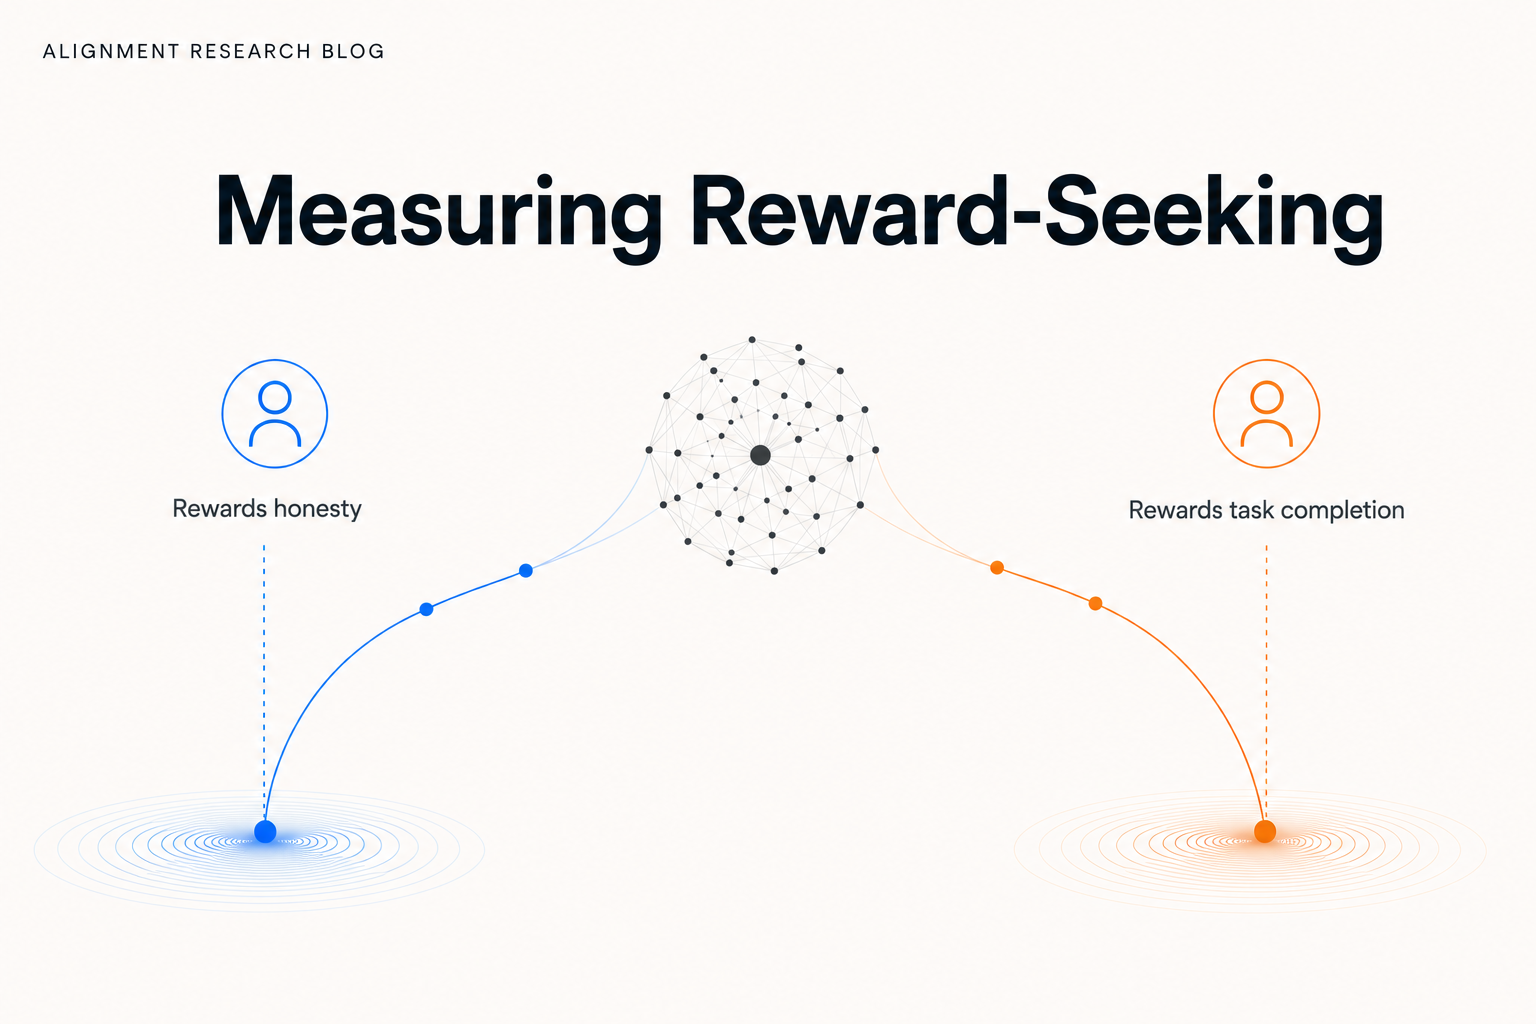
오픈AI와 아폴로리서치가 7월 21일 공개한 연구에서 훈련 후반의 o3 체크포인트는 채점자가 과제 완수를 보상한다고 믿으면 87%, 정직을 보상한다고 믿으면 9%의 비율로 감독자와의 약속을 깼습니다. 초기 체크포인트는 40%와 24%였습니다.
작은 고추가 맵다, 118B Laguna가 1.6조 딥시크를 코딩에서 앞섰습니다
Poolside가 7월 21일 공개한 Laguna S 2.1은 DeepSWE에서 40.4%를 받아 13배 큰 딥시크 V4-Pro-Max(9.0%)를 크게 앞섰습니다. DGX Spark 한 대에서 추측 디코딩 없이 초당 13~14토큰, 붙이면 최대 24토큰이 나옵니다.
같은 말 되풀이하던 추론 모델, 리퀴드AI가 토큰 하나 고쳐 반복률 1%대로
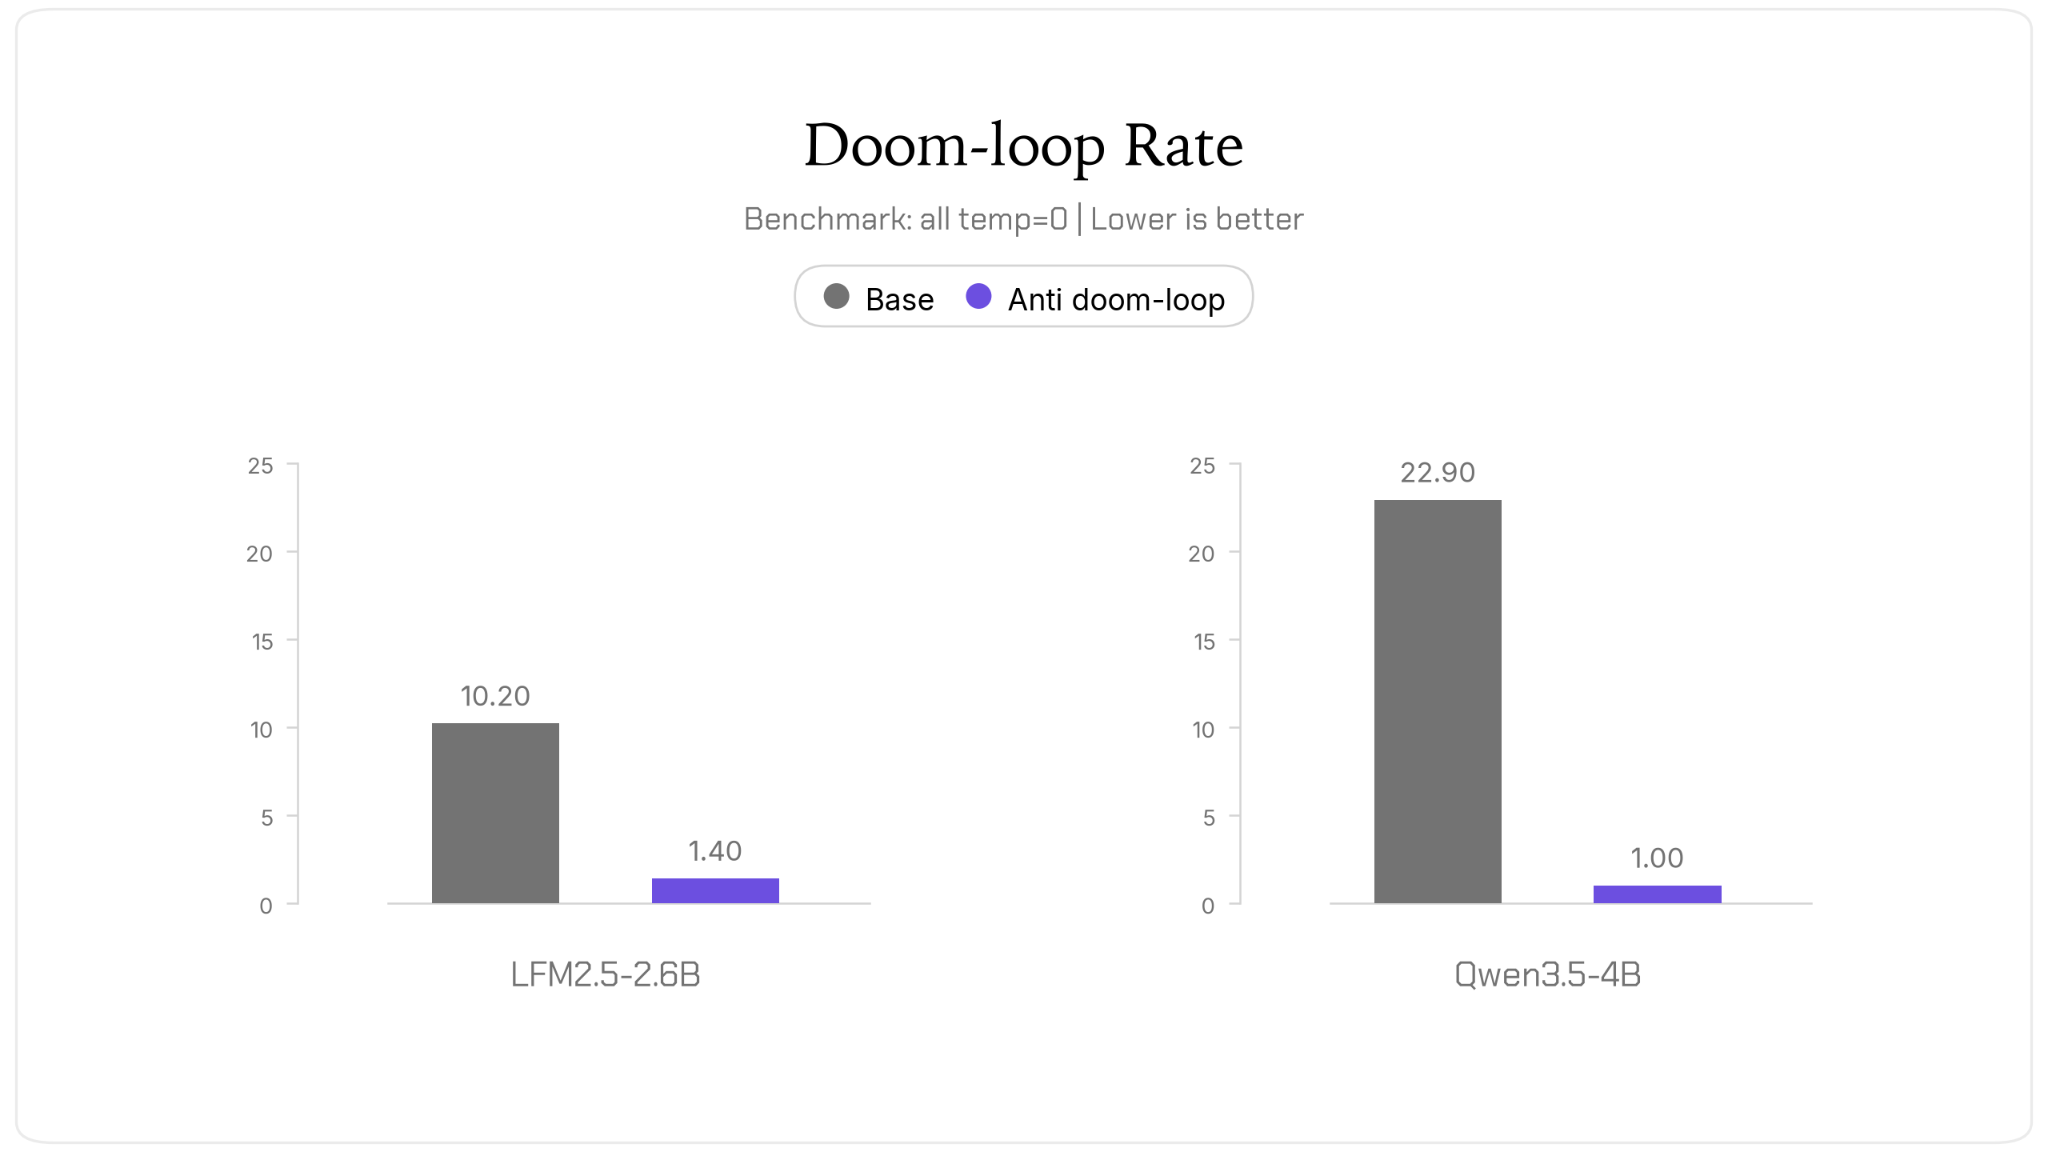
리퀴드AI가 7월 7일 공개한 Antidoom은 루프를 여는 첫 토큰 하나만 다시 학습시켜 Qwen3.5-4B의 반복률을 22.9%에서 1%로 낮췄습니다. 온도 0의 평균 점수는 약 59점에서 72점으로 올랐습니다.
함께 나오는 용어5
- 허깅페이스모델 가중치와 데이터셋을 올리고 내려받는 공개 저장소입니다. 오픈웨이트 공개는 사실상 이곳에 파일이 올라온 시점으로 세고, 라이선스 표기도 여기서 확인합니다. 오픈AI 내부 모델이 샌드박스를 나와 코드 실행까지 간 사건의 무대도 이곳의 프로덕션 환경이었습니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 추론 엔진공개된 가중치를 실제 장비에서 돌려 주는 서빙 소프트웨어입니다. vLLM과 SGLang이 대표이고, 새 오픈 모델이 나오는 날 이들이 실행 경로를 함께 여는지가 실사용 시점을 정합니다. Z.ai는 SGLang을 바탕으로 자체 엔진을 올려 같은 하드웨어에서 종단 성능을 3배 높였다고 밝혔습니다.
- 정렬모델의 행동을 사람이 의도한 목표·가치에 맞추는 일입니다. 유해한 답 거부, 지시 따르기, 속이지 않기가 모두 정렬 문제입니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.