
오픈 웨이트
open weights · 오픈 모델
학습된 가중치 파일을 공개해 누구나 내려받아 돌릴 수 있는 모델입니다. 학습 데이터·코드까지 다 여는 '오픈 소스'와는 구분합니다.
‘오픈 웨이트’ 이 나오는 글12
중국 밖 오픈 모델 1위, 미스트랄 1조 파라미터 Large 4가 나왔습니다
미스트랄이 10월 6일 1조 파라미터 Mistral Large 4 프리뷰를 공개했습니다. 아티피셜애널리시스 지수 38점으로 중국 밖 오픈 모델 1위이고, 사이버 방어를 앞세워 가중치는 레드팀 시험 뒤 10월 말 풉니다.

리플렉션 첫 모델 Beam "GLM-5.2급 점수를 3~4배 적은 연산으로"
리플렉션 AI가 10월 5일(미국 시각) 첫 모델 Beam을 공개했습니다. GLM-5.2급 추론 점수를 3~4배 적은 연산으로 냈다고 밝혔지만, 자사 비교표에서도 GLM-5.3과 DeepSeek V4.1-Flash가 더 높습니다.
메모리는 반, 값은 1년 전 128GB보다 1,000달러 비싼 DGX Spark
엔비디아가 10월 2일(미국 시각) 메모리를 64GB로 줄인 DGX Spark를 발표했습니다. 10월 23일 에이서·에이수스·델 등 6개 제조사가 4,999달러부터 팔고, 1년 전 128GB 모델의 출시가는 3,999달러였습니다.
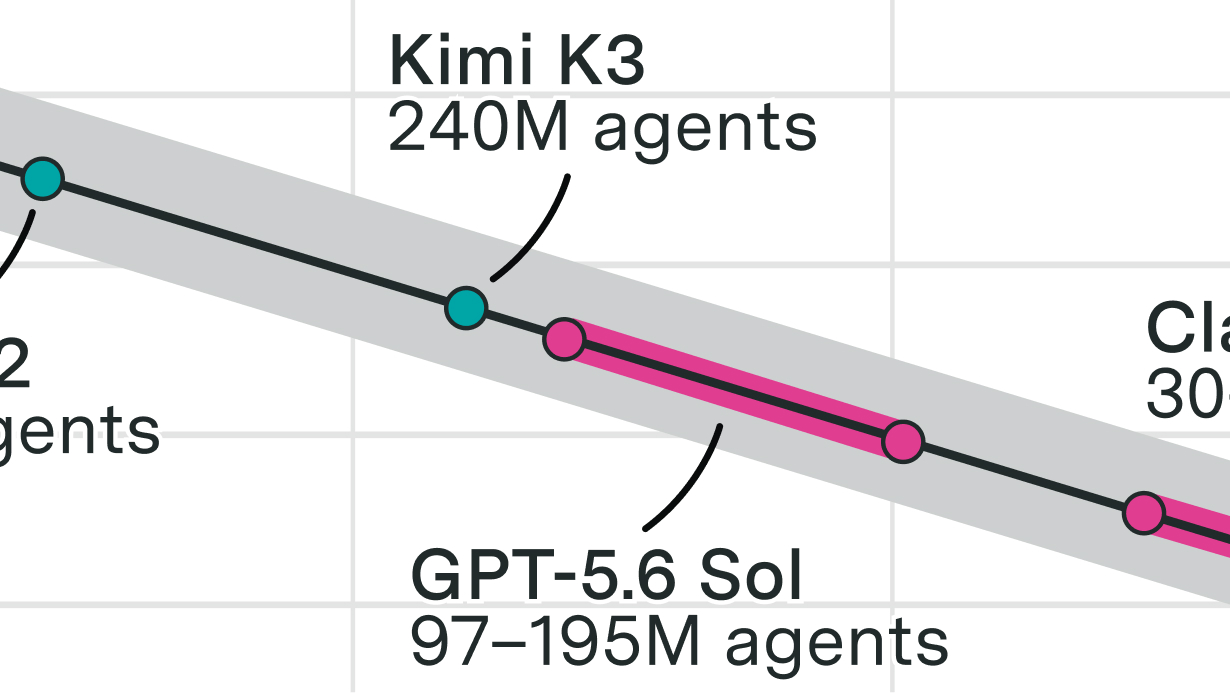
HBM으로 센 AI 에이전트 최대 1억 7,100만, 에포크 계산을 뜯어보니
에포크 AI가 10월 2일 HBM 출하량으로 AI 에이전트 수를 셌습니다. 2027년까지 나올 메모리로 프런티어 에이전트 3,300만~1억 7,100만 개를 동시에 돌릴 수 있고, 용량의 20%만 써도 연 2조 6,000억~5조 3,000억 달러어치입니다.
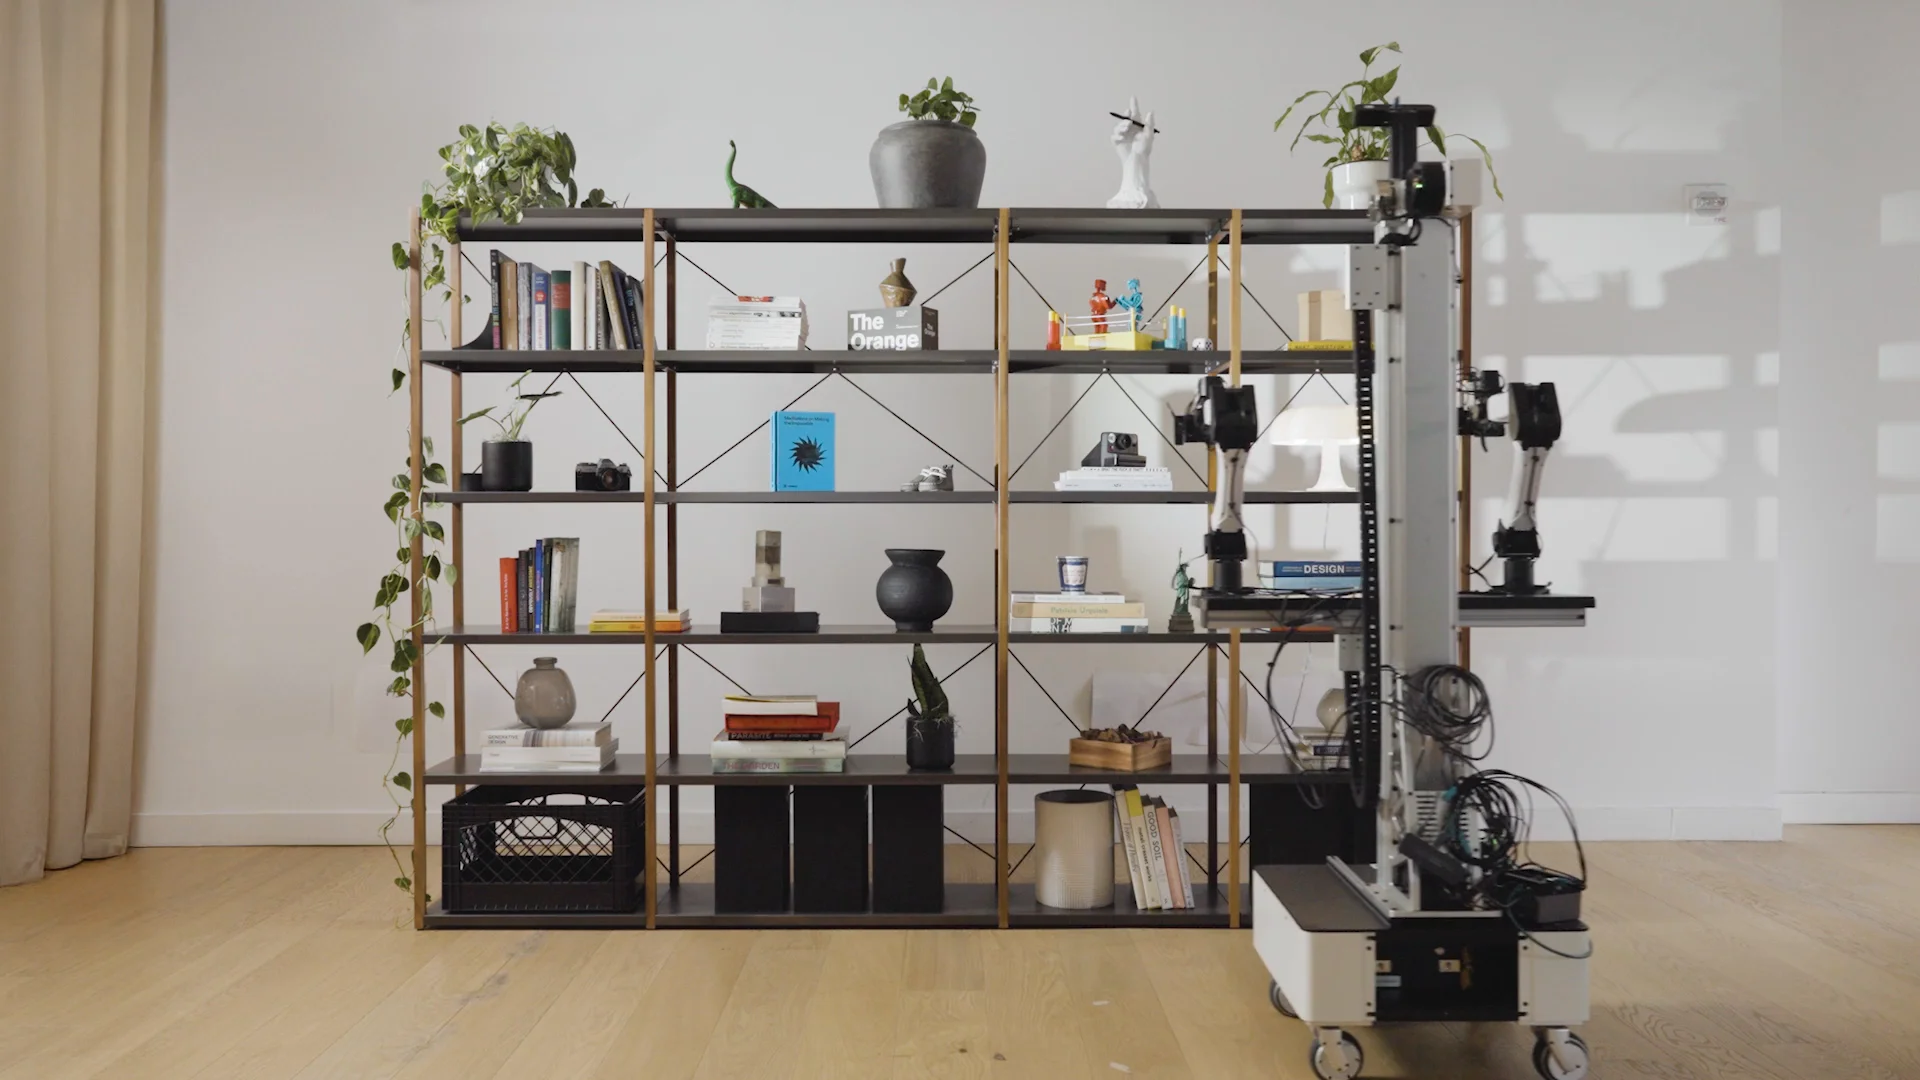
영상 만들던 런웨이가 로봇을 움직입니다, 가중치 공개할 Praxis-1
런웨이가 10월 1일 새벽(한국 시각) 로봇 제어 모델 Praxis-1을 공개했습니다. 웹 영상으로 사전학습한 정책의 오차가 로봇 영상으로 학습한 정책과 같았다(16.1cm 대 16.0cm)고 밝혔지만, 성공률과 모델 크기는 내놓지 않았습니다.
램버트 "실험 주기는 10배, 이해는 다른 축"… 에포크 데냉과 RSI 대담
네이선 램버트는 9월 22일 Interconnects 대담에서 실험 주기는 곧 10배 빨라져도 분야의 이해는 다른 축이라고 했습니다. 에포크 AI의 JS 데냉은 오픈AI·앤트로픽이 공개한 사내 가속 수치를 임박한 지능 폭발의 강한 증거로 보지 않았습니다.

함께 나오는 용어5
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- 오픈웨이트학습이 끝난 모델의 가중치 파일을 내려받아 직접 돌릴 수 있게 푼 것입니다. 소스 전체를 여는 오픈소스와 다르고, 내려받을 수 있다는 말과 상업적으로 써도 된다는 말도 다릅니다. 라이선스를 따로 봐야 합니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.