이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
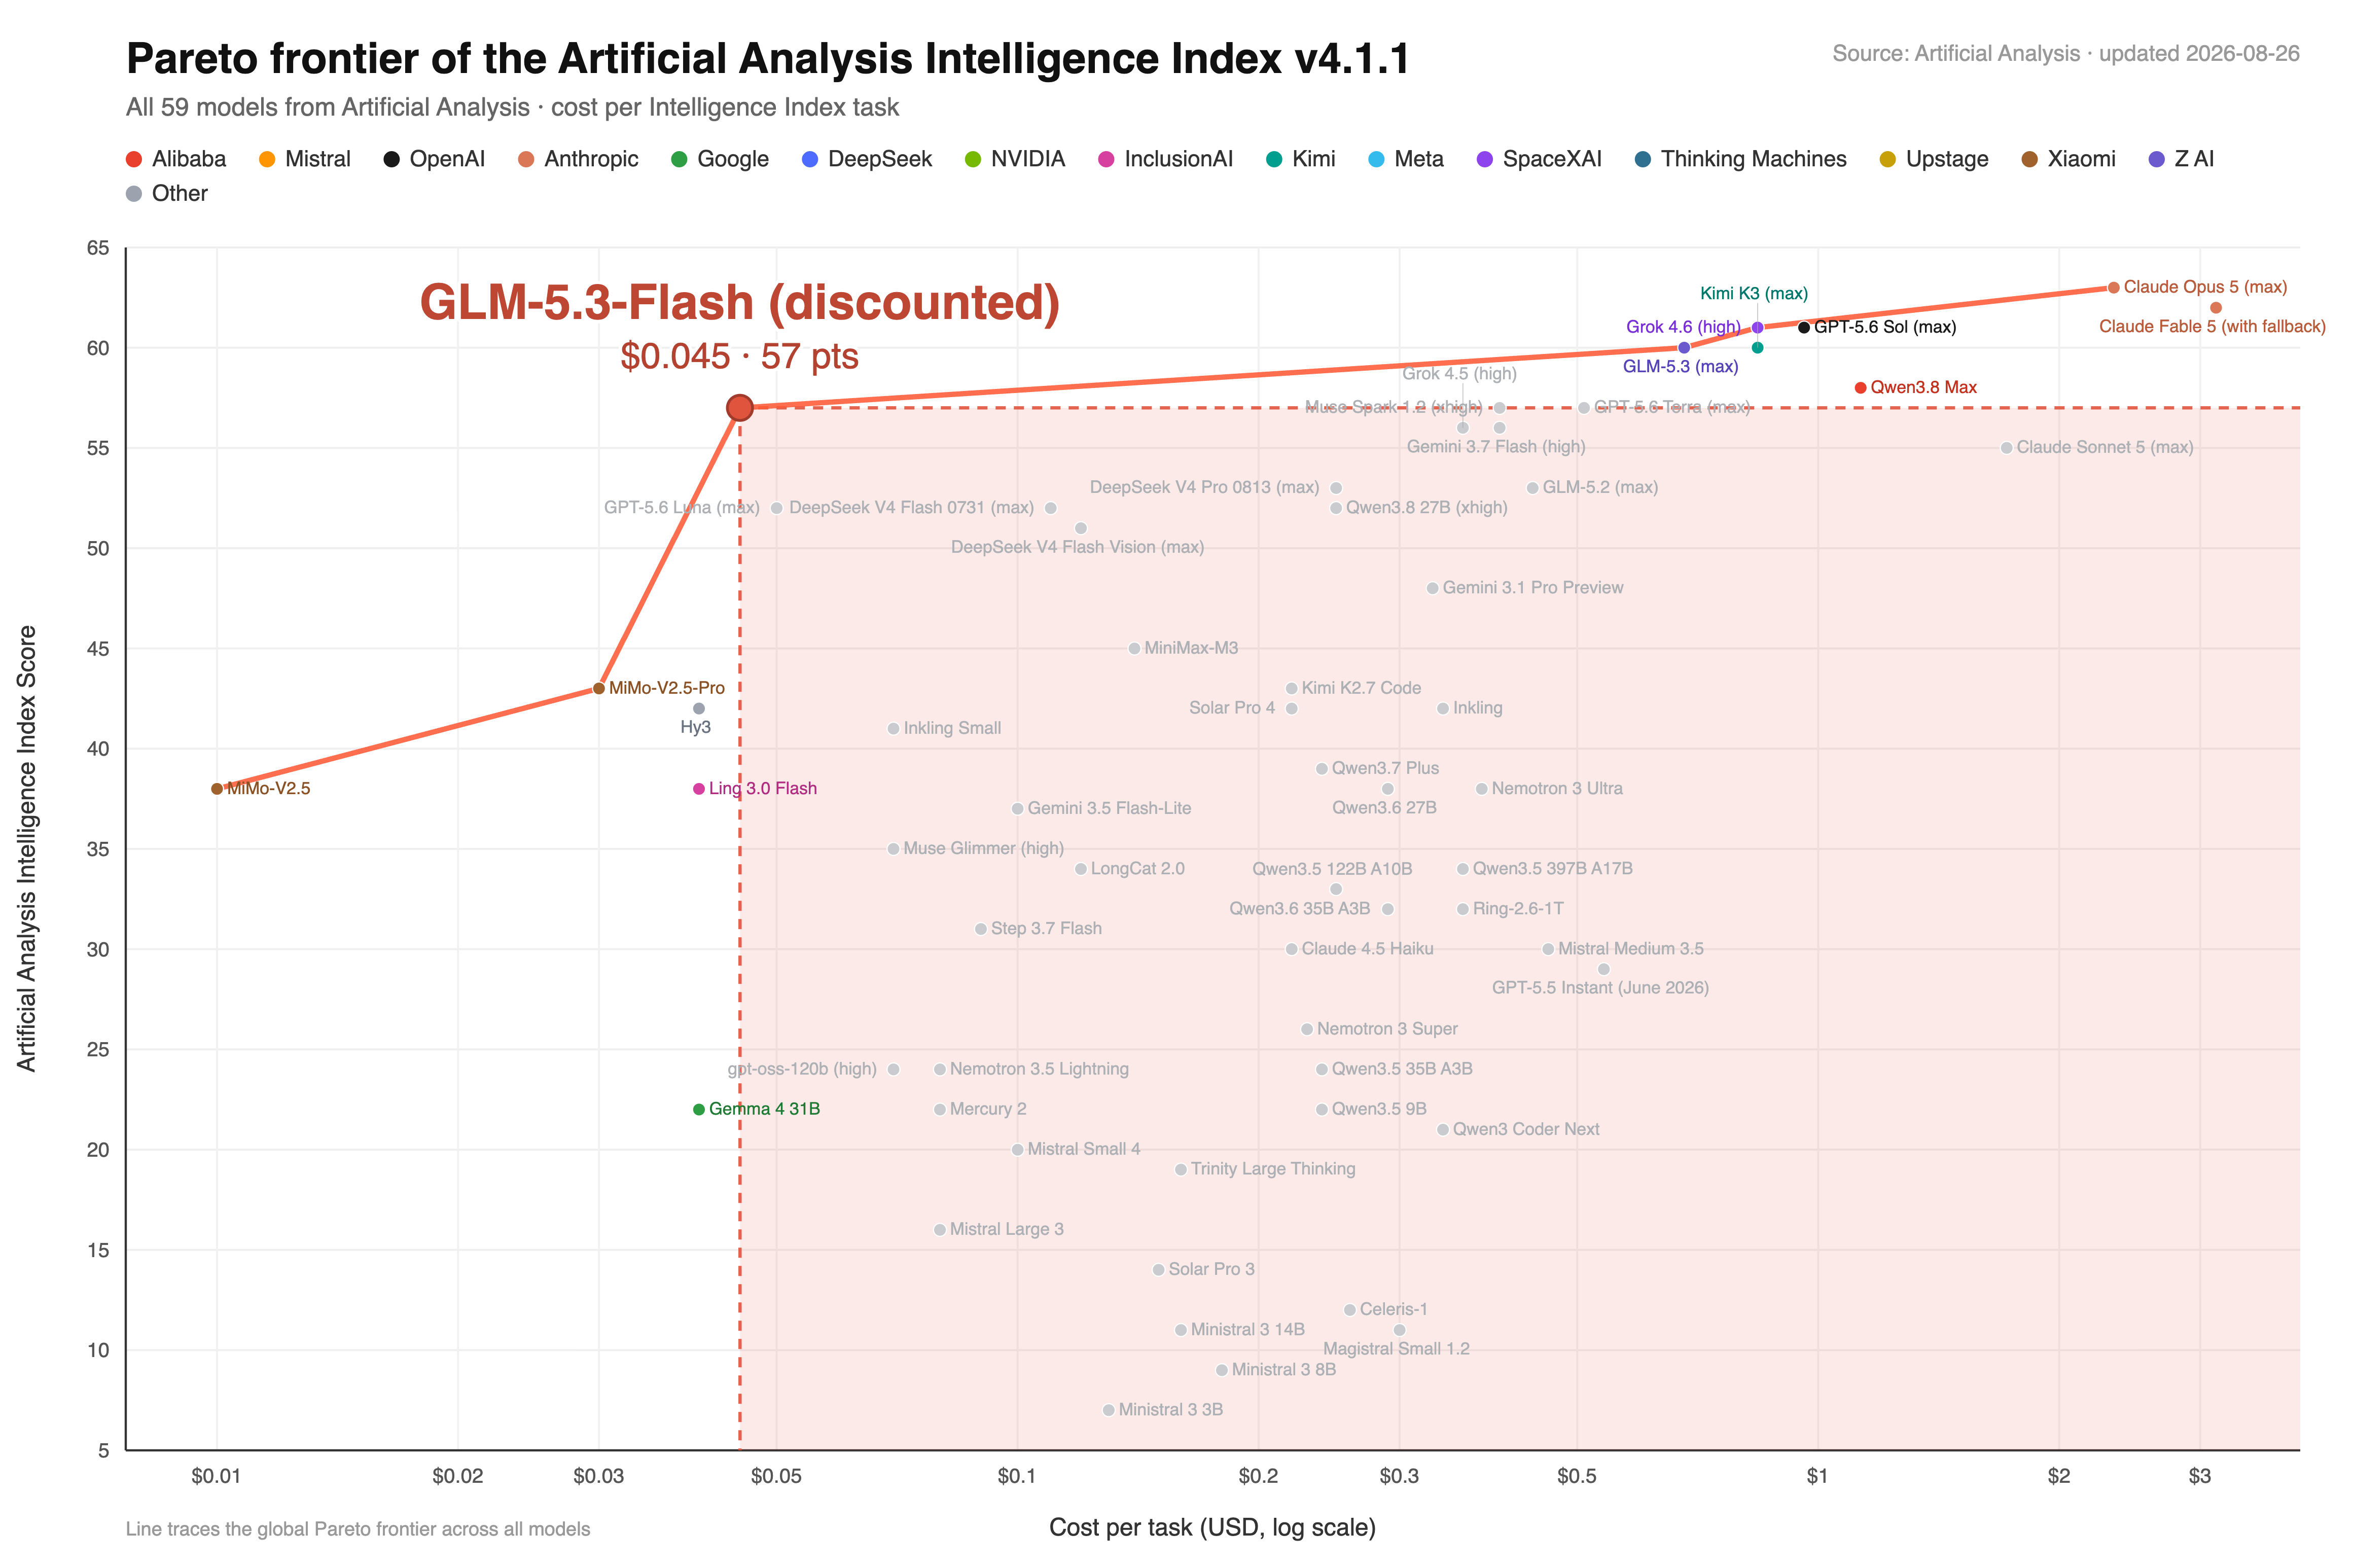
GLM-5.3이 Artificial Analysis 종합 지수에서 58~60점 안팎에 들어온다
8월 26일 Artificial Analysis가 GLM-5.3-Flash 평가 글에서 GLM-5.3(최대 추론)을 60점으로 적었습니다.
Z.ai는 GLM-5.2 때 갖춘 강화학습 도구 위에서 한 달 동안 과제 환경과 과제 종류, 학습 연산을 늘렸다고 밝혔습니다. 숙련된 엔지니어가 며칠 걸리는 실제 업무형 과제를 자동으로 만들고 채점해 학습시킨 방식입니다.
블로그는 안전 평가와 보강을 마친 뒤 발표 2주 뒤에 가중치를 풀겠다고 적었습니다. 라이선스는 밝히지 않았고, 전작 GLM-5.2는 MIT 라이선스였습니다.
취약점을 찾는 CyberGym에서는 84.5%로 Mythos 5(83.8%)와 GPT-5.6 Sol(83.6%)을 앞섰지만, 공격으로 이어 가는 ExploitBench에서는 54.4%로 두 모델(78.0%, 76.5%)에 크게 못 미쳤습니다. 모두 Z.ai가 직접 잰 값입니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
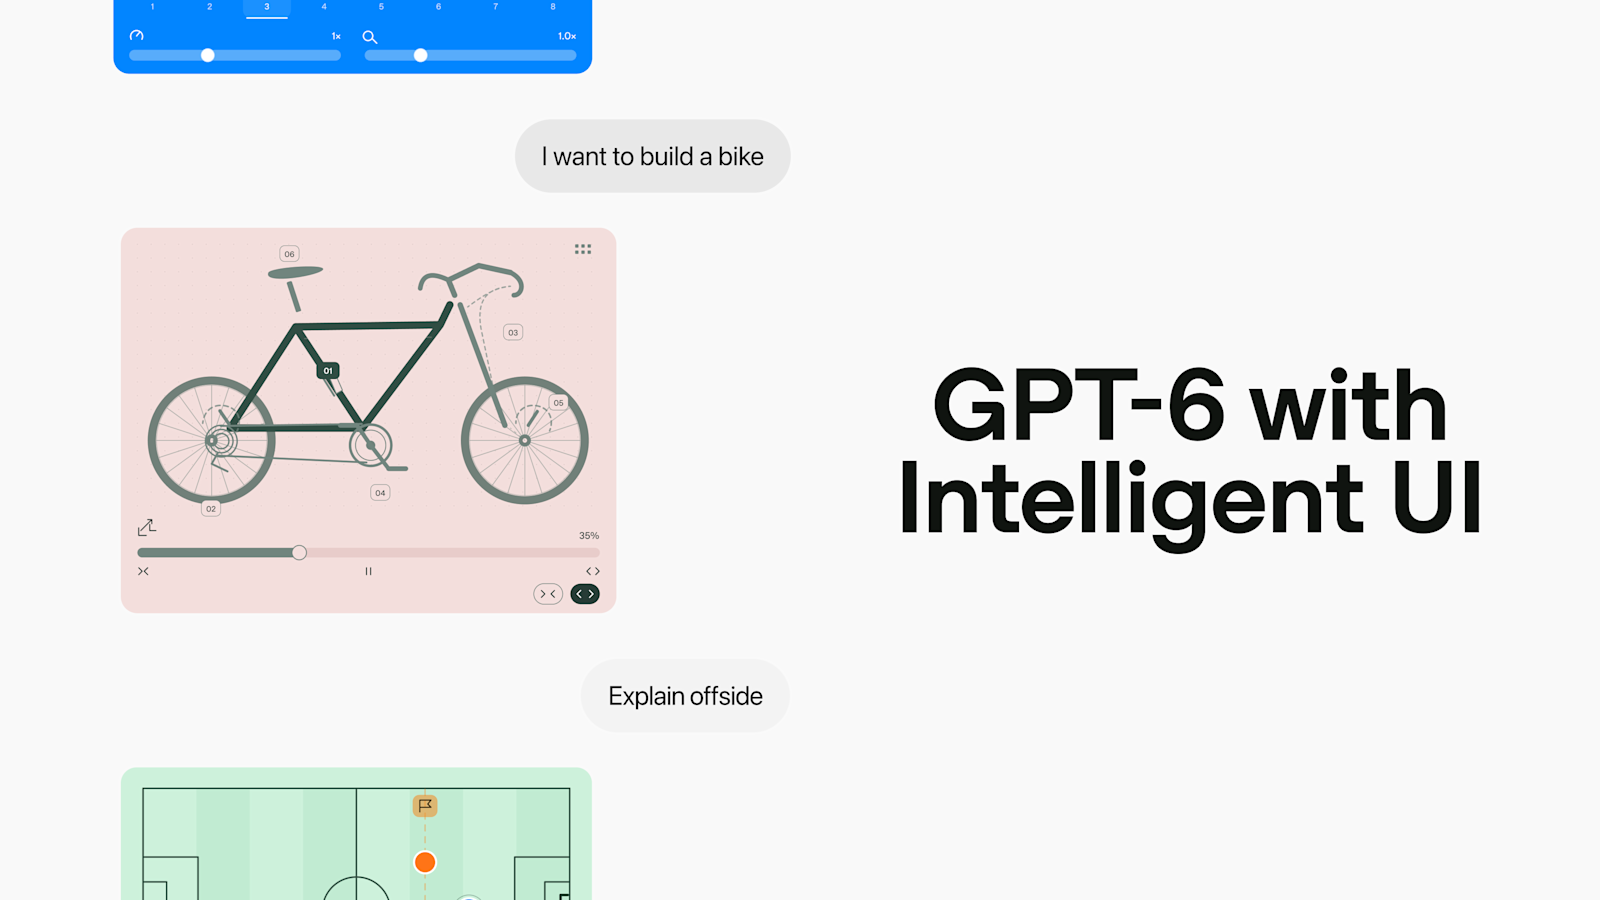
오픈AI가 10월 7일 주간 12억 명이 쓰는 ChatGPT의 Chat에 GPT-6를 넣었습니다. Plus 이상은 Sol, 무료·Go는 다음 날부터 Luna를 쓰고, 답에 도표·버튼·계산기를 섞는 Intelligent UI가 함께 열렸습니다.

앤트로픽이 10월 7일 Claude Haiku 5.5를 GPT-6 Luna와 같은 입력 0.1달러·출력 0.5달러에 내놨습니다. 10만 토큰이 넘는 요청은 5배를 받고, AA 지수는 43점에 과제당 비용은 Luna의 3배인 0.21달러였습니다.
8월 26일 같은 날 공개된 Qwen3.8-Flash-Next와 GLM-5.3-Flash는 설계와 API 가격까지 닮았지만 라이선스가 갈렸습니다. GLM은 조건 없는 MIT로 풀렸고, Qwen에는 모델 API나 AI 도구 사업이면 별도 계약을 받으라는 조항이 붙었습니다.
오픈AI가 10월 7일 주간 12억 명이 쓰는 ChatGPT의 Chat에 GPT-6를 넣었습니다. Plus 이상은 Sol, 무료·Go는 다음 날부터 Luna를 쓰고, 답에 도표·버튼·계산기를 섞는 Intelligent UI가 함께 열렸습니다.
앤트로픽이 10월 7일 Claude Haiku 5.5를 GPT-6 Luna와 같은 입력 0.1달러·출력 0.5달러에 내놨습니다. 10만 토큰이 넘는 요청은 5배를 받고, AA 지수는 43점에 과제당 비용은 Luna의 3배인 0.21달러였습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@Zai_orgX 게시물 · 원문 보기
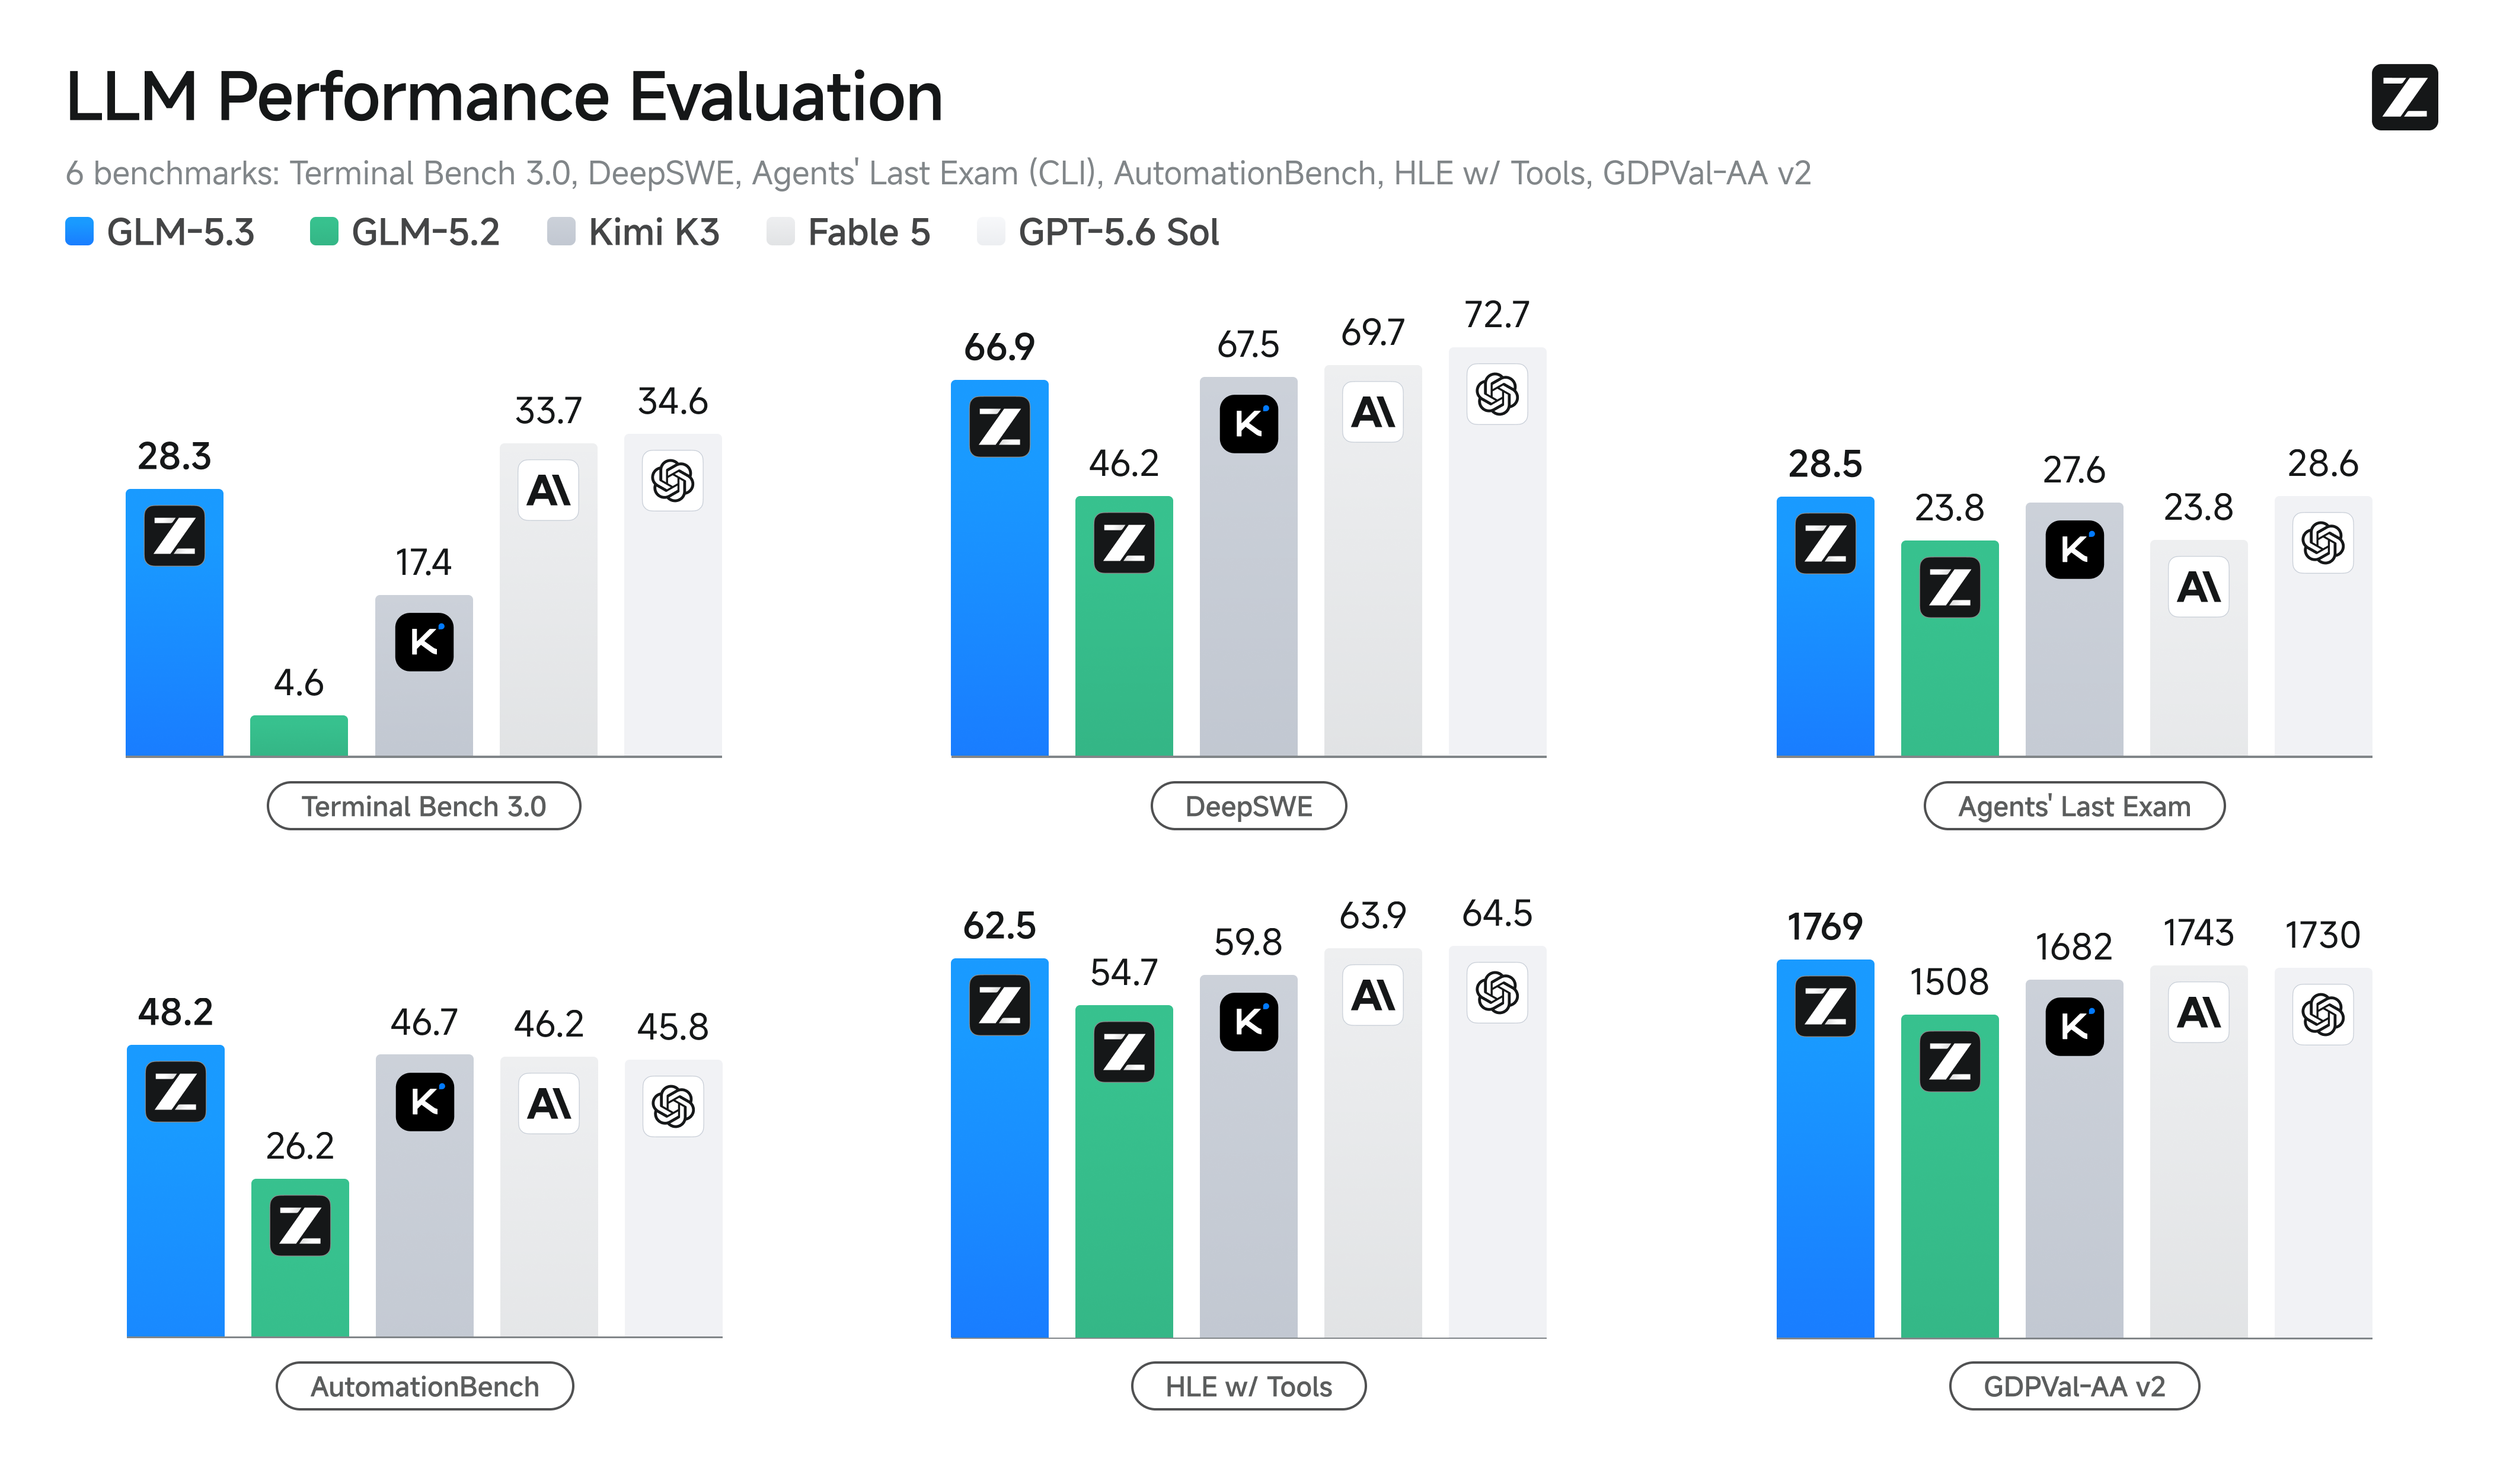
발표 게시물은 GLM-5.3을 코딩을 위해 만들고 사이버 방어에 대비한 모델로 소개합니다. 최상위급 코딩·에이전트 능력은 743B 기반 모델에 후속 학습을 더해 얻었고, 사이버 보안에서는 오픈 모델의 새 기준을 세웠다는 두 줄입니다. 함께 올린 도표에는 평가 9개가 실렸는데, 오픈 모델인 GLM-5.2·문샷AI Kimi K3와 견주면 GLM-5.3이 8개에서 앞서고 코딩 에이전트 평가 DeepSWE 하나만 Kimi K3(67.5)가 GLM-5.3(66.9)보다 높습니다.
Z.ai는 칭화대 연구실에서 출발한 베이징의 즈푸(Zhipu AI)가 해외에서 쓰는 이름입니다. 미국 상무부는 2025년 1월 16일 즈푸와 관련 법인들을 수출 통제 명단(Entity List)에 올렸고, 그 뒤로 미국 수출 규정이 적용되는 품목은 미국 정부 허가 없이 이 회사에 팔 수 없습니다. 엔비디아 칩도 여기에 들어갑니다.
언어 모델은 보통 두 단계로 만듭니다. 사전학습은 수십조 개 토큰의 글과 코드를 읽혀 기본 지식을 쌓는 단계로, 대규모 칩을 몇 달씩 돌립니다. 후속 학습은 이렇게 만든 기반 모델에게 실제 과제를 풀게 하고 잘하면 점수를 주는 강화학습으로 행동을 다시 잡는 단계입니다. 사전학습이 교과서를 통째로 읽히는 일이라면 후속 학습은 현장 실습을 시키며 채점하는 일에 가깝고, Z.ai 기술 블로그는 첫 문장에서 GLM-5.3을 만든 방법을 이 뒷단 하나로 좁혔습니다.
GLM-5.3을 위해 우리가 한 일은 후속 학습을 키운 것이 전부입니다.— Z.ai, GLM-5.3 기술 블로그
Z.ai는 GLM-5.2 때 이 뒷단의 도구를 먼저 갖췄습니다. 희소 어텐션의 인덱서 결과를 여러 레이어가 나눠 써서 긴 문맥을 싸게 처리하는 IndexShare, 긴 에이전트 작업을 비동기로 안정되게 학습시키는 강화학습 기법 SAO, 대규모 비동기 학습 프레임워크 slime입니다. 지난 한 달은 이 위에 과제 환경을 늘리고, 과제 종류를 넓히고, 학습에 쓰는 연산을 키우는 데 들였다고 적었습니다.
과제 환경은 코딩 연습 문제보다 전문가의 실제 업무 단위에 가깝게 짰고, 숙련된 엔지니어가 며칠 걸리는 과제도 들어 있습니다. 블로그가 든 예는 머신러닝 인프라 과제입니다. 모델에게 엔지니어와 같은 작업 환경, 곧 연산 클러스터와 저장소, 사내 문서, 코드베이스, 실험 결과를 주고, 학습 스택 전체에서 병목을 찾아 최적화를 구현한 뒤 실험을 돌려 정확도를 지키면서 속도를 실제로 끌어올리라고 시킵니다.
이런 환경을 사람이 하나씩 만들 수는 없어서, 만드는 과정도 자동화했습니다. 연구용 에이전트가 실제 업무에서 과제 유형을 모아 실행 가능한 긴 과제로 바꾸고, 심사용 에이전트가 직접 풀어 보며 풀 수 있는 과제인지 확인합니다. 채점기는 정답 풀이를 보지 않은 채 만들고, 모델이 푼 기록을 살펴 편법으로 점수를 따는 구멍을 막습니다. Z.ai는 에이전트의 능력이 오를수록 후속 학습을 키우는 데 드는 품이 모델보다 과제 환경 쪽에 더 많이 든다고 적었고, 이 파이프라인에 아직 사람 손이 적잖이 든다는 점도 밝혔습니다.
전작보다 가장 크게 오른 항목은 터미널 작업과 코딩 에이전트 평가입니다. Terminal-Bench 3.0은 코드 컴파일과 서버 설정, 디버깅처럼 터미널에서 일을 끝까지 해내는지 보는 평가로, 4.6에서 28.3이 됐습니다. 공개된 적 없는 오픈소스 저장소 과제로 채점하는 DeepSWE는 46.2에서 66.9로, 에이전트 종합 평가 Agents' Last Exam은 23.8에서 28.5로 올랐습니다.
| 평가 | GLM-5.3 | GLM-5.2 | Kimi K3 | Opus 4.8 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 3.0 | 28.3 | 4.6 | 17.4 | 21.1 | 33.7 | 34.6 |
| DeepSWE 1.1 | 66.9 | 46.2 | 67.5 | 58.0 | 69.7 | 72.7 |
| Agents' Last Exam | 28.5 | 23.8 | 27.6 | 25.7 | 23.8 | 28.6 |
| AutomationBench | 48.2 | 26.2 | 46.7 | 41.0 | 46.2 | 45.8 |
| GDPval-AA v2 | 1769 | 1508 | 1682 | 1588 | 1743 | 1730 |
| CyberGym | 84.5 | 77.2 | 80.0 | 78.1 | 83.8 | 83.6 |
| ExploitBench | 54.4 | 24.4 | 32.2 | 40.0 | 78.0 | 76.5 |
단위는 %이고 GDPval-AA만 Elo 점수이며, 사이버 두 항목의 앤트로픽 열은 Mythos 5의 점수입니다(출처: Z.ai).
폐쇄형 최상위 모델과는 아직 거리가 있습니다. Terminal-Bench 3.0에서 오픈AI GPT-5.6 Sol은 34.6, 앤트로픽 Fable 5는 33.7이고, DeepSWE에서도 GLM-5.3은 Sol(72.7)과 Fable 5(69.7) 아래입니다. 표 전체에서 GLM-5.3이 모든 모델을 통틀어 가장 높은 항목은 CyberGym과 AutomationBench, GDPval-AA 셋입니다. GDPval-AA는 독립 평가기관 Artificial Analysis(AA)가 채점하는 44개 직업의 실무 평가이고, 나머지 대부분은 Z.ai가 Claude Code 2.1.207을 하네스(모델에 도구를 쥐여 주고 일을 시키는 실행 틀)로 삼아 직접 잰 값입니다.
오픈 모델끼리 좁혀도 조건을 붙여 읽을 대목이 있습니다. X 도표에 실린 9개 항목에서는 8개에서 1위였지만, 블로그 전체 표의 16개 항목으로 넓히면 GLM-5.3이 오픈 모델 가운데 1위인 항목은 11개입니다. Kimi K3가 DeepSWE와 Terminal-Bench 2.1, SWE-Marathon, Toolathlon에서, 딥시크 V4-Pro가 저장소 단위 코딩 평가 NL2Repo에서 앞섰습니다. 구글이 하루 전 내놓은 제미나이 3.7 Flash의 DeepSWE 점수 65.3보다는 1.6점 높습니다.
Z.ai가 따로 공개한 사내 코딩 평가 Z.ai Code Bench에서는 비용 쪽 변화가 보입니다. 실제 사용자 상황을 본뜬 복잡한 로컬 개발 환경에서 과제 완수율을 재는 평가인데, 추론 강도를 최대로 올렸을 때 GLM-5.3은 과제당 출력 토큰 약 7만 5,000개로 34.5%를 받았습니다. 같은 설정의 GLM-5.2는 9만 6,000개를 쓰고 23.4%였습니다.
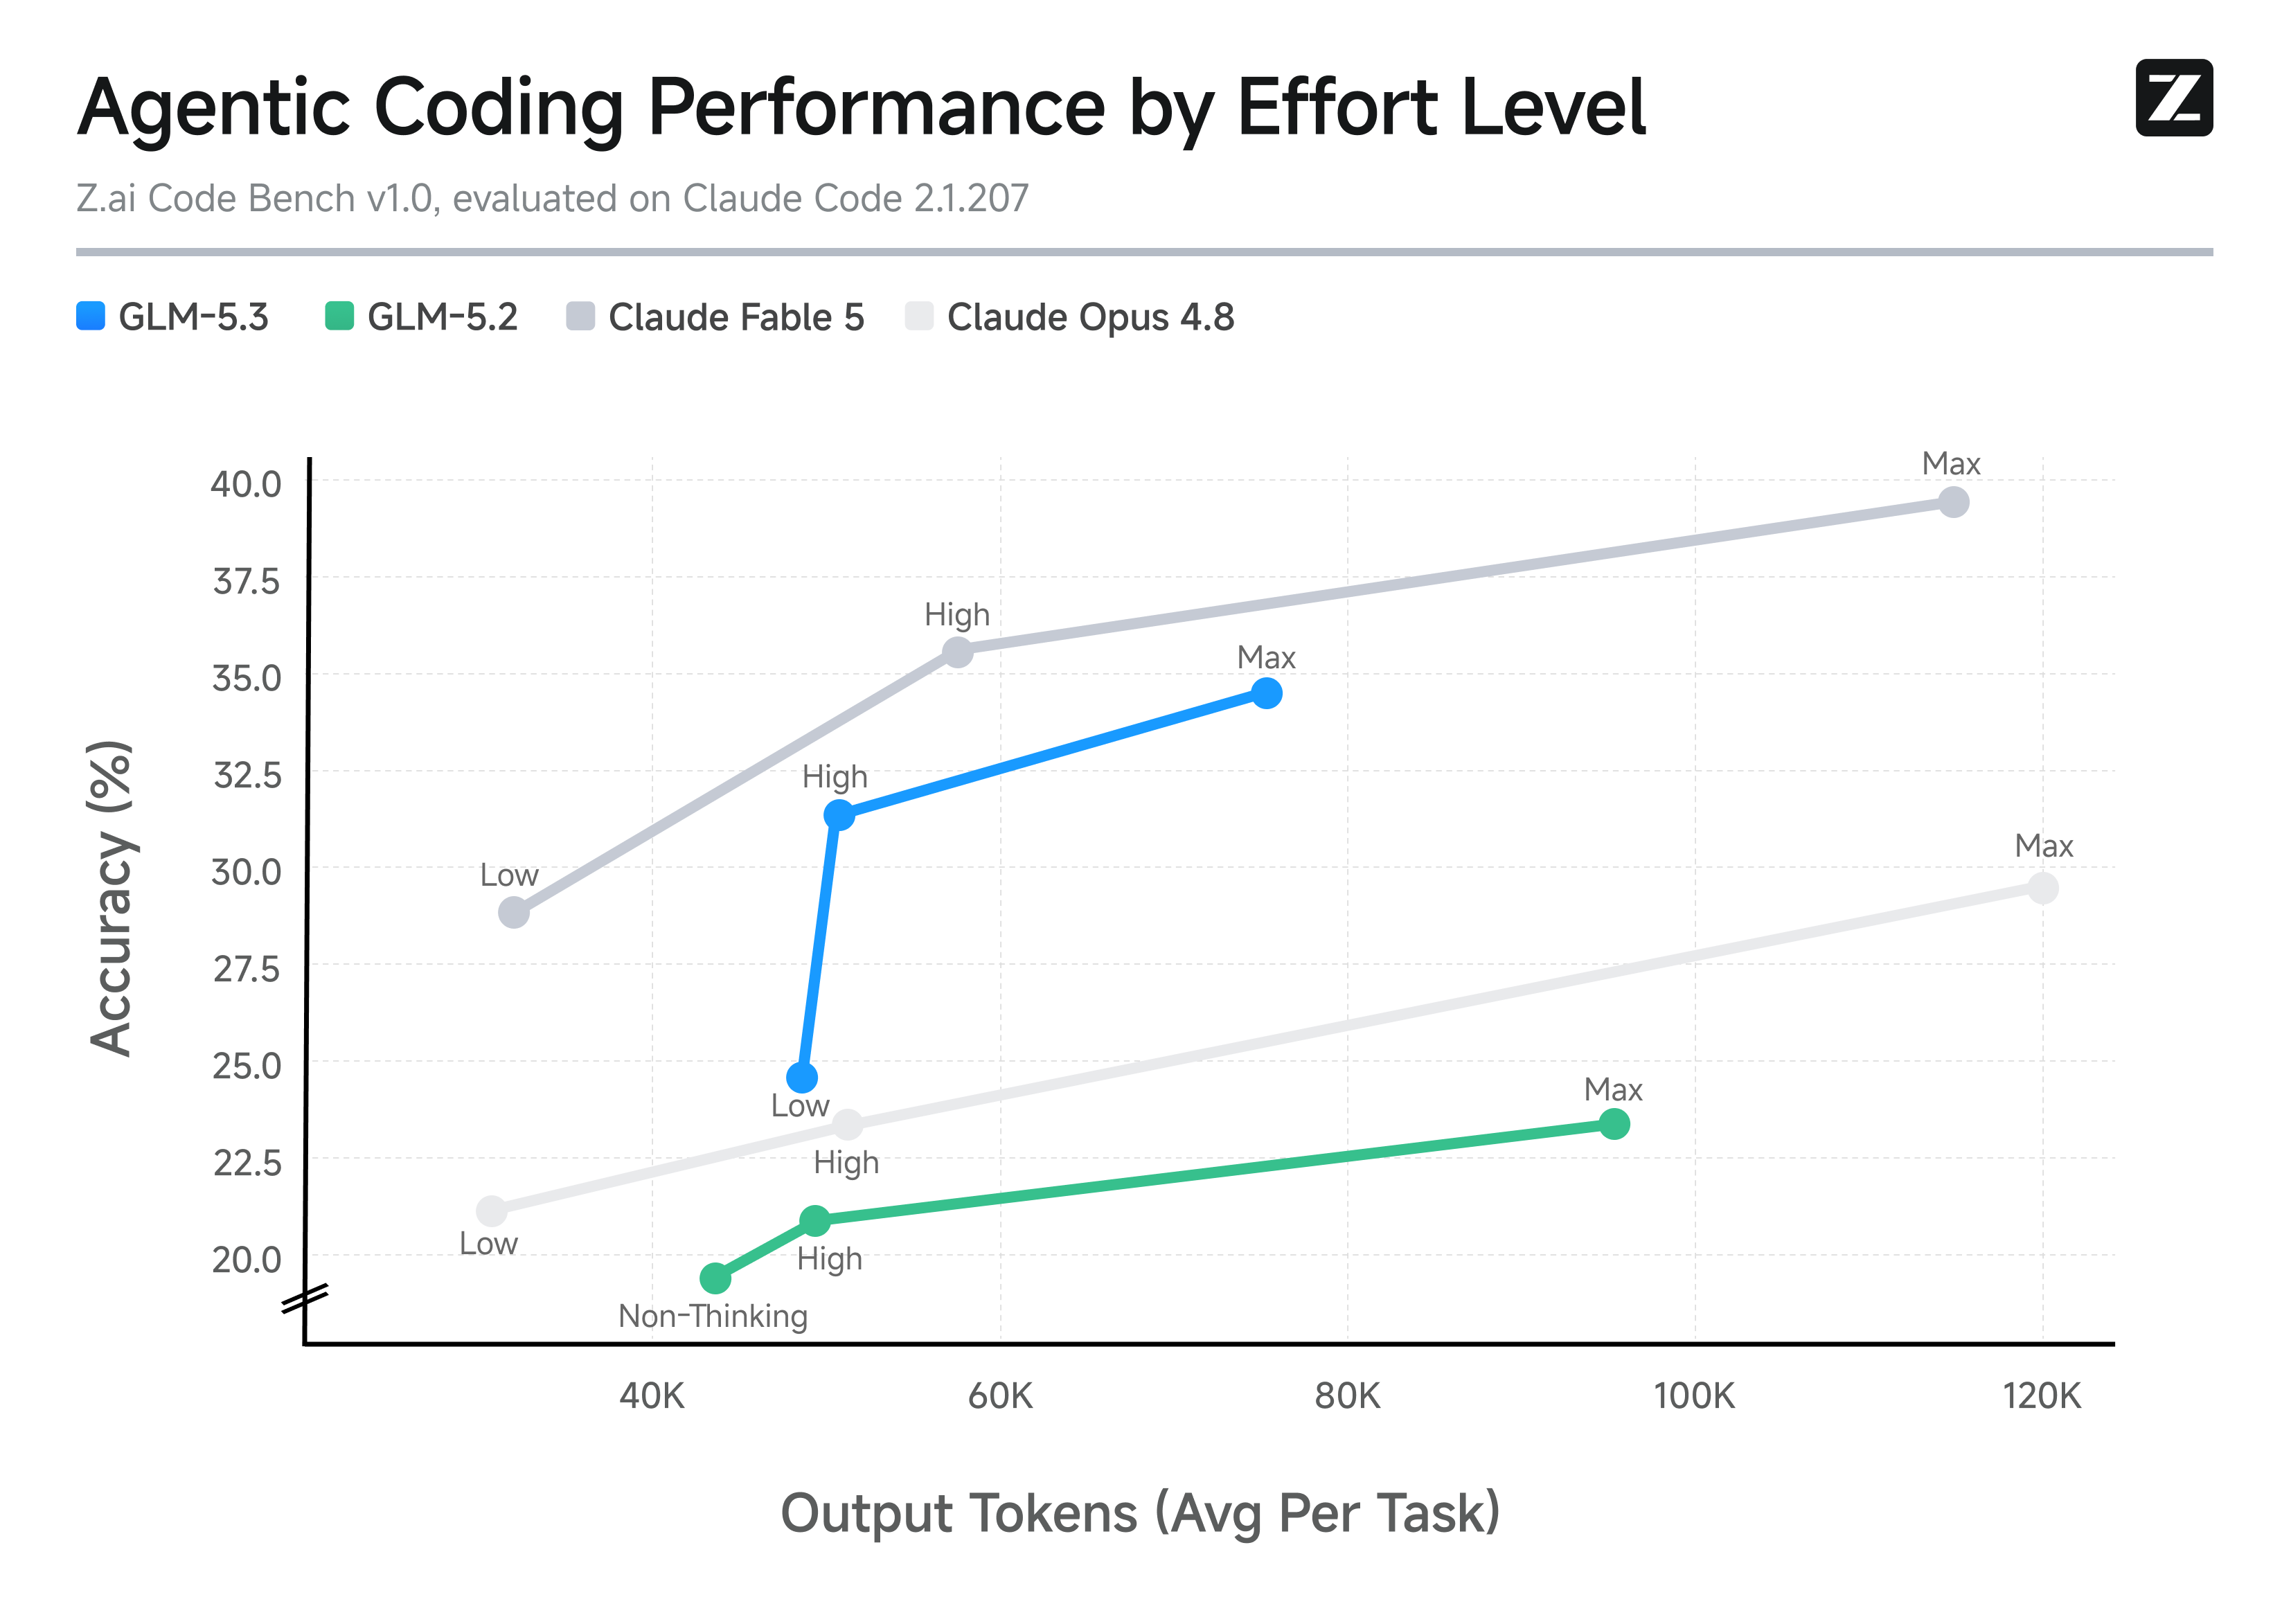
폐쇄형 모델과 견주면 차이가 더 벌어집니다. 한 단계 낮은 High 설정의 GLM-5.3은 약 5만 토큰으로 31.4%를 받아, 12만 토큰을 쓴 Claude Opus 4.8(29.5%)을 절반이 안 되는 토큰으로 앞섰습니다. 최대 설정의 Fable 5는 39.5%로 여전히 가장 높았습니다.
에이전트에 일을 맡기는 회사의 청구서는 쓴 토큰 수에 토큰 단가를 곱해 나옵니다. 점수가 오르면 실패해서 다시 돌리는 횟수가 줄고, 토큰이 줄면 한 번 돌릴 때 드는 값이 줄어서, 두 변화가 모두 완료된 과제 하나의 비용을 낮춥니다. Z.ai는 이 평가를 비공개로 운영해 공개 문제집이 학습 데이터에 섞일 위험을 줄였다고 설명했는데, 같은 이유로 바깥에서는 이 숫자를 재현할 수 없습니다.
발표에서 코딩만큼 앞세운 분야가 사이버 보안입니다. Z.ai는 후속 학습에 취약점 탐지 데이터와 환경을 넣으면서 취약점을 더 잘 찾는 정도를 기대했는데, 학습을 키울수록 능력이 예상보다 빨리 자랐다고 적었습니다. 결함 하나를 찾는 데서 나아가 공격의 여러 단계를 이어 완전한 공격 사슬을 계획하기 시작했다는 설명입니다.
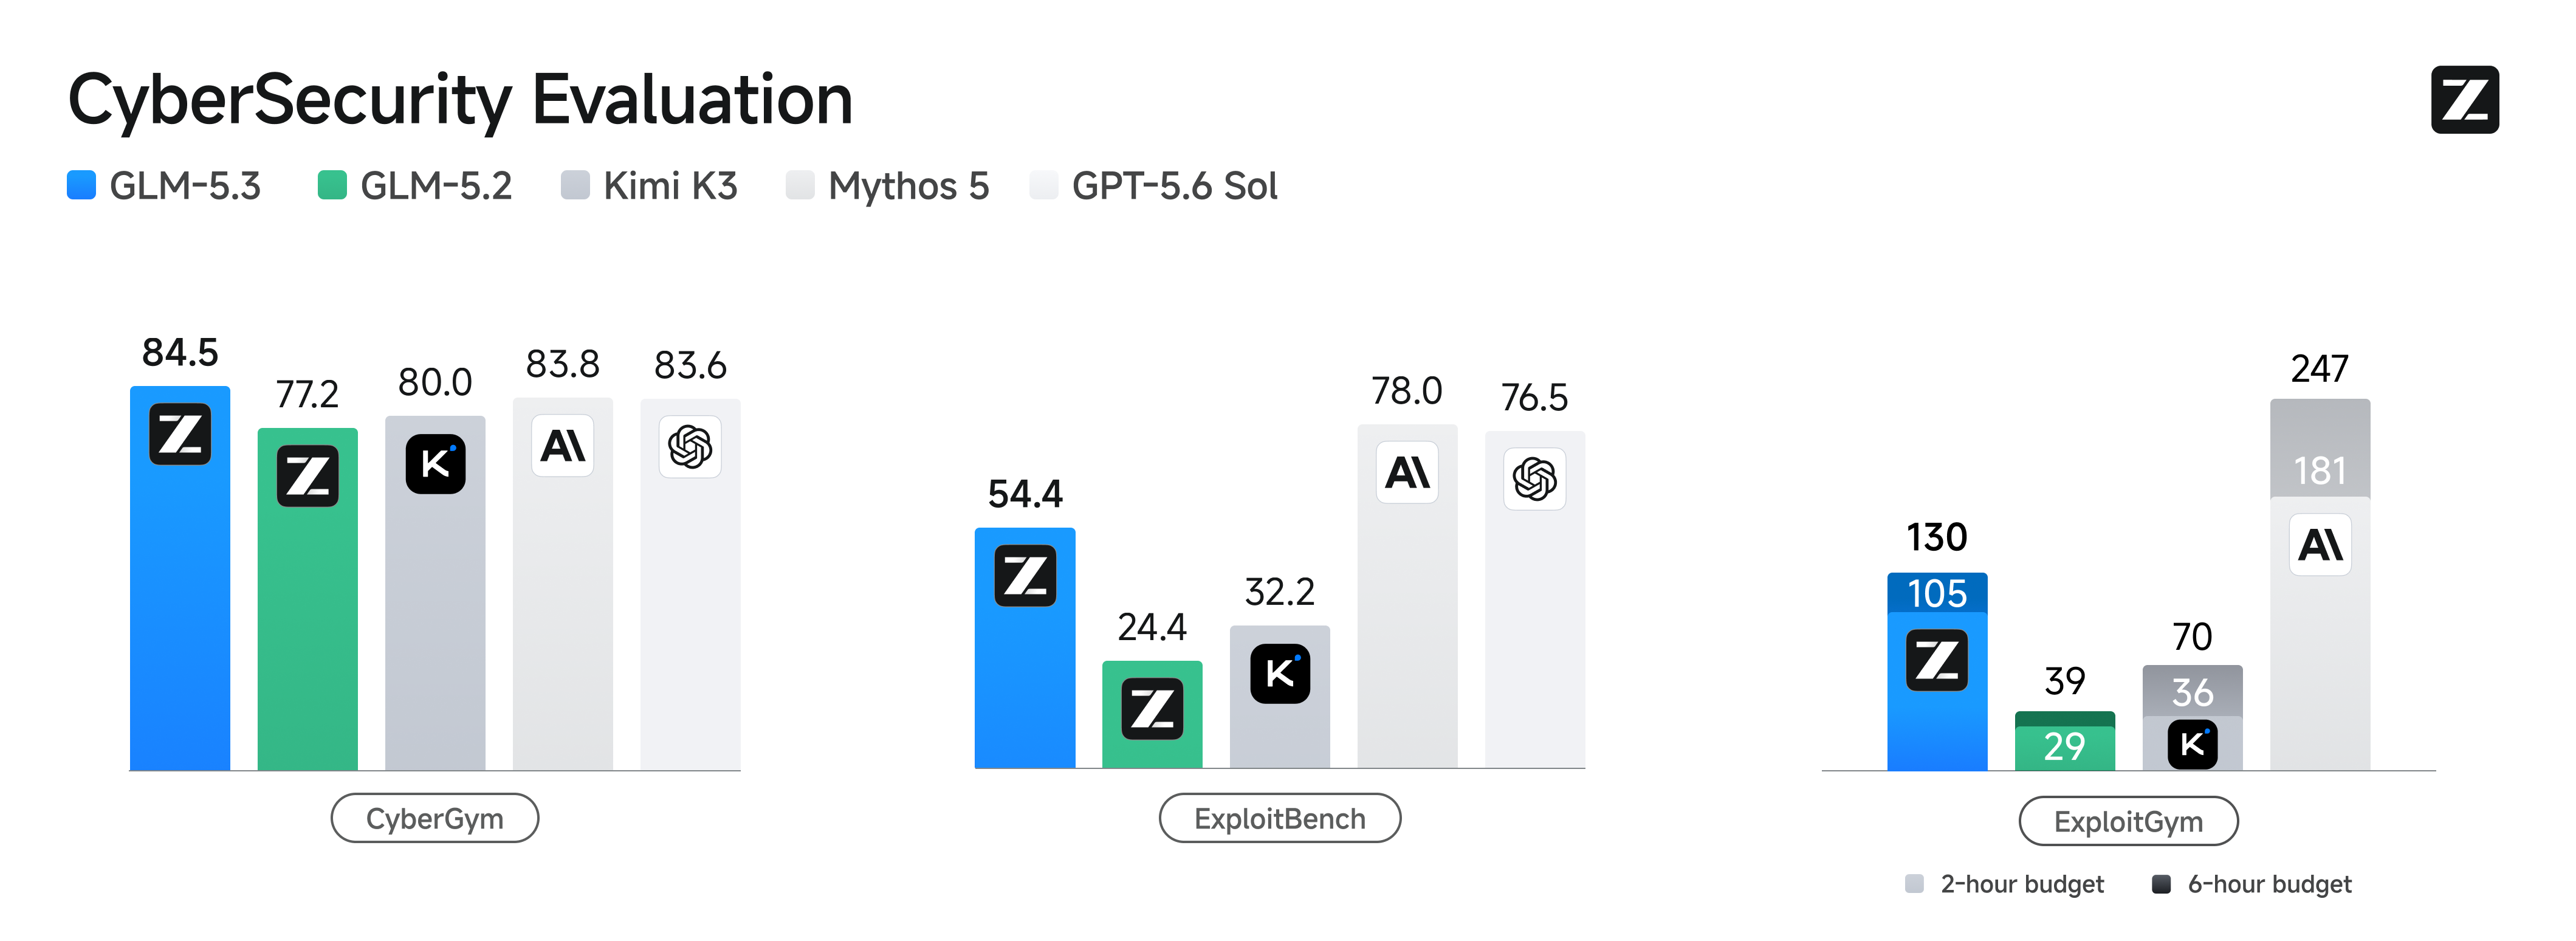
공격 단계가 깊어질수록 전작보다 오른 폭도, 폐쇄형 모델과 남은 차이도 함께 커졌습니다. 소스 코드를 보고 취약점을 찾아 실제로 오류를 일으키는지 확인하는 CyberGym(과제 1,507개)에서는 84.5%로 앤트로픽 Mythos 5(83.8%)와 GPT-5.6 Sol(83.6%)을 앞섰습니다. 실제 취약점을 공격으로 이어 가는 ExploitBench에서는 GLM-5.2의 24.4%를 54.4%로 두 배 넘게 올렸지만, Mythos 5(78.0%)와 Sol(76.5%)에는 크게 못 미쳤습니다. 제한 시간 안에 끝낸 공격 과제 수를 세는 ExploitGym에서도 2시간·6시간 기준 105건·130건으로 GLM-5.2(29건·39건)보다 크게 늘었지만, Mythos 5(181건·247건)와는 차이가 남았습니다.
능력은 우리가 가장 뒤처진 곳에서 가장 빠르게 자라고 있습니다.— Z.ai, GLM-5.3 기술 블로그
실험실 밖의 기록도 함께 냈습니다. Z.ai는 GLM-5.2 때부터 중국 보안팀 여러 곳과 함께 실제 코드베이스에 모델을 돌렸고, 전문가 검토와 중복 제거를 거쳐 프로젝트 269개에서 취약점 2,436개를 찾았다고 밝혔습니다. 블로그에 붙은 집계표로는 치명적 등급이 107건, 높음 등급이 990건입니다. 운영체제 커널과 브라우저 엔진, 네트워크 프로토콜까지 걸쳐 있고 가장 오래된 것은 약 40년 전에 들어간 결함이었다고 하며, Z.ai는 공개 절차를 밟는 취약점을 따로 적는 공개 장부(cvd.z.ai)도 열었습니다.
GLM의 사이버 역량은 전작 때 이미 바깥의 측정으로 확인된 적이 있습니다. 영국 AI보안연구소(AISI)는 7월 GLM-5.2를 측정 시점에 사이버 역량이 가장 높은 오픈웨이트 모델로 꼽았고, 좁은 공격 과제에서는 4개월 먼저 나온 Claude Opus 4.6과 비슷하다고 적었습니다. 보안업체 Semgrep이 6월에 돌린 실험에서는 프롬프트만 받은 GLM-5.2가 권한 검사가 빠진 취약점(IDOR) 탐지에서 F1 39%로 Claude Code(37.4%)를 앞섰고, 찾아낸 취약점 하나에 약 0.17달러가 들었습니다.

공개 순서는 그 사이 달라졌습니다. GLM-5.2는 6월 13일 코딩 구독에 먼저 열고 3일 뒤인 6월 16일 MIT 라이선스로 가중치를 풀었습니다. GLM-5.3은 발표 당일 코딩 구독 GLM Coding Plan의 모든 등급에 들어갔지만, 더 넓은 공개는 뒤로 미뤘습니다. Z.ai의 쯔쉬안 리(Zixuan Li)는 발표 직후 이렇게 적었습니다.
@ZixuanLi_X 게시물 · 원문 보기
선정된 파트너가 엄격한 안전장치 아래 먼저 쓰고 있고, 더 넓은 접근과 API는 안전·보안 평가를 마친 뒤에 열겠다는 내용입니다. 가중치도 평가가 끝나고 적절한 안전장치가 갖춰지면 공개하며, 독립 보안 전문가와 기관들과 함께 위험을 평가하고 있다고 덧붙였습니다. 블로그는 가중치 공개 시점을 발표 2주 뒤로 적었고, 어떤 라이선스로 풀지는 밝히지 않았습니다. AI 소식을 모아 전하는 계정 kimmonismus는 발표 두 시간 뒤 안타깝게도 이번 발표 뒤에는 미국 정부가 오픈소스를 규제할 것 같다고 적었습니다.
발표 직후 X에서는 Z.ai가 공개 벤치마크에 점수를 과하게 맞췄다는 의심, 이른바 벤치맥싱(benchmaxxing) 지적이 이어졌습니다. 언어 모델의 강화학습과 후속 학습을 연구해 온 네이선 램버트는 같은 날 이 논쟁을 여섯 갈래로 정리했습니다.
@natolambertX 게시물 · 원문 보기
그는 Z.ai가 오픈AI나 앤트로픽보다 공개 벤치마크를 조금 더 신경 쓰는 것은 맞고 마케팅에도 도움이 되지만, 모델이 망가질 정도로 맞추지는 않았을 것이라고 봤습니다. 사내에서 이 모델을 많이 쓸 테니 그랬다면 고쳤으리라는 이유입니다. 대신 잘하는 과제의 범위는 좁을 수 있다고 짚었습니다. GLM-5.2도 에이전트 작업은 뛰어났지만 나머지는 그렇지 않았고, 이미지 입력이 없는 단일 모달 모델이라 그만큼 만들기 쉬웠다는 겁니다. 출시까지 걸리는 시간이 오픈AI·앤트로픽은 몇 달, Z.ai는 며칠이라는 차이도 점수를 돋보이게 한다고 적었고, 가중치가 풀려 더 넓게 시험해 보기를 기다린다며 글을 맺었습니다.
독립 기관의 측정은 아직 나오지 않았습니다. AA의 종합 지수에서 GLM-5.2는 최대 추론 설정으로 53점이고, 폐쇄형 최상위는 Claude Opus 5가 63점, Fable 5가 62점, GPT-5.6 Sol이 61점입니다. 저는 GLM-5.3이 이 셋 바로 아래인 58~60점 안팎에 들어올 것으로 봅니다. 다만 이번 개선이 코딩과 에이전트, 사이버에 몰려 있어서, 지식과 수학까지 묶는 종합 지수에는 상승 폭이 덜 반영될 수 있습니다.
기반 모델을 그대로 두고 뒷단만 고친 발표는 2주 사이 이번이 세 번째입니다. 세 회사 모두 무엇을 그대로 뒀는지 모델 카드나 변경 기록에 직접 적었습니다.
| 공개일 | 모델 | 그대로 둔 것 | 대표 점수 변화 |
|---|---|---|---|
| 7월 31일 | 딥시크 V4-Flash 정식판 | 구조와 크기(2,840억 파라미터) | DeepSWE 7.3 → 54.4 |
| 8월 13일 | 구글 제미나이 3.7 Flash | 구조, 학습 데이터, 하드웨어(3.6 Flash와 같음) | DeepSWE 49.0 → 65.3 |
| 8월 14일 | Z.ai GLM-5.3 | 743B 기반 모델 | DeepSWE 46.2 → 66.9 |
딥시크는 V4-Flash 정식판을 두고 4월 프리뷰와 같은 구조와 크기에 후속 학습만 다시 했다고 밝혔고, 구글은 3주 만에 낸 제미나이 3.7 Flash의 구조와 학습 데이터, 하드웨어가 3.6 Flash와 같다고 모델 카드에 적었습니다. 세 모델 모두 같은 기반 위에서 DeepSWE를 15점 넘게 올렸습니다.
칩 사정은 셋이 다릅니다. 즈푸는 수출 통제 명단에 올라 있고 딥시크도 미국의 대중국 수출 통제 때문에 최신 엔비디아 칩을 들여오기 어렵지만, 구글은 자체 TPU를 설계하는 회사입니다. 칩이 넉넉한 회사까지 같은 2주 안에 사전학습을 건너뛴 걸 보면, 이 선택을 칩 부족만으로 설명하기는 어렵습니다. 저는 강화학습 환경을 늘려 얻는 개선이 지금은 새 기반 모델 한 번보다 싸고 빠르게 돌아온다는 계산을 여러 회사가 비슷한 시기에 했다고 봅니다.
같은 시기 중국 오픈웨이트 진영에는 사용 조건이 하나씩 붙고 있고, Z.ai는 여기에 공개 전 안전 평가라는 절차를 더했습니다. 딥시크는 8월 16일부터 피크 시간대 요금을 도입해, 베이징 시각 오전 9시~12시와 오후 2시~6시에는 요금을 두 배로 받습니다. 알리바바는 8월 12일 2.4조 파라미터 Qwen3.8-Max의 가중치를 풀면서, 계열사 합산 연 매출이 5,000만 달러를 넘는 모델 API·AI 업무 도구 사업자에게는 별도 계약을 받게 했습니다.
| 회사 | 새로 붙은 조건 | 시작 |
|---|---|---|
| 딥시크 | 피크 시간대 요금 2배(한국 시각 오전 10시~오후 1시, 오후 3시~7시) | 8월 16일 |
| 알리바바 | Qwen3.8-Max 가중치를 쓰는 연 매출 5,000만 달러 초과 모델 API·AI 업무 도구 사업자는 별도 계약 | 8월 12일 |
| Z.ai | API와 가중치는 안전 평가를 마친 뒤 공개(GLM-5.2는 3일 만에 가중치 공개) | 8월 14일 |
코딩 구독을 쓰는 국내 개발자에게는 바뀌는 설정이 거의 없습니다. 발표 당일부터 GLM-5.2나 GLM-5.1을 부르는 요청은 자동으로 GLM-5.3으로 넘어갔고, 크레딧을 깎는 배율도 GLM-5.2와 같습니다. 이 구독은 피크가 아닌 시간과 주말에 크레딧을 절반만 깎는데, 피크가 한국 시각으로 평일 오후 3시~7시라 업무 시간 후반에 보내는 요청은 그 밖의 시간보다 크레딧을 두 배 씁니다. 여기에 더해 8월 16일부터는 딥시크 API의 피크도 한국 시각 오전 10시~오후 1시와 오후 3시~7시에 걸려서, 두 회사 모델을 낮에 주로 쓰는 국내 팀은 같은 작업을 더 비싼 시간대에 돌리게 됩니다.
API가 열리면 GLM을 붙여 쓰던 팀에는 설정 변경이 따릅니다. Z.ai는 GLM-5.3에서 추론을 끄는 옵션을 없앴다며, thinking.type을 disabled로 보내던 앱은 enabled로 바꾸고 추론 강도를 low로 두지 않으면 요청이 실패한다고 안내했습니다. 추론 강도는 low와 high, max 세 단계이고 기본값은 max입니다.
가중치가 풀리면 자체 서버에서 돌리는 길도 열립니다. 금융과 공공처럼 망을 분리한 조직은 외부 API로 코드와 로그를 내보내기 어려워서, 사내 서버에 올릴 수 있는 오픈웨이트가 남는 선택지입니다. GLM-5.2를 사내에 올려 데이터와 운영 통제권을 쥐려던 수요가 있었는데, 5.3은 같은 크기에 코딩과 보안 점검 능력을 끌어올린 모델입니다. GLM-5.2처럼 MIT 라이선스로 풀릴지는 아직 알 수 없고, 방어하는 쪽이 받는 가중치를 공격하는 쪽도 똑같이 받는다는 점은 GLM-5.2 때와 같습니다.
Z.ai가 밝힌 일정대로라면 가중치는 8월 28일 무렵 허깅페이스에 올라옵니다. 그때부터 AA의 종합 지수와 영국 AISI의 사이버 격차 측정을 같은 조건에서 다시 할 수 있고, 4~7개월로 잰 오픈웨이트와 폐쇄형 모델의 거리가 이번에 얼마나 줄었는지도 그 측정에서 나옵니다.
읽어 주셔서 고맙습니다.
초이 드림