이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
이미지 모델 경쟁의 중심이 한 장을 잘 뽑는 생성에서 고친 뒤 나머지를 지키는 정밀 편집으로 옮겨 간다
8월 8일 스레드의 판단입니다. 다음 판들이 편집 순위와 편집 도구를 앞세우는지로 채점합니다.
grok.com/imagine과 Grok iOS·안드로이드 앱에서 Quality Mode를 고르면 Image 2.0이 돌아갑니다. 발표 당일 API는 열리지 않았고, xAI는 곧 열겠다고만 밝혔습니다.
8월 7일 집계에서 텍스트 투 이미지 점수는 2,722표, 편집 점수는 5,931표로 매겨졌습니다. 1위 GPT Image 2가 받은 표의 25분의 1에서 31분의 1 수준이라 텍스트 투 이미지 순위는 2~3위 범위로 잡혀 있고, 편집은 2위로 고정돼 있습니다. 순위에 오른 것은 (Low)가 붙은 설정입니다.
가리킨 영역만 고치는 매직 완드, 고칠 대상을 고르는 세그멘테이션, 배경 제거, 이미지를 최대 5장까지 받는 멀티 레퍼런스 편집, 9가지 비율로 그림을 다시 짜는 스마트 리사이즈, 작업 15가지를 미리 구성한 템플릿입니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
Grok Build에서 잰 Terminal-Bench 4.0 통과율이 17.7%에서 33.3%로 뛰었습니다. 같은 단가에 AA 지능 지수 과제 하나를 푸는 비용은 1.86달러에서 3.74달러로 늘어, 단가가 5배인 GPT-6 Astra(3.26달러)보다 많아졌습니다.

알리바바 Qwen 팀이 9월 20일 생성부 7B의 이미지 생성·편집 모델 Qwen-Image-2.1 가중치를 공개했습니다. 자체 채점표 29개 모델 가운데 7위로 Nano Banana 2.0보다 0.46점 높았고, 상업 이용에는 별도 라이선스가 필요합니다.
xAI가 8월 12일 Grok 4.6을 공개했습니다. 독립 지수가 4.5보다 5점 올라 GPT-5.6 Sol과 같은 61점이고 가격은 그대로입니다. 다만 비교표에서 1위 Opus 5가 빠졌고, 과제당 토큰이 늘어 과제당 비용은 4.5의 2.3배입니다.
Grok Build에서 잰 Terminal-Bench 4.0 통과율이 17.7%에서 33.3%로 뛰었습니다. 같은 단가에 AA 지능 지수 과제 하나를 푸는 비용은 1.86달러에서 3.74달러로 늘어, 단가가 5배인 GPT-6 Astra(3.26달러)보다 많아졌습니다.
알리바바 Qwen 팀이 9월 20일 생성부 7B의 이미지 생성·편집 모델 Qwen-Image-2.1 가중치를 공개했습니다. 자체 채점표 29개 모델 가운데 7위로 Nano Banana 2.0보다 0.46점 높았고, 상업 이용에는 별도 라이선스가 필요합니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@grokX 게시물 · 원문 보기
발표는 Grok 공식 계정이 한국 시각으로 8일 낮 12시 반에 올렸습니다. 정밀한 편집, 또렷한 글자, 사실에 맞는 내용, 실무에 쓸 만한 결과물을 앞세운 차세대 이미지 모델이라는 소개에, 실제 일에 쓸 이미지를 만든다는 한 줄을 붙였습니다. xAI는 올해 2월 스페이스X와 합병해 지금은 SpaceXAI라는 이름을 쓰고, Arena 순위표에도 SpaceXAI로 올라 있습니다.
발표 페이지는 목표를 세 가지로 적었습니다. 지시를 세부까지 따르는 것, 디자이너처럼 서체와 배치를 먼저 계획해 요소가 많은 그림도 흐트러지지 않고 작은 글씨까지 또렷하게 나오게 하는 것, 사용자가 넣은 요소를 새로 뽑고 고치는 동안 그대로 지키는 것입니다. 본문 소제목도 정밀 편집(Precise editing)이 가장 먼저 나오고 스마트 리사이즈, 성능, 템플릿 순서로 이어집니다.
실제 작업은 여러 번 오갑니다. 처음 생성한 이미지가 최종 결과물이 되는 일은 드뭅니다.— xAI, Imagine Image 2.0 발표문
xAI가 편집 도구를 소개하며 붙인 문장입니다. 광고 시안 한 장을 만들어도 제품 색을 바꾸고, 문구를 고치고, 배경을 갈아 끼우는 요청이 줄줄이 따라옵니다. 그런데 많은 이미지 모델은 한 곳만 고쳐 달라는 요청을 받아도 그림 전체를 다시 그리면서 지시를 반영합니다. 고치라고 하지 않은 얼굴이나 글자가 조금씩 달라지는 일이 여기서 생깁니다.
Image 2.0에 들어간 도구들은 이 문제를 겨냥했습니다. 매직 완드는 사용자가 가리킨 영역만 고치고 나머지는 건드리지 않습니다. 세그멘테이션은 고칠 대상을 정확히 골라 내고, 배경 제거는 피사체만 투명 배경으로 떼어 다른 작업물에 바로 얹게 해 줍니다. 멀티 레퍼런스 편집은 이미지를 최대 5장까지 한 번에 받아 사람이 손으로 합성하던 단계를 줄입니다.
@grokX 게시물 · 원문 보기
스마트 리사이즈는 비율을 고르면 모델이 모자라는 부분을 채워 그림을 다시 짭니다. 발표 페이지는 한 그림을 1:2 세로 배너부터 9:16, 1:1, 16:9를 거쳐 2:1 가로 배너까지 9가지 비율로 다시 짠 예시를 걸었습니다. 같은 광고를 휴대폰 세로 화면용과 가로 배너용으로 따로 만들던 작업이 한 번의 지시로 줄어듭니다.
편집을 생성과 한 모델 안에 묶으려는 시도는 xAI만의 일이 아닙니다. 2주 전 공개된 Black Forest Labs의 FLUX 3도 이미지와 영상, 편집을 하나의 모델로 합쳐, 고칠 때마다 다른 편집 모델로 그림을 넘기던 과정을 없앴습니다.
템플릿은 자주 하는 작업을 미리 구성해 둔 출발점입니다. 사용자는 사진과 요청만 넣고, 작업 순서는 템플릿이 정해 둡니다. xAI가 공개한 15종을 발표 페이지의 분류대로 모으면 다음과 같습니다.
| 분류 | 템플릿 |
|---|---|
| 사진 도구 | 사진 편집, 다시 그리기(Reimagine), 사진 콜라주, 배경 제거·교체, 프로필 사진 |
| 마케팅 | 제품 화보 포스터, 이커머스 사진, UGC(사용자 후기풍) 사진, 굿즈 제작 |
| 제품 | 제품 색상 변경 |
| 디자인 도구 | 마스코트, 아이콘, 캐릭터 스프라이트 |
| 게임 에셋 | 소품·UI 키트 |
| 스트리밍 | 이모지 |
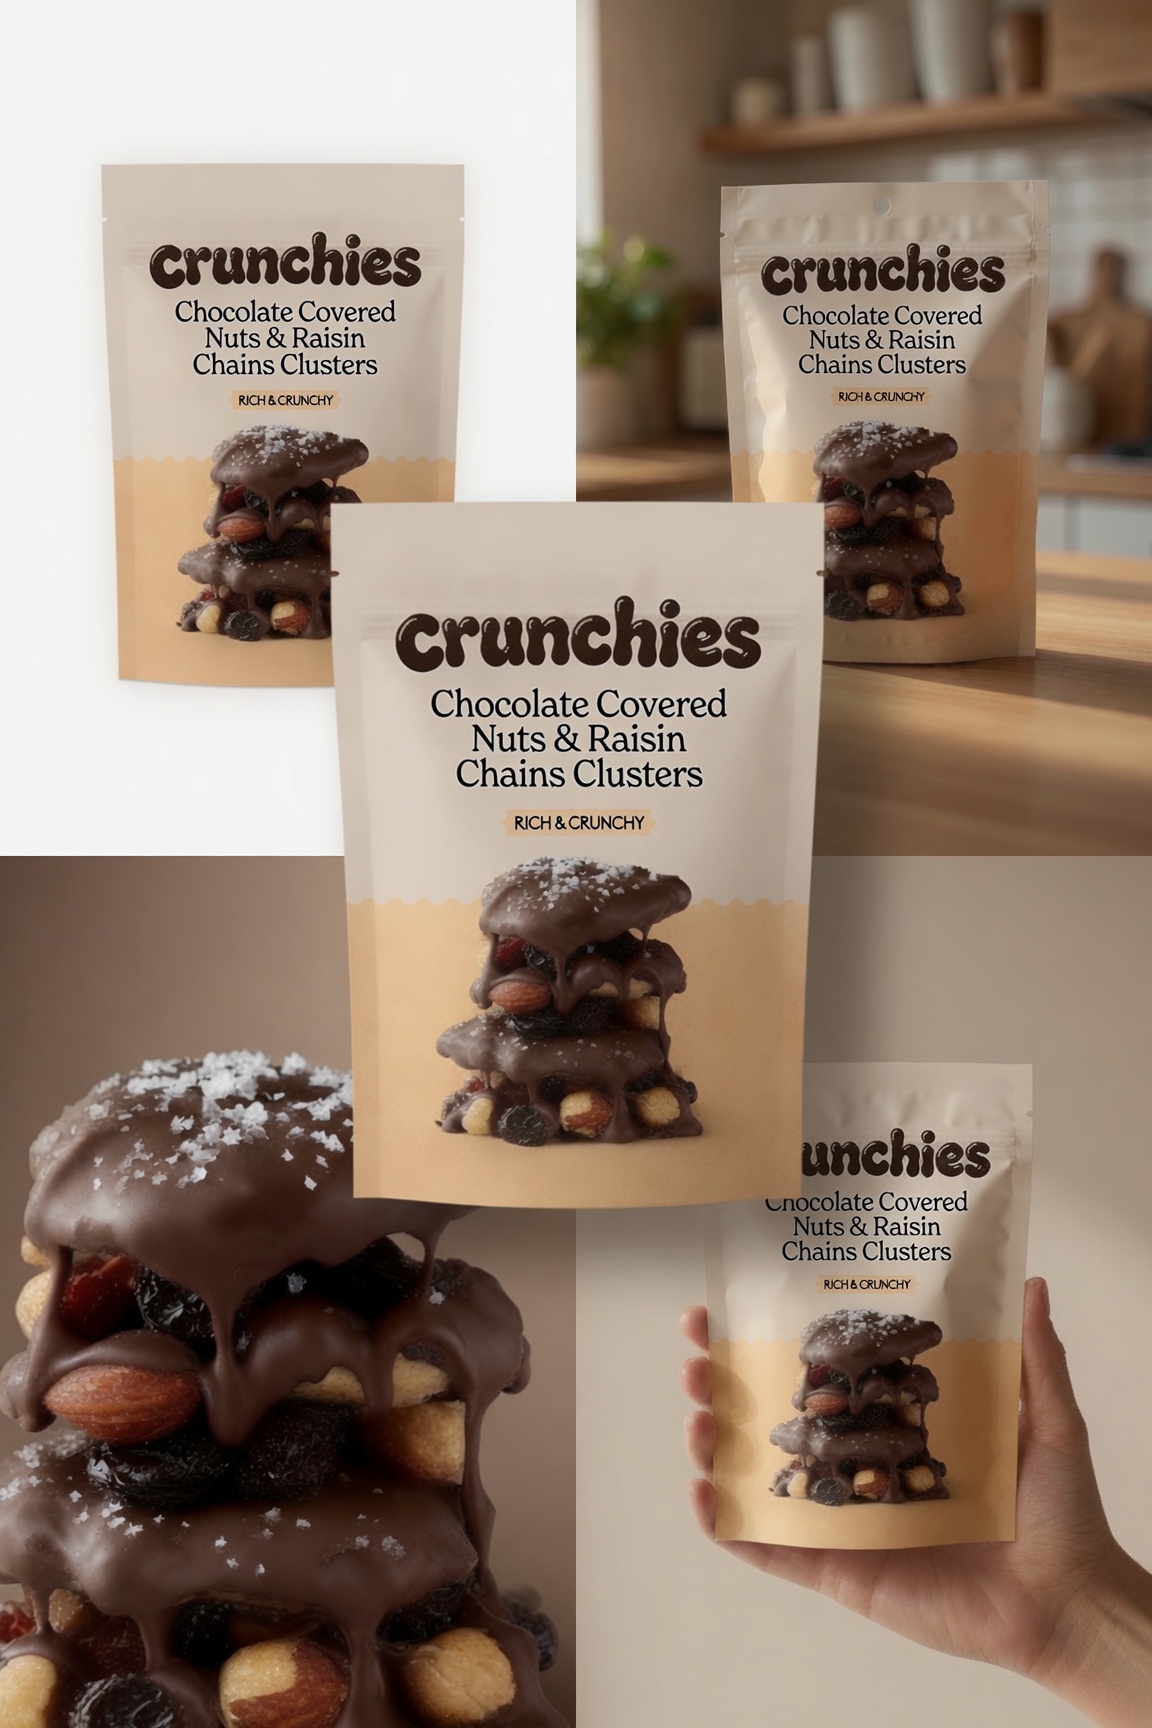
마케팅 4종과 제품 1종을 합치면 15종의 3분의 1이 상품을 팔기 위한 이미지입니다. 이커머스 템플릿 예시는 초콜릿 과자 봉지 하나로 흰 배경 제품 사진, 부엌 선반 연출 사진, 손에 든 사진, 내용물 확대 사진을 한꺼번에 뽑았습니다. 쇼핑몰 상품 페이지에 들어가는 사진 묶음을 통째로 만드는 구성입니다.
발표 페이지 끝에는 영상 제작용 예시도 붙었습니다. 궁수 캐릭터와 얼어붙은 항구, 눈 덮인 진지, 룬이 새겨진 칼과 왕관을 따로 생성하면서도 한 화풍을 유지한 그림 7장입니다. xAI는 일주일 전인 7월 31일 참고 이미지를 넣어 영상을 만드는 Imagine Video 1.5 with References를 냈고, 이번 예시에는 영상에 쓸 세계를 이미지로 먼저 만든다는 설명이 붙었습니다.
Grok Imagine은 지난해 8월 무료 사용자에게까지 열린 이미지·영상 생성 기능이고, 올해 1월에는 영상 생성과 편집을 API로 내놓았습니다. 최근 3개월 사이에만 이미지·영상 발표가 네 번 이어졌고, 언어 모델 쪽에서도 7월 8일 Cursor와 함께 학습한 Grok 4.5를 냈습니다.
| 날짜(미국 시각) | 발표 |
|---|---|
| 5월 6일 | Quality Mode 이미지 생성·편집을 기업 개발자용 API로 제공 |
| 6월 16일 | Grok Imagine Video 1.5 |
| 7월 31일 | 참고 이미지로 영상을 만드는 Imagine Video 1.5 with References |
| 8월 7일 | Imagine Image 2.0, 앱의 Quality Mode를 교체 |
Arena는 사용자가 같은 요청으로 만든 두 그림을 모델 이름을 가린 채 보고 더 나은 쪽을 고르게 합니다. 이 표를 모아 모델마다 점수를 매기는데, 체스의 Elo처럼 점수 차이를 맞대결 승률로 바꿔 읽을 수 있습니다. 8월 7일 집계 기준으로 텍스트 투 이미지 순위표에는 모델 76개에 약 590만 표, 이미지 편집 순위표에는 53개에 약 2,883만 표가 쌓여 있었습니다.
@arenaX 게시물 · 원문 보기
Arena는 Grok 계정의 발표 1시간 18분 뒤 새 모델이 텍스트 투 이미지 2위(1,320점)로 들어왔다고 알렸습니다. 직전 모델 Grok Imagine Image Quality의 14위와 견줘 크게 나아졌다고 적었고, 이 모델은 API로 제공되지 않고 xAI 앱에서만 쓸 수 있다는 설명도 함께 달았습니다.
| 모델 | 회사 | 텍스트 투 이미지 | 이미지 편집 |
|---|---|---|---|
| GPT Image 2 (Medium) | 오픈AI | 1위, 1,380점 | 1위, 1,463점 |
| Grok Imagine Image 2.0 (Low) | xAI | 2위, 1,320점 | 2위, 1,439점 |
| Reve 2.1 | Reve | 3위, 1,302점 | 11위, 1,374점 |
| Muse Image | 메타 | 4위, 1,283점 | 3위, 1,405점 |
| MAI-Image-2.5 | 마이크로소프트 | 9위, 1,256점 | 4위, 1,402점 |
| Seedream 5.0 Pro | 바이트댄스 | 8위, 1,257점 | 5위, 1,393점 |
| Grok Imagine Image Quality(직전 모델) | xAI | 14위, 1,228점 | 7위, 1,390점 |
표는 Arena 순위표의 8월 7일 17시(UTC) 집계입니다. 두 순위표 1위인 GPT Image 2는 오픈AI가 4월 ChatGPT Images 2.0으로 내놓은 모델입니다.
점수 차이로 보면 편집 쪽이 1위에 더 가깝습니다. 텍스트 투 이미지에서 새 모델은 직전 모델보다 92점 올랐지만 1위와 60점 차이가 남았고, 편집에서는 49점 올라 1위와의 차이를 24점으로 줄였습니다. 60점은 두 그림이 맞붙을 때 GPT Image 2가 10번 중 6번쯤(약 59%) 이기는 차이이고, 24점은 약 53%로 반반에 가깝습니다. 텍스트 투 이미지에서 직전 모델과 새 모델이 맞붙으면 새 모델이 약 63%를 가져갑니다.
순위표 전체에 쌓인 표와 새 모델이 받은 표는 다릅니다. 집계 마감인 8월 7일 17시(UTC)는 Grok 계정의 발표보다 10시간 반 앞서고, 새 모델은 공개 전부터 받은 표로 점수가 매겨졌습니다. 텍스트 투 이미지 점수는 2,722표, 편집 점수는 5,931표에서 나왔습니다. 같은 시점 GPT Image 2는 각각 6만 9,194표와 18만 4,189표를 받았으니, 새 모델의 표는 텍스트 투 이미지에서 약 25분의 1, 편집에서 약 31분의 1입니다.
표가 적으면 점수의 오차 범위가 넓어지고, Arena는 이 오차를 순위 범위로 표시합니다. 새 모델의 텍스트 투 이미지 순위는 2~3위로 잡혀 있고, 1,302점의 Reve 2.1도 같은 2~3위 범위에 있습니다. 표가 더 쌓이면 두 모델의 순서가 뒤집힐 수 있다는 표시입니다. 편집 순위는 2위로 고정돼 있고, 3위 메타 Muse Image와의 34점 차이는 두 모델의 오차 범위가 겹치지 않을 만큼 큽니다.
순위표에 오른 이름에도 조건이 붙어 있습니다. Arena에 올라간 것은 이름 뒤에 (Low)가 붙은 설정입니다. xAI 발표문은 (Low)가 무엇을 낮춘 설정인지, 앱의 Quality Mode가 어느 설정으로 도는지 설명하지 않았습니다. 앱에서 받는 그림이 순위표의 그 설정과 같은지 사용자가 확인할 방법도 아직 없습니다.
xAI가 발표 페이지에 건 예시 22장에는 여행 포스터, 서체의 역사를 정리한 인포그래픽, 『오디세이아』 항해 지도처럼 글자가 많은 그림이 여럿 들어 있습니다. 그중 쑤저우 2박 3일 여행 일정표는 시간표와 명소 이름, 한자 표기, 교통 안내까지 한 장에 담았습니다. 졸정원(拙政园), 사자림(狮子林), 쑤저우 박물관(苏州博物馆) 같은 한자 표기는 또렷하게 나왔습니다.
그런데 1일 차 오후 5시 일정의 설명은 「Enjoy local cuisine and the charming」 다음 줄이 「soghu sem entuet viery」라는 뜻 없는 철자로 끝납니다. 2일 차 일정의 저우좡 수향(周庄水乡) 옆에는 1일 차에 나온 산탕제(山塘街) 표기가 한 번 더 붙어 있습니다. 회사가 직접 골라 건 예시에서도 작은 글씨 한 줄과 지명 표기 하나가 어긋났습니다.
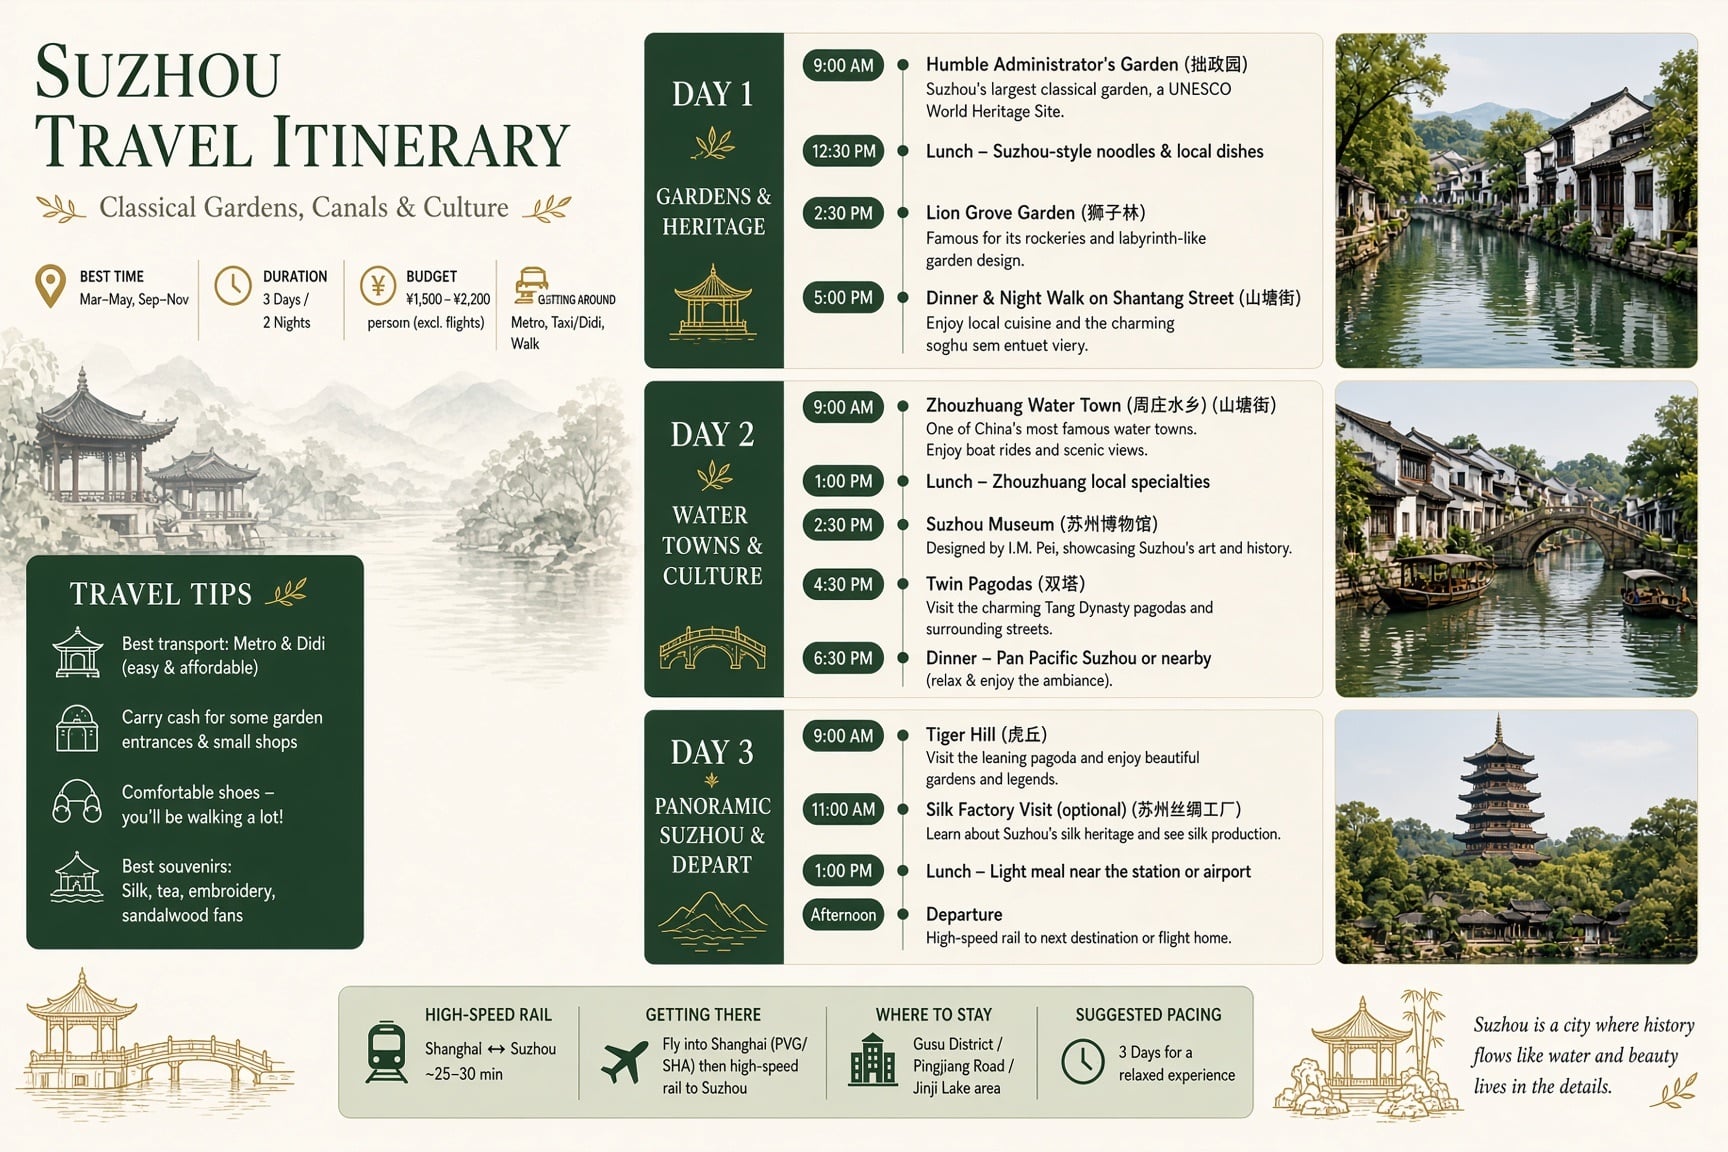
xAI는 이번 모델의 개선점으로 또렷한 글자와 함께 사실에 맞는 내용을 꼽았습니다. 글자가 뭉개진 시안은 한눈에 걸러지지만, 글자는 또렷한데 내용이 틀린 시안은 사람이 한 줄씩 읽어야 찾아냅니다. 쑤저우 일정표의 두 군데도 확대해서 읽기 전에는 잘 보이지 않습니다.
첫날 사용자 반응도 비슷하게 갈렸습니다. 정보가 많은 인포그래픽에서도 제목과 본문 글자가 깨지지 않는다는 사례가 올라왔고, 중국어권에서는 이전 판에서 뭉개지던 한자가 나아졌다는 반응이 나왔습니다. 반면 원하는 부분만 바꾸려 했는데 주변까지 함께 다시 그린다는 반응도 첫날부터 나왔습니다. 매직 완드가 내세운 가리킨 곳만 고친다는 설명과 정면으로 부딪히는 결과입니다.
세부 항목 순위에도 비슷한 대목이 있습니다. Arena의 텍스트 투 이미지 세부 항목에서 새 모델은 아트, 인물, 텍스트 렌더링, 애니메이션, 실사 다섯 항목이 2위였고, 상품·브랜딩·상업 디자인 항목만 3위였습니다. 템플릿의 3분의 1을 상품 판매용으로 채운 모델이 정작 그 항목에서는 순위가 하나 낮았습니다.
grok.com/imagine이나 Grok 앱에서 Quality Mode를 고르면 이제 Image 2.0이 돌아갑니다. 발표 페이지 예시 22장에는 이백의 시 「장진주」 첫 구절을 한자로 쓴 산수화와 일본어 대사를 넣은 만화 페이지까지 있지만, 한글이 들어간 그림은 한 장도 없습니다. 가격과 옵션명, 할인 문구가 한 화면에 들어가는 국내 쇼핑몰 상품 페이지를 이 모델로 만들 수 있을지는 발표 자료만으로는 알 수 없습니다.
API가 열리지 않은 것도 국내 기업에는 걸림돌입니다. 5월 6일부터 기업 개발자에게 API로 팔던 Quality Mode는 직전 모델이라, 국내 서비스가 자기 제품에 붙일 수 있는 것도 발표 당일에는 그 모델까지였습니다. 비용과 속도를 다른 모델과 같은 조건으로 재 보는 일도 API가 열린 뒤에야 가능합니다.
xAI는 API를 곧 열겠다고만 했고 날짜와 가격은 밝히지 않았습니다. 이번 판이 아직 에이전트 단계는 아니라며 1~2주 안에 추가 업데이트가 있다는 말도 덧붙였습니다. Grok Imagine에는 4월 30일부터 웹 베타로 Imagine Agent가 들어가 있는데, 요청 하나를 받아 여러 제품의 사진이나 1분짜리 영상을 알아서 나눠 만드는 기능입니다.
지금 나온 편집 도구는 사람이 영역을 가리키고 한 번씩 지시하는 방식입니다. API와 추가 업데이트가 나오면 다시 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림