이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
최상위 점수대가 오픈AI·앤트로픽·xAI 3자 구도로 굳어지며 가격 경쟁과 출시 주기가 빨라진다
8월 12일 스레드의 전망입니다. xAI가 다음 판에서도 독립 지수 최상위 점수대를 지키는지로 채점합니다.
100만 토큰당 입력 2달러, 출력 6달러로 같습니다. 캐시 읽기 단가는 0.3달러에서 0.5달러로 올랐고, 프롬프트가 20만 토큰에 이르면 그 요청의 모든 토큰에 입력 4달러·캐시 1달러·출력 12달러가 붙습니다. Artificial Analysis가 잰 과제당 비용은 4.5의 0.36달러에서 0.84달러로 늘었습니다.
Artificial Analysis 지능 지수는 Sol과 같은 61점이고 Opus 5(63점)보다 2점 낮습니다. 과제당 비용은 Sol의 약 3분의 2, Opus 5의 약 3분의 1입니다. 저장소를 고치는 DeepSWE와 Terminal-Bench v3.0에서는 Sol과 Fable 5보다 낮습니다.
xAI는 4.5를 바탕으로 더 긴 보충 학습을 돌리고, 4.5로 지도학습 궤적을 다시 만들어 걸러 낸 뒤, 커널 최적화·웹 개발·CAD 같은 에이전트 환경으로 강화학습을 넓혔다고 밝혔습니다. 그 4.5는 Cursor 데이터 수조 토큰으로 학습한 모델입니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
구글이 9월 2일 제미나이 3.8 Flash와 보안용 3.8 Flash Cyber를 공개했습니다. 6주 만의 세 번째 Flash이고, 모델 카드는 구조와 학습 데이터를 3.7 Flash와 같다고 적었습니다. 같은 날 메타 Muse Spark 1.3은 더 높은 지수를 더 싸게 냈습니다.
xAI가 8월 7일 Imagine Image 2.0을 Grok의 새 Quality Mode로 내놓았습니다. 직전 모델이 14위였던 Arena 텍스트 투 이미지 순위에서 2위에 올랐고, 편집 순위에서는 1위 GPT Image 2와 24점 차입니다. API는 곧 열겠다고만 했습니다.
Grok Build에서 잰 Terminal-Bench 4.0 통과율이 17.7%에서 33.3%로 뛰었습니다. 같은 단가에 AA 지능 지수 과제 하나를 푸는 비용은 1.86달러에서 3.74달러로 늘어, 단가가 5배인 GPT-6 Astra(3.26달러)보다 많아졌습니다.
구글이 9월 2일 제미나이 3.8 Flash와 보안용 3.8 Flash Cyber를 공개했습니다. 6주 만의 세 번째 Flash이고, 모델 카드는 구조와 학습 데이터를 3.7 Flash와 같다고 적었습니다. 같은 날 메타 Muse Spark 1.3은 더 높은 지수를 더 싸게 냈습니다.

xAI가 8월 7일 Imagine Image 2.0을 Grok의 새 Quality Mode로 내놓았습니다. 직전 모델이 14위였던 Arena 텍스트 투 이미지 순위에서 2위에 올랐고, 편집 순위에서는 1위 GPT Image 2와 24점 차입니다. API는 곧 열겠다고만 했습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@SpaceXAIX 게시물 · 원문 보기
발표는 SpaceXAI 계정이 한국 시각으로 13일 0시 반에 올렸습니다. 4.5와 같은 가격에 프런티어급 지능을 냈다는 한 줄에 비교표 한 장을 붙였습니다. xAI는 올해 2월 스페이스X와 합병해 지금은 SpaceXAI라는 이름을 쓰고, 5일 전에는 이미지 모델 Imagine Image 2.0을 냈습니다.
xAI는 4.6을 오래 걸리는 에이전트 작업과 인터랙티브·시각 작업에 맞춘 모델로 소개했습니다. 주제를 조사하고, 코드베이스를 오가고, 막연한 제품 구상을 돌아가는 첫 판으로 만드는 일을 여러 단계에 걸쳐 끝까지 붙잡는다는 설명입니다. 긴 작업에서는 다음 단계로 넘어가기 전에 자기 결과를 스스로 시험하는 행동이 늘었다고도 적었습니다.
발표 당일 Cursor와 xAI의 코딩 에이전트 Grok Build, API, OpenRouter·Vercel·Cloudflare에서 쓸 수 있게 됐습니다. 첫 주에는 Grok Build와 Cursor 안의 사용량을 두 배로 줬고, 응답이 빠른 판은 두 배 가격에 따로 팝니다.
AA 지능 지수는 지식 노동 과제(GDPval-AA), 고객 응대 에이전트(τ³-Banking), 터미널 코딩(Terminal-Bench v2.1), 과학 추론(GPQA Diamond) 등 평가 9개를 합친 점수입니다. 8월 12일 기준으로 소수점까지 보면 Grok 4.6은 60.92점, GPT-5.6 Sol은 60.93점이라 반올림한 61점이 같습니다. 이보다 높은 모델은 앤트로픽의 Claude Opus 5(63점)와 Claude Fable 5(62점)입니다.

8월 12일 기준으로 60점을 넘긴 회사가 앤트로픽과 오픈AI 두 곳에서 세 곳으로 늘었습니다. AA는 출시 당일 낸 분석 글에서 이 결과를 이렇게 정리했습니다.
이번 결과로 SpaceXAI는 오픈AI와 함께 지능의 최전선으로 돌아왔고, 앞에는 앤트로픽만 남았습니다.— Artificial Analysis, Grok 4.6 분석 글
AA는 4.6이 4.5보다 5점, Grok 4.3보다 23점 높다고 적었습니다. 4.3의 점수가 38점이었으니 4.3에서 4.6까지 점수가 1.6배가 됐고, 그중 4.5에서 4.6까지는 5주가 걸렸습니다.
xAI는 4.6이 4.5를 바탕으로 만든 모델이라며 학습 과정을 세 단계로 적었습니다. 먼저 4.5보다 긴 보충 학습을 돌리면서, 모델이 생성한 데이터 가운데 추론과 고급 기술 개념을 담은 것을 골라 넣고 품질 좋은 엔지니어링 데이터와 개선한 옵티마이저를 더했습니다. 이 단계가 뒤이은 지도학습과 강화학습의 바탕이 됐다는 설명입니다.
다음 단계에서는 4.5로 지도학습(SFT) 궤적을 다시 만들었습니다. 궤적은 모델이 문제를 풀어 가는 과정을 처음부터 끝까지 적은 모범 답안입니다. 추론 강도와 에이전트 하네스(모델에 도구와 지시를 붙여 일을 시키는 실행 틀), STEM·소프트웨어 공학·지식 노동 분야별로 궤적을 새로 뽑고, 문제 있는 기록은 모델 기반 검사로 걸러 냈습니다. 마지막으로 지식 노동과 일반 코딩, 커널 최적화, 웹 개발, 컴퓨터 지원 설계(CAD) 환경에서 강화학습을 돌렸습니다.
그 4.5는 Cursor와 함께 학습한 모델입니다. Cursor는 7월 4.5를 내놓으며 코드베이스와 소프트웨어 도구를 다루는 사용자 상호작용을 담은 Cursor 데이터 수조 토큰이 학습에 들어갔다고 밝혔습니다. 4.6의 모범 답안을 다시 쓴 모델이 그 데이터로 배운 4.5라서, Cursor 사용 기록은 한 단계를 거쳐 4.6에도 이어집니다.
같은 글에서 Cursor는 4.5 학습 데이터에 Cursor 코드베이스의 옛 스냅샷이 실수로 섞여 4.5가 CursorBench에서 유리했다고 적고, 그 데이터는 다음 모델부터 뺐다고 했습니다. 당시 4.5 발표에서 CursorBench 비교가 빠진 사정은 Grok 4.5를 다룬 글에 있습니다. 이번 4.6 비교표에는 CursorBench v3.2가 다시 들어가 4.6이 69.9%, 4.5가 66.7%로 올라 있습니다.
가격표만 보면 4.5와 같습니다. 그런데 AA가 지능 지수 과제 하나를 풀게 할 때 든 평균 비용은 4.5가 0.36달러, 4.6이 0.84달러로 2.3배입니다. 4.6이 한 과제를 더 오래 붙잡기 때문입니다. 과제 하나에 쓴 출력 토큰이 1만 4,795개에서 2만 1,735개로 47% 늘었습니다.
늘어난 비용은 주로 입력 쪽에서 나왔습니다. 에이전트는 턴마다 지금까지의 대화를 모델에 다시 보내고, 캐시는 이 앞부분을 저장해 두었다가 싸게 다시 읽게 해 주는 기능입니다. 4.6의 캐시 읽기 단가는 100만 토큰당 0.5달러로 4.5의 0.3달러보다 올랐고, 과제당 캐시에서 읽은 양도 2배 남짓으로 늘었습니다. 그 결과 과제당 입력 비용이 0.27달러에서 0.71달러로 뛰어, 4.6의 과제당 비용 0.84달러 가운데 84%를 차지합니다.
같은 점수대 모델과 견주면 여전히 쌉니다. AA가 잰 과제당 비용은 GPT-5.6 Sol이 1.23달러, Claude Opus 5가 2.34달러, Fable 5가 3.14달러이고, 60점에 조금 못 미치는 Kimi K3가 4.6과 같은 0.84달러입니다. 아래 표의 단가는 100만 토큰당 가격이고, 지수와 과제당 비용은 AA가 8월 12일 기준으로 공개한 값입니다.
| 모델 | AA 지능 지수 | 입력 / 출력 단가 | 과제당 비용 |
|---|---|---|---|
| Claude Opus 5 | 63 | 5달러 / 25달러 | 2.34달러 |
| Claude Fable 5 | 62 | 10달러 / 50달러 | 3.14달러 |
| GPT-5.6 Sol | 61 | 5달러 / 30달러 | 1.23달러 |
| Grok 4.6 | 61 | 2달러 / 6달러 | 0.84달러 |
| Kimi K3 | 60 | 3달러 / 15달러 | 0.84달러 |
| Grok 4.5 | 56 | 2달러 / 6달러 | 0.36달러 |
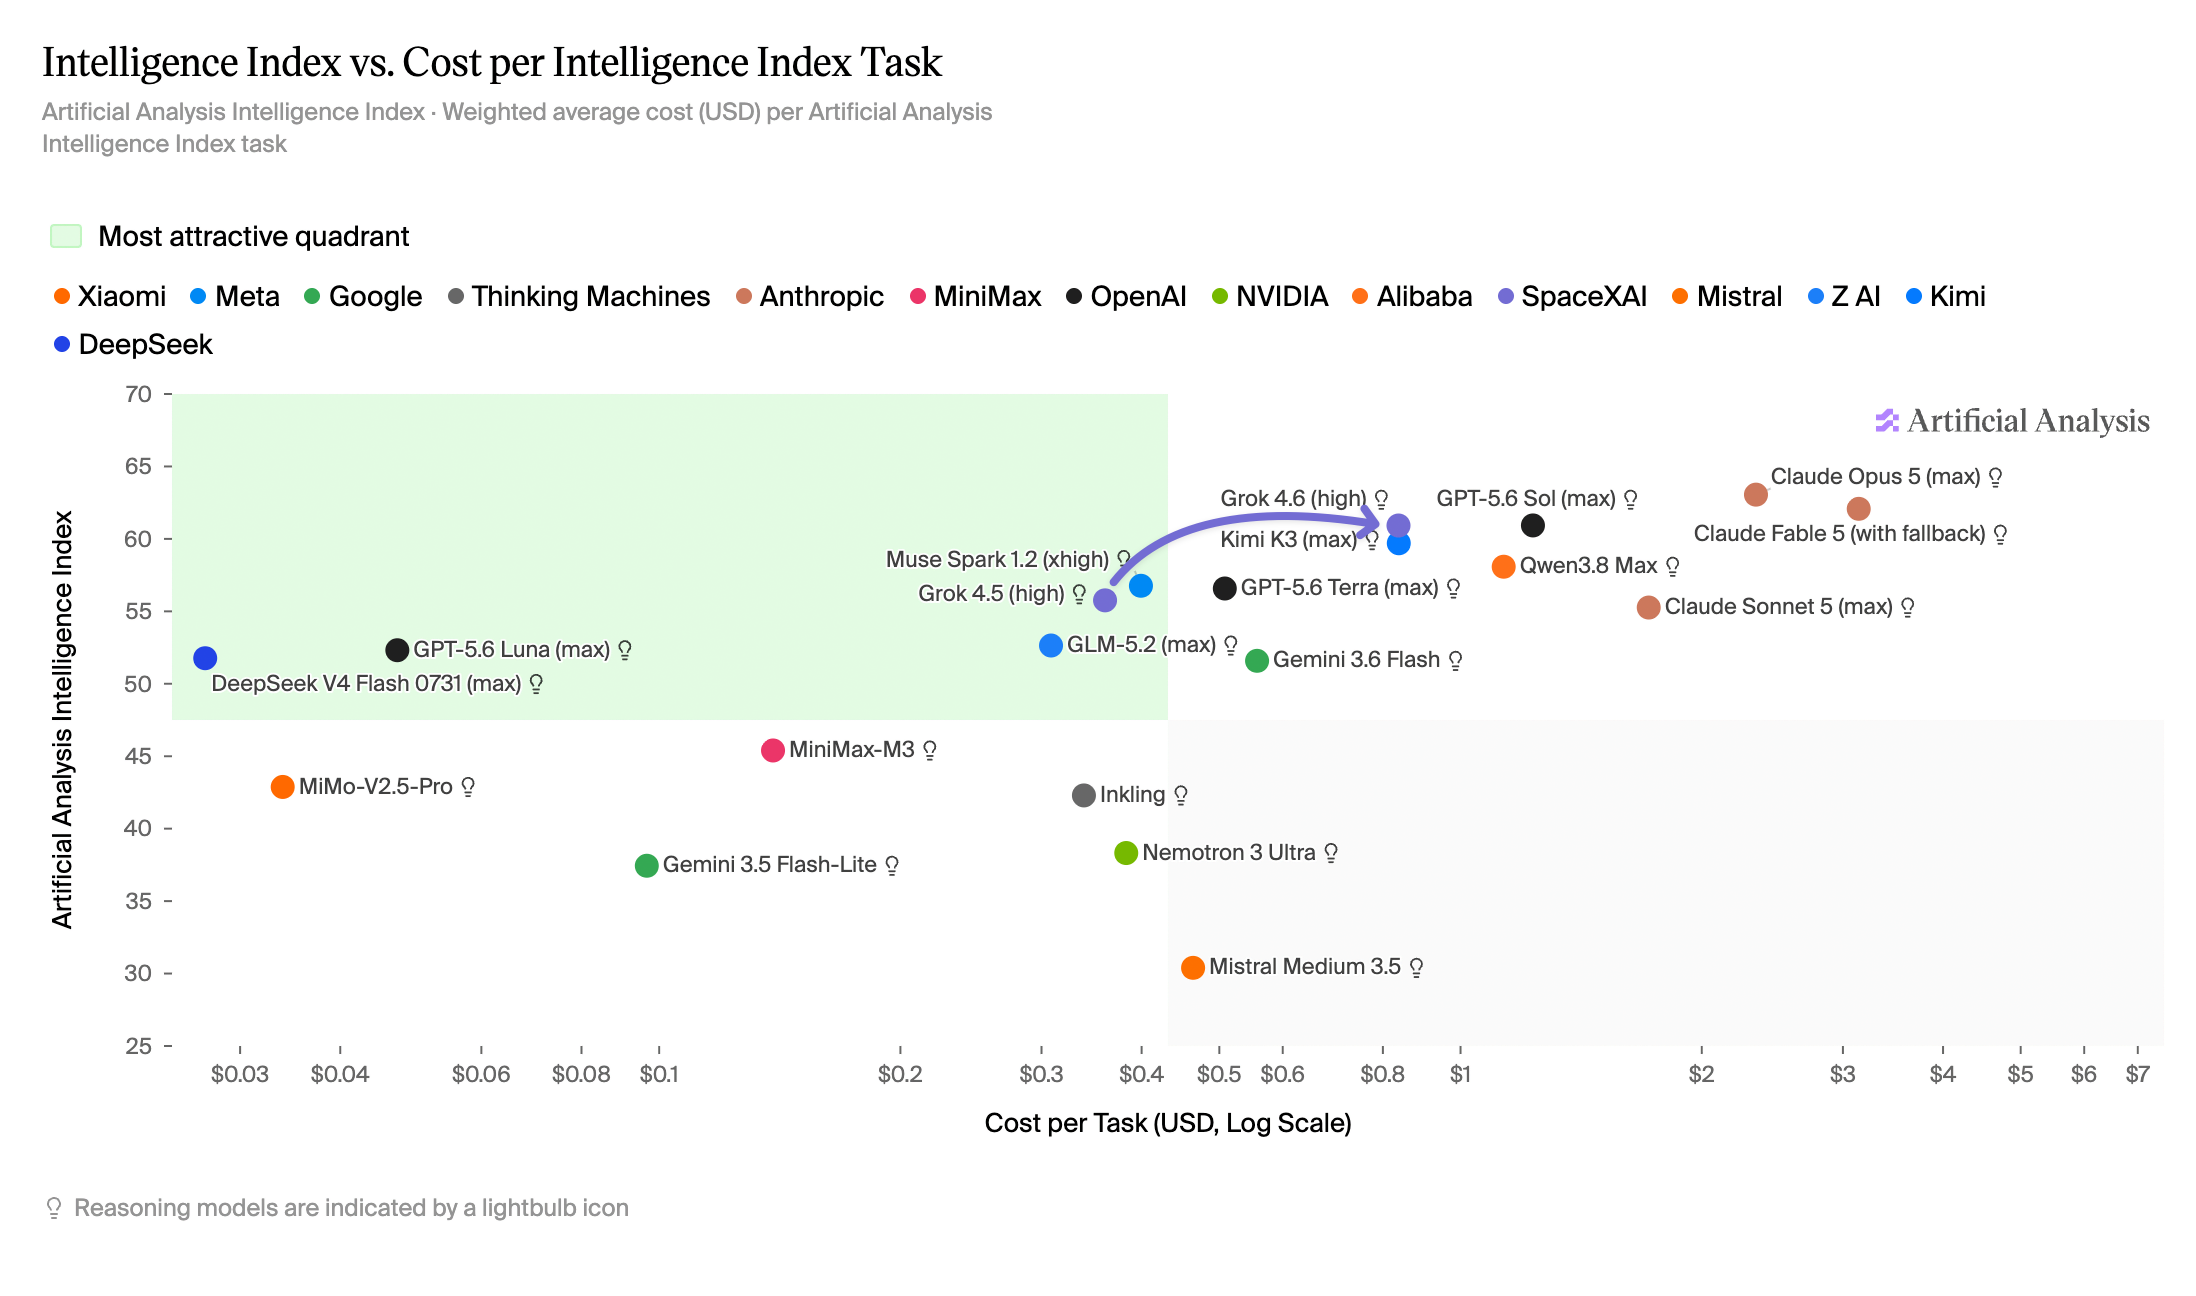
AA는 4.6을 지능 대비 과제당 비용에서 파레토 최적(더 싸면서 점수도 높은 대안이 없는 상태)인 모델로 분류했습니다. 한 세대를 넘기면서 가격표를 그대로 둔 것도 드물다고 적었습니다. 최상위 모델은 지능이 오를 때마다 대개 가격도 함께 올랐기 때문입니다.
2달러와 6달러에는 조건이 하나 더 붙습니다. xAI 가격 문서는 프롬프트가 20만 토큰에 이르면 그 요청에 들어간 모든 토큰에 긴 문맥 요금을 매긴다고 적었습니다. 4.6의 긴 문맥 요금은 입력 4달러, 캐시 1달러, 출력 12달러로 모두 두 배입니다.
넘긴 만큼만 비싸게 받는 방식과 달리, 기준에 닿는 순간 요청 전체의 단가가 두 배가 됩니다. 프롬프트가 19만 9,999토큰인 요청의 입력 요금은 약 0.4달러이고, 20만 토큰이면 0.8달러입니다. 4.6의 컨텍스트 창은 50만 토큰이라, 창의 절반도 채우기 전에 요금이 두 배로 뜁니다. 같은 규칙은 4.5에도 있었고, 이번에 오른 것은 캐시 단가입니다.
발표 직후 X에서는 xAI의 발표 도표가 4.6을 실제보다 앞서 보이게 만든다는 지적이 여러 개발자에게서 나왔습니다. xAI 비교표는 Grok 4.6 High를 4.5 High, GPT-5.6 Sol Max, Fable 5 Max와 견줬습니다. 경쟁사 점수는 각사 시스템 카드나 공개 순위표에서 가져왔고, 자체 보고치와 공개치 가운데 높은 값을 적었다는 각주가 붙었습니다. 비교 대상은 두 회사의 최고 설정인 Max이고, 4.6은 기본 설정인 High입니다.
표에서 4.6이 1위로 표시된 항목은 GDPVal-AA(1,753), AA-Briefcase(1,577), Harvey LAB(15.8%) 셋입니다. 그런데 AA 지능 지수 1위인 Claude Opus 5는 표에 없습니다. AA가 잰 Opus 5(max)는 GDPval-AA 1,849, AA-Briefcase 1,715로 두 평가 모두 4.6보다 높습니다. 아래 표에서 Opus 5 열은 AA가 출시 당일 공개한 값이고, 나머지 열은 xAI 발표표의 값입니다.
| 평가 | Grok 4.6 High | GPT-5.6 Sol Max | Fable 5 Max | Claude Opus 5 (AA 측정) |
|---|---|---|---|---|
| AA 지능 지수 | 61 | 61 | 62 | 63 |
| GDPVal-AA v2 | 1,753 | 1,728 | 1,741 | 1,849 |
| AA-Briefcase | 1,577 | 1,502 | 1,574 | 1,715 |
| DeepSWE v1.1 | 65.9% | 73% | 70% | 없음 |
| Terminal-Bench v3.0 | 26% | 34.6% | 34.1% | 없음 |
| Harvey LAB | 15.8% | 2.5% | 11.3% | 없음 |
표 안에는 작은 불일치도 있습니다. FrontierCode v1.1에서 Fable 5 Max의 점수가 발표 페이지의 표에는 63.6%, SpaceXAI가 X에 올린 표 이미지에는 64.9%로 적혀 있습니다. 어느 쪽이든 4.6의 61.3%보다 높습니다.
코딩에서는 평가마다 결과가 갈립니다. AA가 직접 돌린 Terminal-Bench v2.1에서 4.6은 88.4%로 Opus 5(89.1%) 다음이었습니다. 그런데 xAI 표의 Terminal-Bench v3.0에서는 26%로 GPT-5.6 Sol(34.6%)과 Fable 5(34.1%)에 8%포인트 넘게 뒤졌습니다. v3.0은 표에서 가장 높은 점수도 34.6%에 그치는 판이고, 여기서 차이가 벌어졌습니다.
실제 저장소의 문제를 고치는 DeepSWE v1.1에서도 4.6은 65.9%로 Sol(73%)과 Fable 5(70%)보다 낮습니다. 발표문이 앞세운 긴 작업 능력은 지식 노동 평가에서 Opus 5 다음 수준으로 나타났지만, 코드 저장소를 직접 고치는 평가에서는 아직 두 회사에 못 미칩니다.
AA-Briefcase는 AA가 문제를 공개하지 않는 긴 지식 노동 평가입니다. 4.6은 1,577점으로 Fable 5(1,574)와 비슷했고 Opus 5 계열보다는 낮았습니다. AA가 따로 짚은 것은 효율입니다. 4.6은 평균 약 53턴과 입력 토큰 약 5억 개로 과제를 풀었고, Opus 5(max)는 약 103턴과 약 20억 개를 썼습니다.
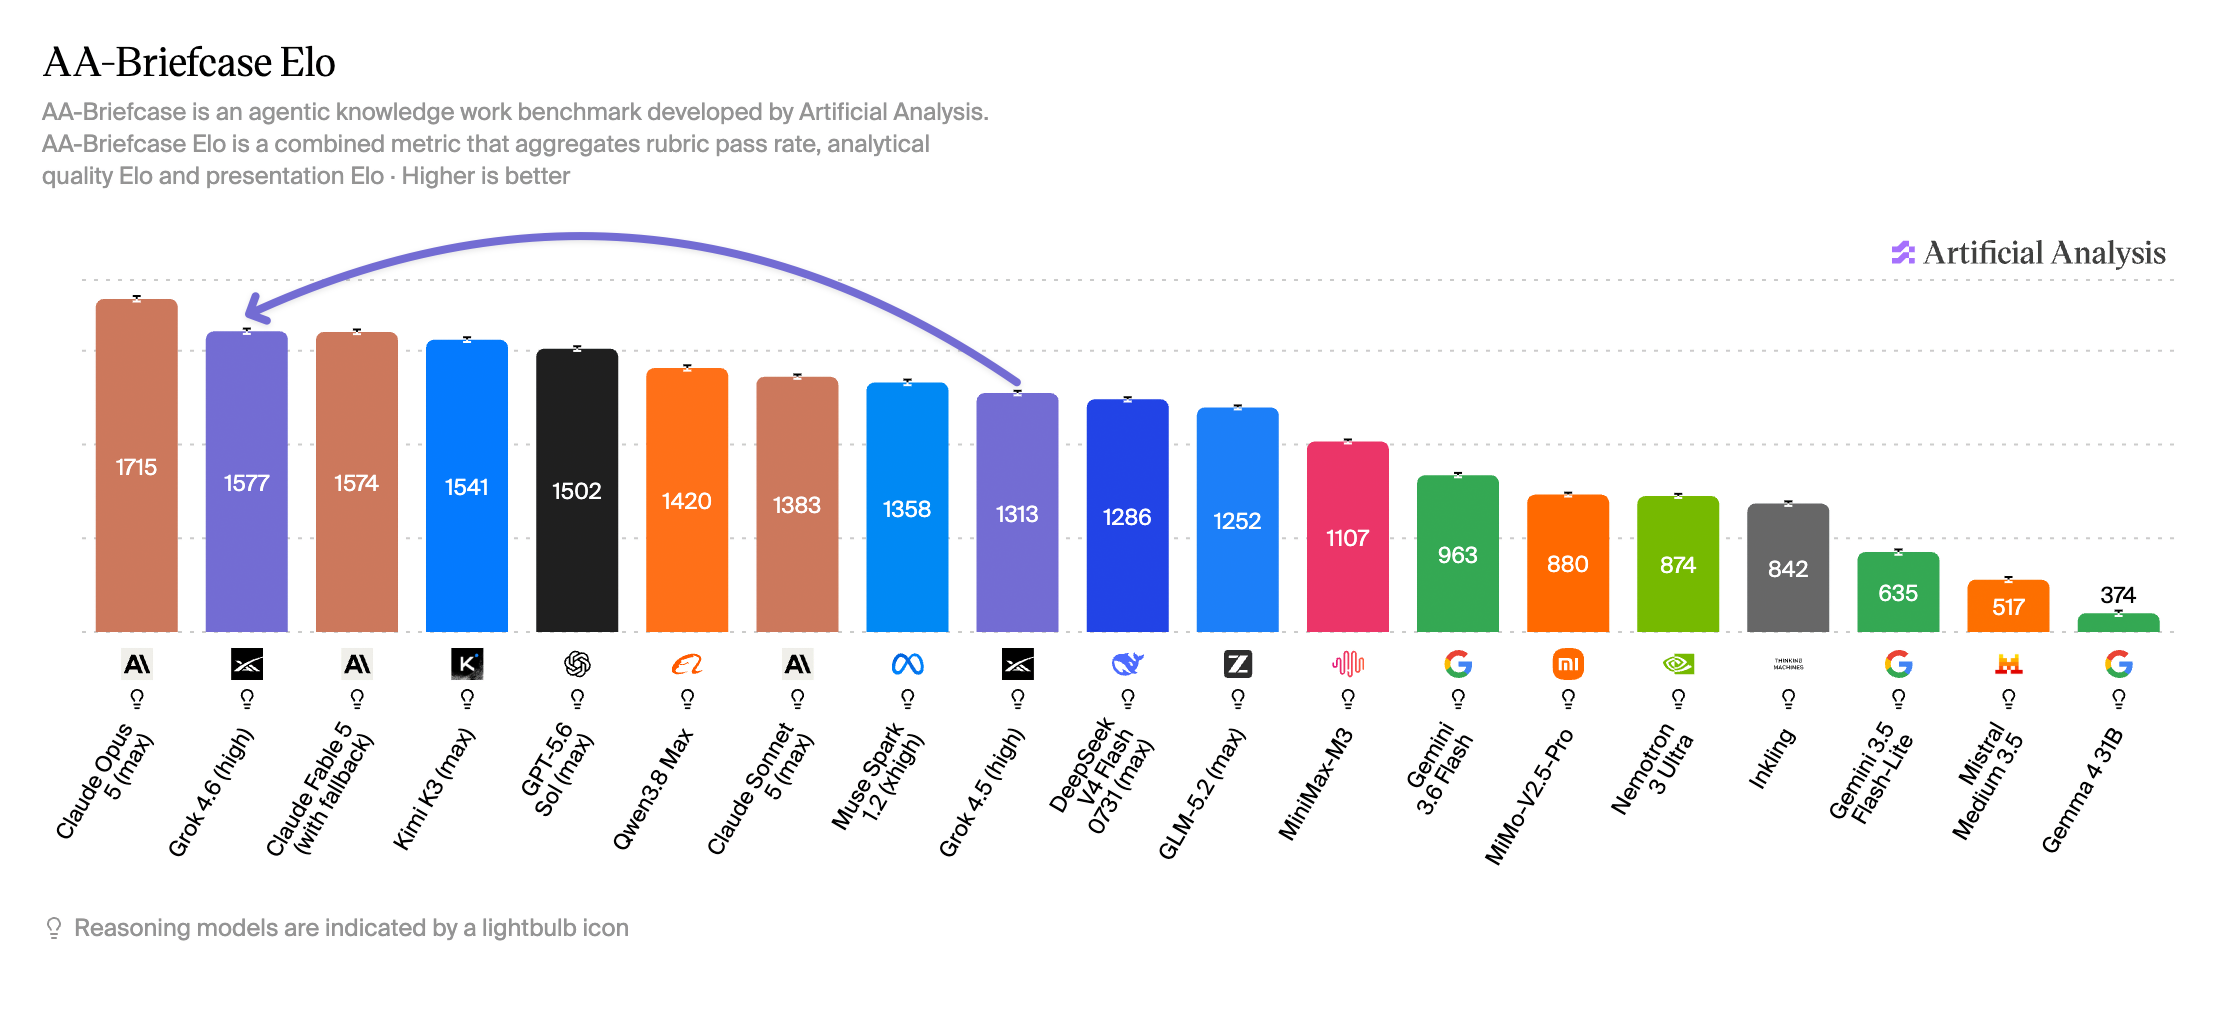
긴 에이전트 작업은 맥락이 빠르게 쌓입니다. 절반의 턴과 4분의 1의 입력 토큰으로 비슷한 답에 이르는 모델은 토큰 단가 이상의 비용 우위를 갖습니다.— Artificial Analysis, Grok 4.6 분석 글
과제당 비용 자료와 이어서 보면, 4.6은 4.5보다 과제를 오래 붙잡아 비용이 늘었고 Opus 5보다는 빨리 끝내 비용이 적습니다. 점수는 여전히 Opus 5가 높습니다.
4.6이 발표 당일 가장 먼저 들어간 곳은 Cursor와 Grok Build입니다. 스페이스X는 6월 16일 Cursor를 전액 주식으로 인수하는 옵션을 행사했다고 밝히면서, 몇 달째 Cursor와 함께 학습한 모델을 곧 Cursor와 Grok Build에 내놓겠다고 적었습니다. 보도에 따르면 거래 규모는 600억 달러이고 3분기에 마무리될 예정입니다.
@SpaceXX 게시물 · 원문 보기
인수 당시 블룸버그는 Cursor 직원들이 이미 몇 주째 xAI 사무실에서 공동 모델을 만들고 있었다고 전했습니다. 거래가 끝나면 모델 회사가 개발자들이 매일 쓰는 편집기를 갖게 되고, 4.5 때처럼 편집기에 쌓인 사용 기록이 학습 데이터로 들어가는 경로도 한 회사 안으로 들어옵니다.
4.6은 예고보다 늦게 나왔습니다. 머스크는 7월 29일에 8월 7일 출시를 예고했다가 8월 4일에는 다음 주로 미뤘고, 8월 11일에는 Cursor 모델 목록에 4.6이 잠깐 올라왔다가 내려갔습니다. 발표 당일에는 다음 판인 Grok 4.7이 지금 나와 있는 모든 모델을 넘어설 것이라고 예고했습니다. 앤트로픽을 훌륭한 회사라고 부르며 곧 더 나은 모델을 낼 것으로 보면서도, SpaceX의 학습 데이터가 독특해 현실 엔지니어링 문제에서 4.7보다 나은 모델이 나오면 놀랄 것이라고 덧붙였습니다.
예고와 실물 사이의 간격은 전에도 있었습니다. 머스크는 지난해 8월 Grok 5를 연내에 내놓겠다고 했고, xAI는 올해 1월 목표보다 많은 200억 달러 규모의 시리즈 E를 마무리하며 Grok 5가 학습 중이라고 밝혔습니다. 같은 발표에서 xAI는 엔비디아와 시스코를 전략 투자자로 들였고, Colossus I·II의 연산이 H100 환산 100만 개를 넘는다고 적었습니다. 그리고 8월에 최상위 점수대에 오른 모델의 이름은 4.6입니다.
Cursor를 쓰는 국내 개발자는 발표 당일부터 모델 목록에서 Grok 4.6을 고를 수 있고, 첫 주에는 사용량이 두 배로 주어졌습니다. API로 붙여 쓰는 경우 출력 단가 6달러는 Opus 5(25달러)의 4분의 1 미만, GPT-5.6 Sol(30달러)의 5분의 1입니다.
계약서 묶음이나 긴 로그처럼 프롬프트가 20만 토큰에 닿는 작업은 요청 전체가 두 배 단가로 계산되고, 에이전트로 오래 돌리는 작업은 턴마다 쌓이는 캐시 비용이 과제당 비용 대부분을 차지합니다. 가격표의 단가 대신 과제 하나를 끝내는 데 드는 돈으로 견주면, AA 기준 4.6은 GPT-5.6 Sol의 약 3분의 2, Opus 5의 약 3분의 1입니다. Grok 4.7이 나오면 xAI 발표표와 AA 측정을 함께 놓고 다시 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림