이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
루프의 실제 실패는 요란하지 않고 조용히 온다
Claude Code 팀은 답을 만든 맥락이 그대로 채점하지 않도록 새 맥락의 두 번째 에이전트에게 코드 리뷰를 맡기라고 권했습니다.
턴 기반은 내 프롬프트로 시작해 Claude가 끝났다고 판단하면 멈추고, 목표 기반(/goal)은 평가 모델이 목표 달성이나 정한 턴 수를 확인할 때 멈춥니다. 시간 기반(/loop, /schedule)은 정해진 간격으로 시작하고, 프로액티브는 이벤트나 일정으로 사람 없이 돌며 작업마다 목표를 이루면 끝납니다.
Claude Code 팀은 모든 일에 복잡한 루프가 필요하지는 않다며 가장 단순한 방법부터 시작하라고 적었습니다. 작은 일에는 여러 에이전트나 루프가 필요 없고, 큰 실행 전에는 작은 범위로 사용량을 먼저 재 보라고 권했습니다.
7월 기준 Claude Code 문서는 한 번 실행에 에이전트를 모두 1,000개까지, 동시에는 16개까지 돌리도록 제한합니다. 5월 발표 글은 일반 세션보다 사용량이 훨씬 많다며 범위를 좁힌 작업부터 시작하라고 권했습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
Pi를 만드는 Earendil이 8월 20일 하네스를 네 부품으로 풀어 쓴 글을 냈습니다. 데이터브릭스 실측에서 같은 모델도 하네스에 따라 작업당 비용이 최대 2.08배 차이 났고, 앤트로픽 기본 캐시 수명 5분을 넘기면 쌓인 대화를 정가로 다시 읽습니다.
앤트로픽 Claude Code 팀이 7월 24일 Opus 5와 Fable 5용 시스템 프롬프트에서 80% 넘게 덜어내도 자사 코딩 평가에서 손실이 없었다고 밝혔습니다. 뒤집은 원칙 여섯 가지와, Free·Pro 기본 모델 Sonnet 5는 언급되지 않았다는 조건을 함께 짚었습니다.
Jev로 PR 한 건을 검토하는 데 0.00007달러, 논문 1,018편을 분류하는 데 0.08달러가 들었습니다. 한데 같은 논문 파이프라인의 요약에는 3.99달러가 들었고, 여러 단계를 거치는 브라우저 과제는 20개 중 1개만 풀었습니다.

Pi를 만드는 Earendil이 8월 20일 하네스를 네 부품으로 풀어 쓴 글을 냈습니다. 데이터브릭스 실측에서 같은 모델도 하네스에 따라 작업당 비용이 최대 2.08배 차이 났고, 앤트로픽 기본 캐시 수명 5분을 넘기면 쌓인 대화를 정가로 다시 읽습니다.

앤트로픽 Claude Code 팀이 7월 24일 Opus 5와 Fable 5용 시스템 프롬프트에서 80% 넘게 덜어내도 자사 코딩 평가에서 손실이 없었다고 밝혔습니다. 뒤집은 원칙 여섯 가지와, Free·Pro 기본 모델 Sonnet 5는 언급되지 않았다는 조건을 함께 짚었습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@ClaudeDevsX 게시물 · 원문 보기
글은 요즘 코딩 에이전트에게 프롬프트를 쓰는 대신 루프를 설계하라는 말이 많은데, X에서 루프가 정확히 무엇인지 찾아보면 답이 제각각이라는 문장으로 시작합니다. 쓴 사람은 Claude Code 팀의 델바 드 올리베이라와 마이클 세그너입니다. 두 사람은 루프를 시작하는 방식, 멈추는 방식, 쓰는 Claude Code 기능, 맞는 작업의 네 가지로 나눠 설명하고, 모든 일에 복잡한 루프가 필요하지는 않으니 가장 단순한 방법부터 시작하라고 적었습니다.
블로그가 올라온 6월 30일, 드 올리베이라는 자기 X 계정에 세 줄을 남겼습니다. 코드를 쓰던 일이 코드를 쓰는 프롬프트를 쓰는 일로, 다시 그 프롬프트를 돌리는 루프를 쓰는 일로 넘어간다는 내용입니다.
@delba_oliveiraX 게시물 · 원문 보기
| 루프 | 시작 | 멈춤 | 사람이 넘기는 것 | 쓰는 기능 |
|---|---|---|---|---|
| 턴 기반 | 내 프롬프트 | Claude가 끝났다고 판단하거나 맥락이 더 필요할 때 | 확인 | 검증 스킬 |
| 목표 기반 | 실시간 프롬프트 | 목표를 이루거나 정한 턴 수에 닿을 때 | 멈춤 조건 | /goal |
| 시간 기반 | 정해진 간격 | 내가 취소하거나 일이 끝날 때(PR 병합, 대기열이 빔) | 시작 시점 | /loop, /schedule |
| 프로액티브 | 이벤트나 일정 | 작업마다 목표를 이루면 끝, 루틴은 끌 때까지 | 지시 자체 | 위의 모든 기능과 동적 워크플로 |
원문 표의 「넘기는 것(You hand off)」 열만 따로 보면 순서가 드러납니다. 턴 기반에서 넘기는 것은 결과를 확인하는 일이고, 목표 기반에서는 언제 멈출지를, 시간 기반에서는 언제 시작할지를, 프로액티브에서는 무엇을 시킬지까지 넘깁니다. 아래 행으로 갈수록 사람이 쥐고 있던 판단이 하나씩 에이전트 쪽으로 옮겨 갑니다.
미국 자동차공학회(SAE)의 자율주행 단계도 기능의 가짓수보다 주행 중 무엇을 사람이 맡고 무엇을 시스템이 맡는지로 나뉩니다. 2단계까지는 사람이 계속 도로를 지켜보고, 3단계부터는 시스템이 운전하다가 요청이 오면 사람이 넘겨받습니다. 저는 네 루프도 같은 방식으로 봤습니다. 단계가 올라갈수록 일은 편해지지만, 잘못됐을 때 사람이 끼어들 수 있는 지점은 그만큼 줄어듭니다.
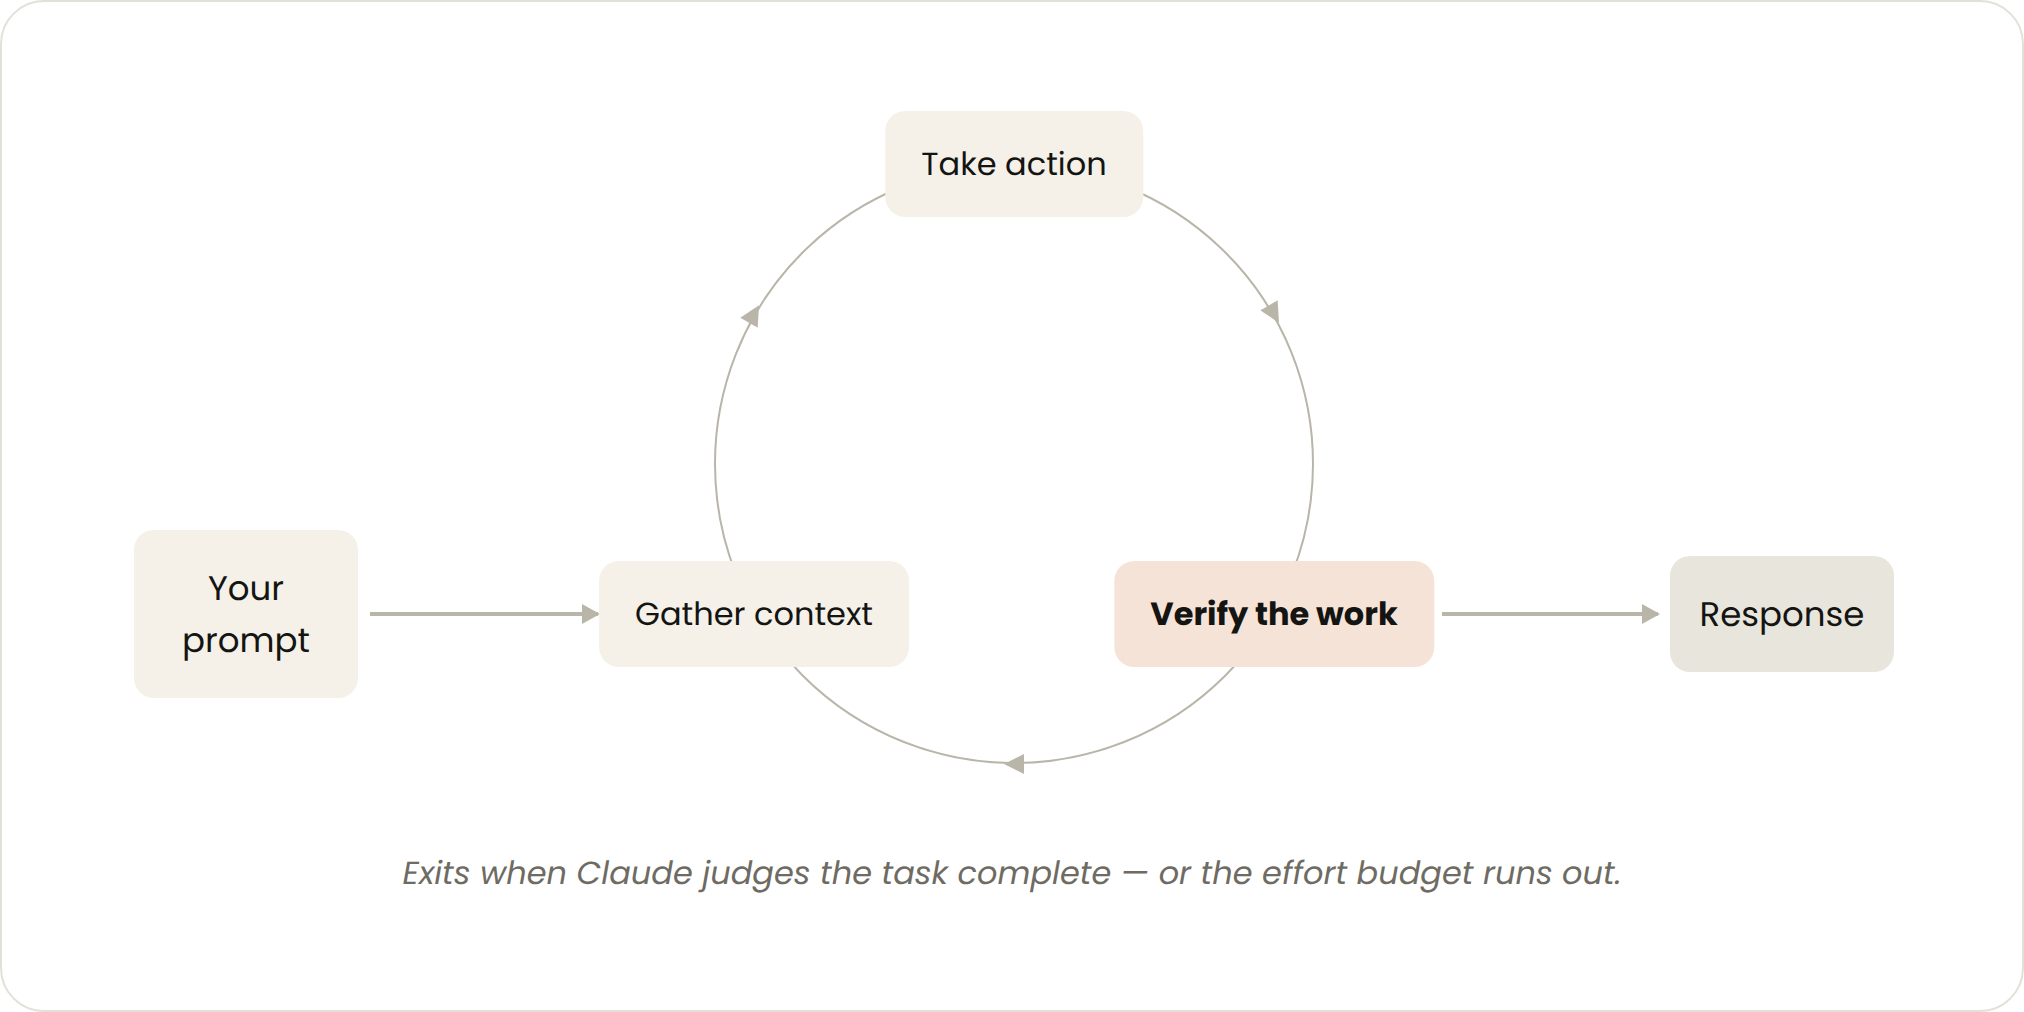
프롬프트를 하나 보내면 Claude는 맥락을 모으고, 행동하고, 결과를 확인하고, 필요하면 다시 돈 뒤에 답합니다. Claude Code 팀은 이것을 에이전트 루프라고 부르고, 매 턴을 사람이 이끄는 수동 루프로 분류했습니다. 좋아요 버튼을 만들어 달라고 하면 Claude가 코드를 읽고 고치고 테스트를 돌려 작동한다고 믿는 결과를 넘기고, 사람이 직접 확인한 뒤 다음 프롬프트를 씁니다.
여기서 넘길 수 있는 것은 확인의 일부입니다. 사람이 손으로 하던 점검을 SKILL.md 파일에 적어 두면 Claude가 자기 결과를 끝까지 더 많이 확인합니다. 원문은 결과를 보고 재고 만져 볼 수 있는 도구나 커넥터를 함께 넣으라고 하고, 점검이 정량적일수록 Claude가 스스로 검증하기 쉽다고 적었습니다.
원문이 예로 든 스킬은 화면 변경을 검증하는 네 단계입니다. 개발 서버를 띄워 고친 화면을 브라우저로 열고, 새 버튼이나 입력창을 직접 눌러 상태가 바뀌는지 전후 화면을 찍고, 브라우저 콘솔에 새 오류나 경고가 하나도 없는지 보고, Chrome DevTools MCP로 성능을 추적해 코어 웹 바이탈을 점검합니다. 한 단계라도 실패하면 고친 뒤 처음부터 다시 돌리고, 절반만 검증한 결과는 넘기지 말라는 문장으로 끝납니다.
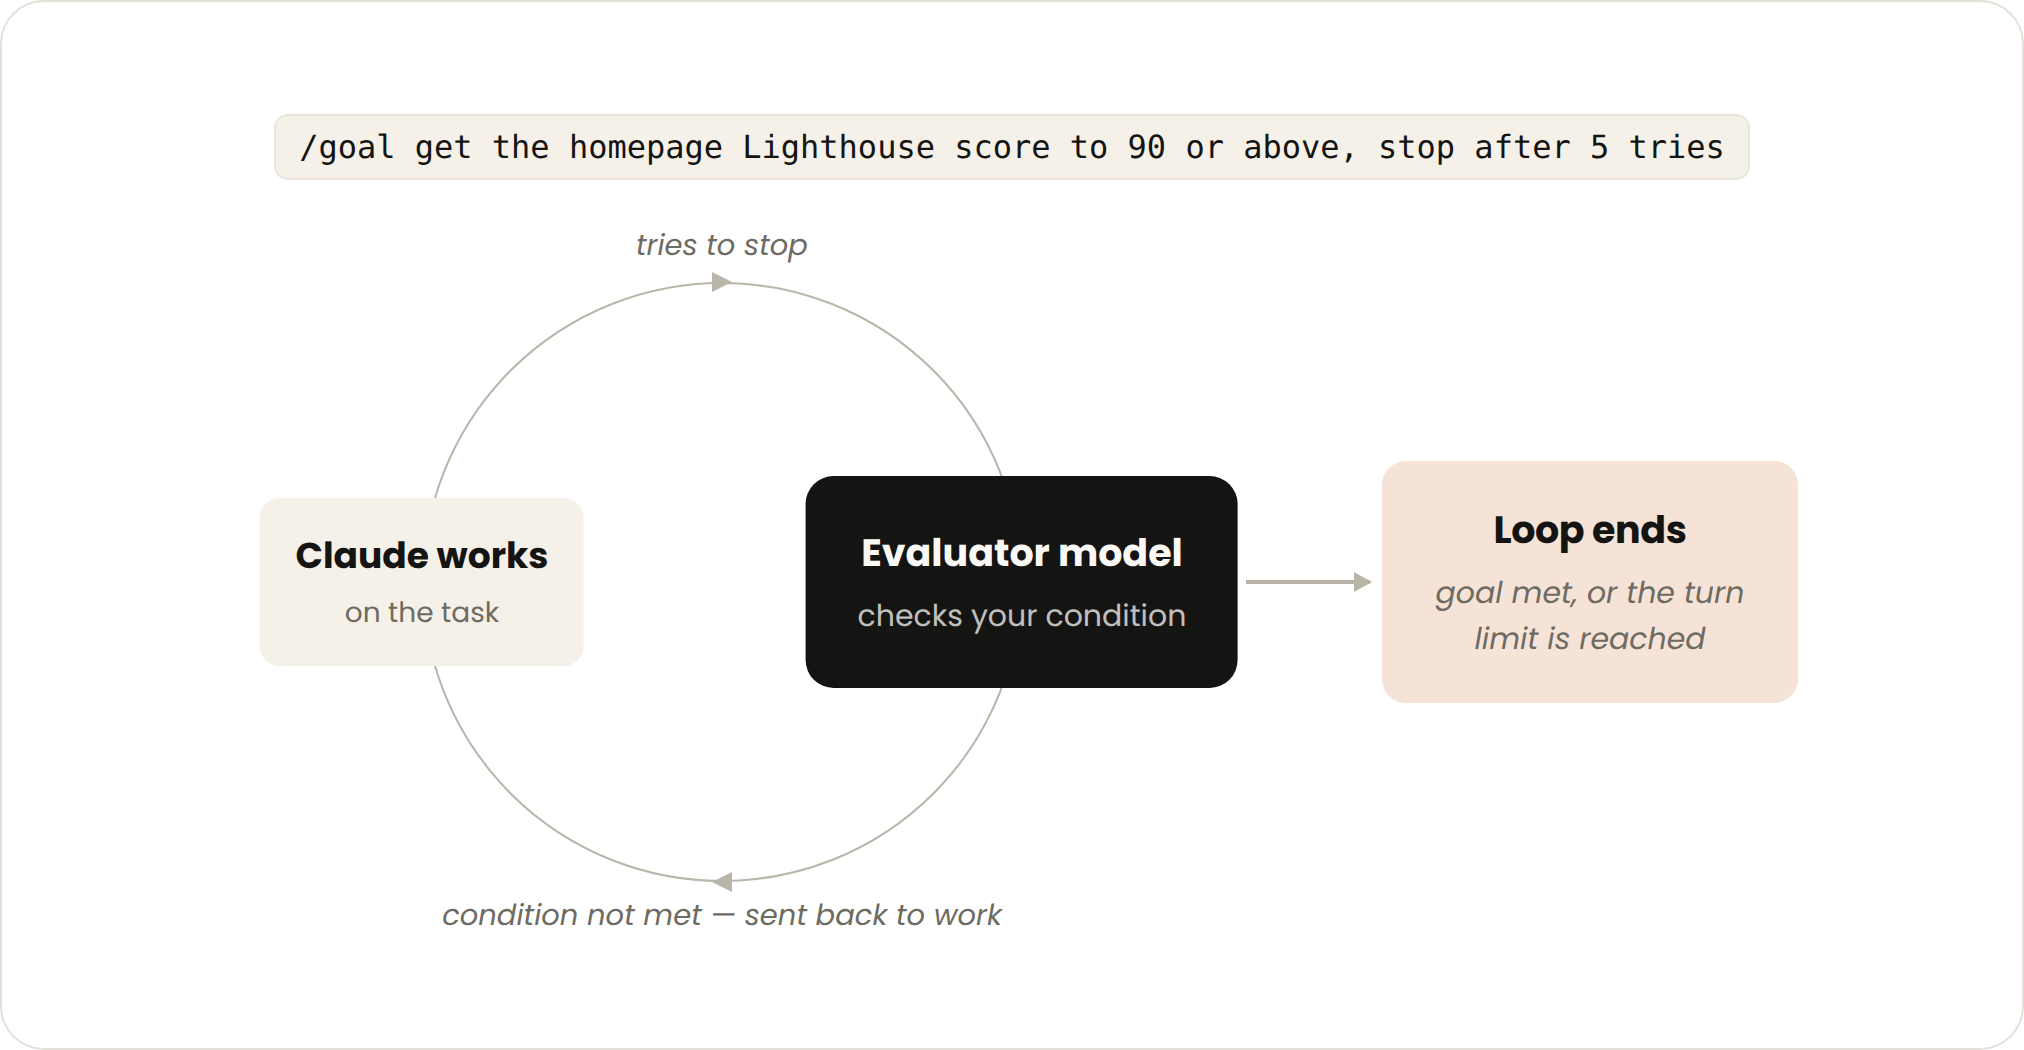
한 턴으로 끝나지 않는 일에는 /goal을 씁니다. 에이전트는 되풀이할 수 있을 때 더 잘하는데, Claude에게 언제 멈출지를 맡기면 이만하면 됐다고 판단해 루프를 일찍 끝낼 수 있습니다. /goal로 성공 조건을 정해 두면 Claude가 멈추려 할 때마다 평가 모델이 그 조건을 확인하고, 조건을 채우지 못했으면 다시 일을 시킵니다. 루프는 목표를 이루거나 사람이 정한 턴 수에 닿으면 끝납니다.
원문의 예시는 「홈페이지 라이트하우스 점수를 90 이상으로 올리고, 다섯 번 시도한 뒤에는 멈춰라」입니다. 통과한 테스트 수나 점수 기준처럼 기계가 참거짓을 가릴 수 있는 조건일수록 잘 작동한다고 원문은 설명합니다. 시도 상한은 비용 관리 수단으로도 적혀 있어서, 조건을 끝내 못 채우는 루프가 계속 돌며 토큰을 쓰는 일을 막습니다.
하는 일은 같고 입력만 바뀌는 일이 있습니다. 매일 아침 슬랙 메시지를 요약하는 일이 그렇고, 리뷰가 달리거나 CI(자동 빌드·테스트)가 깨질 수 있는 PR처럼 바깥 시스템을 주기적으로 확인해 바뀐 것에 반응하는 일도 여기에 들어갑니다. 이런 일에는 프롬프트를 정해진 간격으로 다시 돌리는 /loop를 씁니다.
원문이 든 예는 「/loop 5m 내 PR을 확인하고, 리뷰 코멘트를 반영하고, 깨진 CI를 고쳐라」입니다. /loop는 내 컴퓨터에서 돌기 때문에 컴퓨터를 끄면 멈추고, 클라우드에서 계속 돌리려면 /schedule로 루틴을 만듭니다. 멈추는 때는 사람이 취소하거나 PR이 병합되고 대기열이 비어 할 일이 없어질 때입니다. 비용을 줄이려면 간격을 늘리거나, 시간보다 이벤트에 반응하게 하라고 원문은 권합니다.
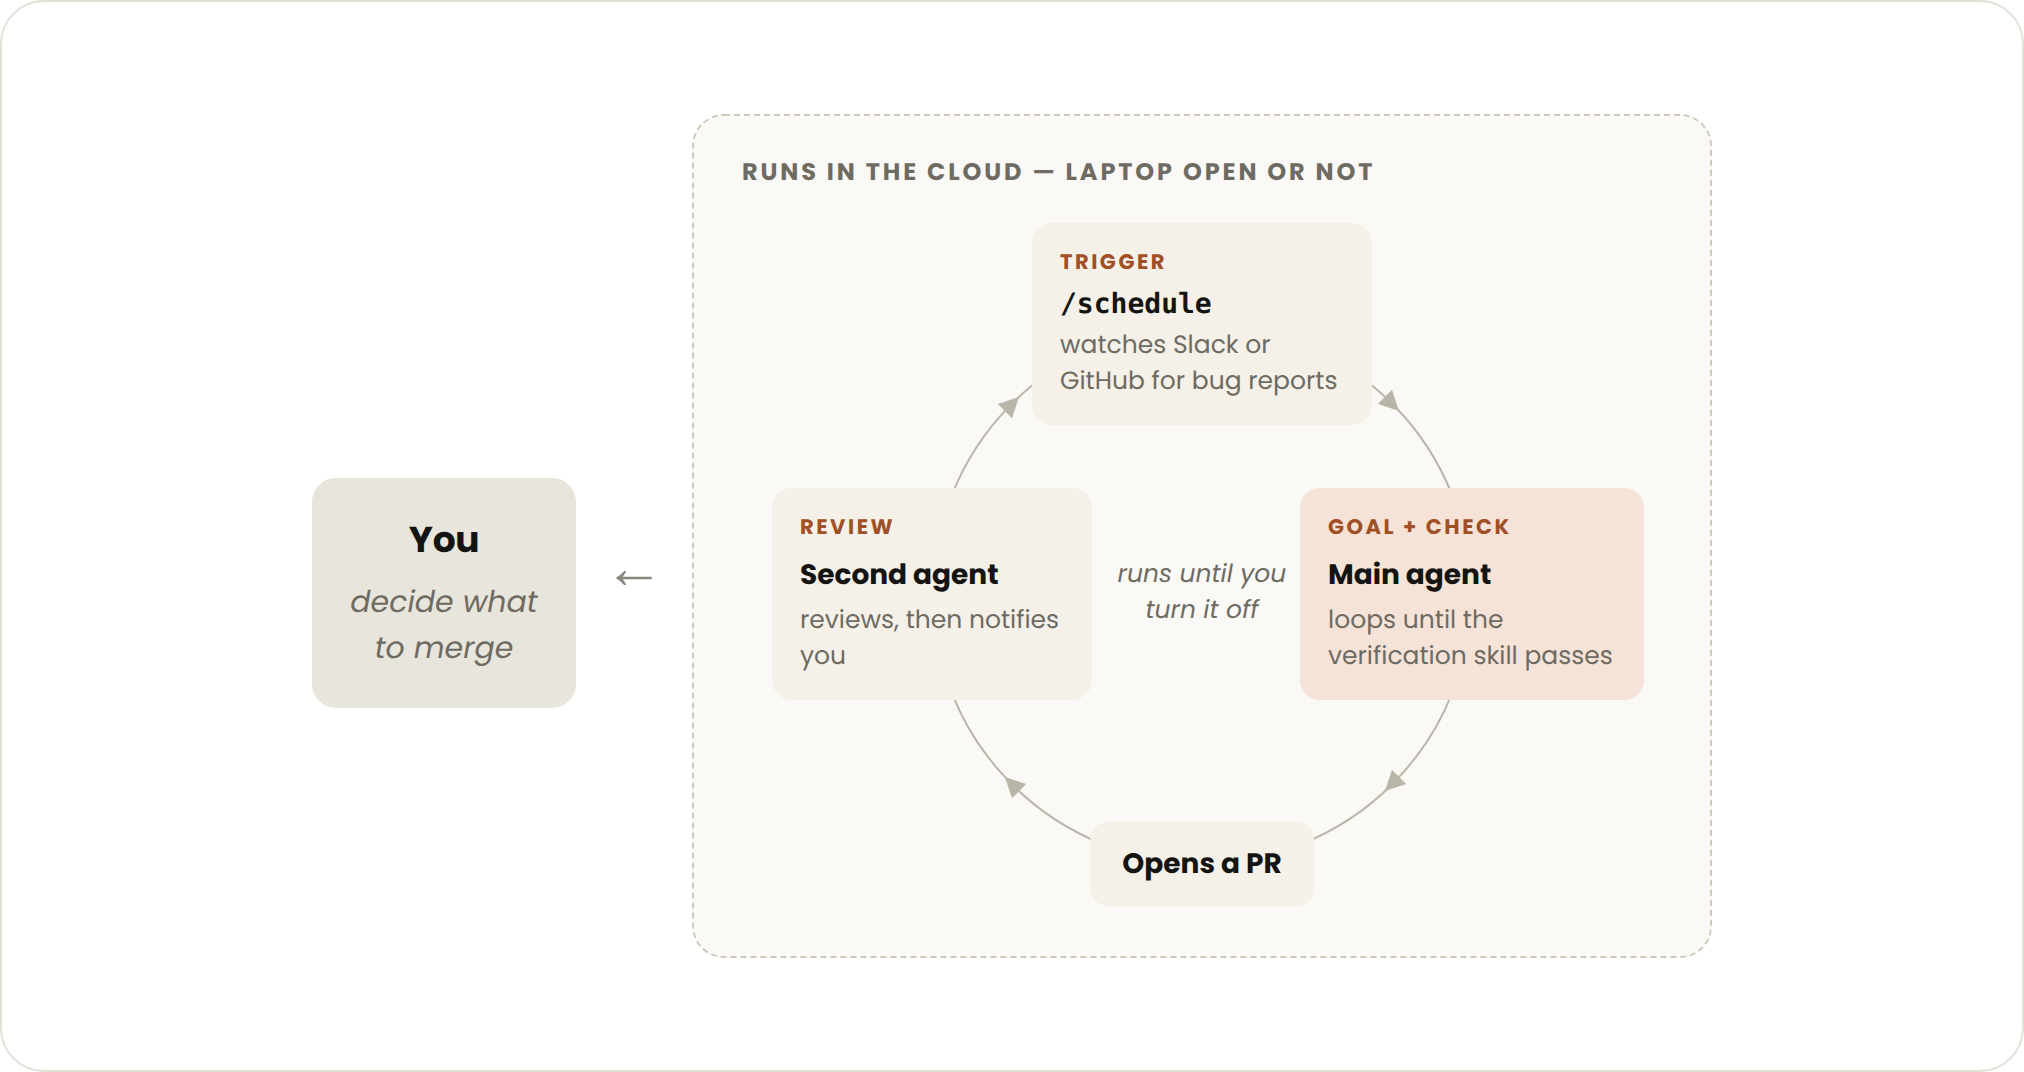
마지막 단계는 이벤트나 일정으로 돌고, 그 순간 사람은 붙어 있지 않습니다. 버그 리포트, 이슈 분류, 마이그레이션, 의존성 업그레이드처럼 잘 정의된 일이 계속 흘러들어올 때 씁니다. 원문은 들어오는 피드백을 처리하는 예로 네 기능을 묶었습니다. /schedule(리서치 프리뷰)로 새 리포트를 확인하는 루틴을 돌리고, /goal과 스킬로 끝의 기준과 검증 방법을 정하고, 동적 워크플로로 리포트마다 분류·수정·검토를 맡을 에이전트들을 지휘하고, 오토 모드로 권한을 묻느라 멈추지 않게 합니다.
원문이 적어 둔 프롬프트는 이렇습니다. 매시간 #project-feedback 채널에서 버그 리포트를 확인하고, 이번 실행에서 찾은 리포트를 모두 분류하고 조치하고 답할 때까지 멈추지 말며, 버그를 고칠 때는 워크플로로 해법 세 가지를 병렬 worktree(저장소의 독립 작업 사본)에서 탐색하고 심사 에이전트가 적대적으로 검토하게 하라는 내용입니다. 비용 관리는 루틴을 작고 빠른 모델로 돌리고 가장 강한 모델은 판단이 필요한 곳에만 쓰는 방식으로 적었습니다.
프로액티브 루프의 일꾼인 동적 워크플로는 앤트로픽이 5월 28일 리서치 프리뷰로 내놓은 기능입니다. Claude가 작업을 계획하고 하위 작업으로 쪼갠 뒤, 스스로 짠 지휘 스크립트로 수십에서 수백 개의 서브에이전트를 한 세션 안에서 병렬로 돌립니다. 에이전트들이 서로 다른 각도에서 문제를 풀고 다른 에이전트가 그 결과를 반박하며, 답이 모일 때까지 되풀이합니다. Max·Team 요금제와 API에서는 기본으로 켜져 있고, Enterprise 요금제는 관리자가 켜야 하며, 아마존 베드록과 구글 버텍스 AI, 마이크로소프트 파운드리에서도 쓸 수 있습니다.
규모에는 제한이 있습니다. 7월 기준 Claude Code 문서는 동시에 도는 에이전트를 최대 16개(CPU 코어가 적으면 더 적게)로, 한 번 실행에서 띄우는 에이전트를 모두 1,000개로 묶어 두었습니다. 문서는 앞의 제한을 로컬 자원을 지키는 장치로, 뒤의 제한을 폭주하는 루프를 막는 장치로 설명합니다.

발표 글에 실린 가장 큰 사례는 Bun입니다. Bun을 만든 재러드 섬너는 동적 워크플로로 Bun을 Zig에서 Rust로 옮겼고, 기존 테스트의 99.8%를 통과하는 약 75만 줄짜리 Rust 코드가 첫 커밋부터 병합까지 11일 만에 나왔습니다. 한 워크플로가 Zig 코드의 구조체 필드마다 알맞은 Rust 수명을 정했고, 다음 워크플로가 .zig 파일마다 동작이 같은 .rs 파일을 썼는데, 수백 개의 에이전트가 병렬로 일하면서 파일마다 검토자 둘을 붙였습니다. 이어 수정 루프가 빌드와 테스트가 깨끗하게 돌 때까지 고쳤고, 발표 시점에 이 코드는 아직 운영에 쓰이지 않았습니다.
발표 글은 동적 워크플로가 일반 Claude Code 세션보다 사용량을 훨씬 많이 쓴다고 두 번 적었습니다. 워크플로가 처음 실행될 때는 무엇이 돌지 보여 주고 확인을 받으며, 조직 관리자는 설정에서 워크플로를 끌 수 있습니다. 루프 글도 동적 워크플로는 에이전트를 수백 개 띄울 수 있으니 큰 실행 전에 작은 범위로 사용량을 먼저 재 보라고 적었습니다.
루프가 내는 결과의 질은 루프를 둘러싼 시스템이 정한다고 원문은 설명합니다. 원문이 꼽은 조건은 넷으로, 코드베이스를 깨끗하게 유지하고(Claude는 이미 있는 패턴과 관례를 따릅니다), 좋은 결과가 무엇인지 스킬로 적어 Claude가 스스로 검증할 수단을 주고, 프레임워크와 라이브러리 문서를 쉽게 찾게 하고, 코드 리뷰는 두 번째 에이전트에게 맡기는 것입니다.
마지막 조건에는 이유가 붙어 있습니다. 새 맥락에서 시작한 검토자는 주 에이전트의 추론에 영향을 받지 않아 덜 편향된다는 설명이고, 기본 제공되는 /code-review 스킬이나 깃허브용 코드 리뷰를 쓰라고 권합니다. 답을 만든 맥락이 그대로 채점하면 자기가 짠 논리를 옳다고 믿고 넘어가기 쉽고, 루프가 높은 단계로 갈수록 그 틀린 결과 위에 다음 작업이 쌓입니다. Bun 이식에서 파일마다 검토자 둘을 붙인 것도 같은 원리입니다.
원문은 결과 하나가 기준에 못 미치면 그 문제만 고치고 끝내지 말고, 이후의 반복 전체가 나아지도록 시스템에 반영하라고 덧붙였습니다. 사람이 판단을 하나씩 넘길 때마다 그 판단을 대신 붙잡을 장치가 스킬 파일과 검토 에이전트의 형태로 저장소에 남는 구조입니다. 모델은 그대로 두고 감싸는 실행 시스템만 바꿔 SWE-bench 점수가 20%에서 50%로 오른 사례는 같은 날 릴리안 웽의 하네스 글에서 다뤘습니다.
원문은 루프에 경계를 두라며 여섯 가지를 적었습니다. 모델과 추론 강도를 고르는 일부터 사용량을 확인하는 명령까지, 루프를 돌리기 전과 도는 중에 쓰는 장치들입니다.
| 원칙 | 원문의 설명 |
|---|---|
| 알맞은 기능과 모델 고르기 | 작은 일에는 여러 에이전트나 루프가 필요 없고, 싸고 빠른 모델로 되는 일이 있음 |
| 성공·멈춤 기준을 분명히 | 끝이 무엇인지 분명해야 너무 늦지도 이르지도 않게 끝남 |
| 큰 실행 전에 시범 | 동적 워크플로는 에이전트를 수백 개 띄울 수 있으니 작은 범위로 먼저 재 봄 |
| 결정론적인 일은 스크립트로 | PDF 스킬에 양식 채우기 스크립트를 넣어 매번 코드를 새로 짜지 않게 함 |
| 루틴을 필요 이상 자주 돌리지 않기 | 지켜보는 대상이 바뀌는 주기에 간격을 맞춤 |
| 사용량 확인 | /usage는 스킬·서브에이전트·MCP별 사용량, 인자 없는 /goal은 턴 수와 토큰, /workflows는 에이전트별 토큰을 보여 줌 |
앞의 실행 화면에서 에이전트 하나가 파일 하나에 4만~5만 토큰을 쓰는 것을 보면, 에이전트 수를 늘리는 결정이 곧 토큰 결정이라는 것이 보입니다. 저는 여기에 한 가지를 더 봅니다. 쓴 토큰 총량보다 병합된 변경 하나당 비용입니다. 이 값이 나빠지는데 에이전트만 늘리면 틀린 결과를 더 빨리 만들 뿐이라, 루프를 넓힐지 구조부터 고칠지를 이 값으로 가늠합니다.
원문은 네 루프의 쓰임새를 설명하지만 숫자는 거의 싣지 않았습니다. 루프가 얼마나 자주 목표에 닿는지, 평가 모델이 조건을 잘못 판단해 루프를 일찍 끝내거나 끝없이 돌리는 일이 얼마나 되는지, 루프 한 번에 토큰이 얼마나 드는지는 나오지 않습니다. 비용 이야기는 원칙 여섯 가지와 사용량 확인 명령으로 대신했습니다.
동적 워크플로 쪽도 사정이 비슷합니다. 발표 글에서 숫자로 공개된 사례는 Bun 이식 하나이고, 그 코드는 발표 시점에 운영에 투입되지 않았습니다. 프로액티브 루프는 오토 모드로 권한 확인 없이 돌기 때문에, 원문 도식에서 사람이 끼어드는 지점은 마지막 병합 결정 하나로 남습니다.
/loop와 /schedule의 차이는 국내 조직에 그대로 걸립니다. /loop는 내 컴퓨터에서 돌고 /schedule 루틴은 클라우드에서 도니, 코드를 외부 클라우드로 보낼 수 없는 조직이라면 시간 기반 루프도 컴퓨터를 켜 두는 방식에 머뭅니다. 동적 워크플로는 아마존 베드록 같은 클라우드에서도 쓸 수 있지만, Enterprise 요금제에서는 관리자가 켜야 하고 사용량이 일반 세션보다 크게 늘어납니다.
어디서 시작할지는 원문이 물음 세 개로 정리했습니다. 이미 하는 일 가운데 사람이 병목인 일 하나를 골라, 검증 절차를 적을 수 있는지, 목표가 충분히 분명한지, 일이 정해진 일정으로 들어오는지를 묻는 것입니다. 물음은 앞에서부터 차례로 턴 기반의 검증 스킬, /goal, /loop와 /schedule에 대응합니다. 원문은 루프를 돌려 보고 어디서 멈춰 서고 어디서 지나치게 나아가는지 지켜보며 고쳐 가라는 말로 끝맺었습니다.
읽어 주셔서 고맙습니다.
초이 드림