이 글 어땠어요?
벤치마크 40점(AAII 25점, NIA 15점), 전문가 평가 35점(개발전략·기술 10점, 개발성과·계획 10점, 파급효과·기여계획 15점), 사용자 평가 25점(AI 전문 사용자 15점, 일반 국민 10점)입니다.
8월 18일 발표에는 영역별 네 팀 평균과 1위·4위 격차만 실렸습니다. 1차 평가 때 공개했던 항목별 1위 팀과 점수도 이번 발표에는 없습니다.
과기정통부는 B200 기준 GPU 지원을 올해 상반기 768장 수준에서 하반기 1,000장 수준으로 늘린다고 밝혔습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
Respan이 9월 24일 행동 판정 전용 모델 Span-01과 공개 평가 자료를 냈습니다. 입력 100만 토큰당 0.02달러에 전체 F1 0.843이고, 평가의 라벨은 프런티어 모델 두 개의 합의로 만들어졌습니다.

롤란드 가브릴레스쿠는 9월 26일 공개된 AI Engineer 발표에서 실패 패턴을 채점 모델과 평가로 바꾸는 루프가 에이전트 제품의 경쟁력이라고 했습니다. 앤트로픽은 같은 생각을 기능 200여 개의 통과 필드로, Cursor는 토큰 비용 7% 절감으로 먼저 쟀습니다.
최태원 SK그룹 회장은 샌프란시스코 AI 서밋 무대에서 젠슨 황은 만날 때마다 칩을 더 달라 하고, 샘 올트먼은 다른 곳에 주지 말고 오픈AI에 직접 달라고 했다고 전했습니다. 같은 무대에서 올트먼은 한국 없이는 AI 혁명이 불가능했다고 말했습니다.
Respan이 9월 24일 행동 판정 전용 모델 Span-01과 공개 평가 자료를 냈습니다. 입력 100만 토큰당 0.02달러에 전체 F1 0.843이고, 평가의 라벨은 프런티어 모델 두 개의 합의로 만들어졌습니다.

롤란드 가브릴레스쿠는 9월 26일 공개된 AI Engineer 발표에서 실패 패턴을 채점 모델과 평가로 바꾸는 루프가 에이전트 제품의 경쟁력이라고 했습니다. 앤트로픽은 같은 생각을 기능 200여 개의 통과 필드로, Cursor는 토큰 비용 7% 절감으로 먼저 쟀습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
과기정통부는 세 팀이 「근소한 차이로」 올라갔다고만 밝히고 팀별 점수는 공개하지 않았습니다. 발표문에 실린 숫자는 평가 영역별 네 팀 평균과 1위·4위 격차, 그리고 네 팀이 상반기에 공개한 모델의 규모와 성적입니다.
| 팀 | 모델 (전체-활성 파라미터) | 발표문의 모델 소개 (각 팀 제공) |
|---|---|---|
| 모티프테크놀로지스 | Motif 3 (314B-A13B) | 미국·중국 밖 AAII 최고 성능, 코딩·에이전트 특화 |
| 업스테이지 | Solar Open2 (250B-A15B) | 문맥 100만 토큰, H200 두 장으로 구동(양자화 버전) |
| SK텔레콤 | A.X K2 (688B-A33B) | 한국어·수학 벤치마크 최고 수준, IMO 2026 금메달 기준 점수 |
| LG AI연구원 | K-EXAONE 2.0 (750B-A37B) | 국내 최대 규모, 아파치 2.0, 10개 언어 |
2차 평가는 벤치마크 40점, 전문가 평가 35점, 사용자 평가 25점으로 짜였습니다. 과기정통부는 이 기준을 네 팀과 충분히 협의해 마련했다고 밝혔습니다.
| 영역 | 배점 | 세부 | 누가 어떻게 |
|---|---|---|---|
| 벤치마크 | 40 | AAII 25 + NIA 15 | AAII는 아티피셜 애널리시스가 9개 평가를 직접 실행, NIA는 문제·정답 비공개 |
| 전문가 평가 | 35 | 개발전략·기술 10 + 개발성과·계획 10 + 파급효과·기여계획 15 | 외부 전문가 10명이 약 일주일 서면평가와 질의응답, 최고·최저점 빼고 평균 |
| 사용자 평가 | 25 | AI 전문 사용자 15 + 일반 국민 10 | 전문 사용자 49명과 국민 185명이 1~5점 절대평가 |
벤치마크 가운데 AAII는 해외 민간 평가 회사 아티피셜 애널리시스가 매기는 종합 지능 지수입니다. 에이전트(GDPval-AA v2, τ³-Banking), 코딩(Terminal-Bench v2.1, SciCode), 일반(AA-LCR, AA-Omniscience), 과학 추론(인류의 마지막 시험, GPQA Diamond, CritPt) 9개 평가로 구성되고, 일부는 문제와 정답을 공개하지 않습니다. 한국지능정보사회진흥원(NIA) 벤치마크는 수학, 지식, 장문 이해, 지시 이행, 한국어, 안전성, 신뢰성 7개 분야를 봅니다.
전문가 평가표는 기술 항목 안에 「기술적 독자성 및 이를 기반으로 한 성능 향상」을 넣고, 독자성을 따지는 예로 하이퍼파라미터 변경 같은 양적 변형부터 모듈·블록 수준의 변형, 데이터 파이프라인 혁신, 아키텍처 혁신까지 적었습니다. 이와 별도로 기술·정책·윤리 세 측면의 독자성 최소 기준을 점검해, 하나라도 못 미치면 체크하는 항목을 두었습니다. 1월 1차 평가에서 네이버클라우드가 떨어진 이유가 이 독자성이었습니다.
사용자 평가는 각 팀이 모델을 붙여 만든 웹사이트에서 이뤄졌습니다. 평가자에게는 질문 작성 안내서가 주어졌고, 화면 디자인보다 모델의 답을 중심으로 평가하라는 지침이 붙었습니다. 전문 사용자로는 AI 스타트업 대표 등 49명이 참여했습니다. 국민 평가단은 7월 28일부터 8월 4일까지 공모해 주민등록인구 통계에 맞춰 성별·연령별로 200명을 뽑았고, 이 가운데 185명이 8월 8일부터 11일까지 네 팀의 모델을 써 보고 점수를 매겼습니다.
국민 평가단은 모집 단계부터 신뢰성 지적을 받았습니다. 7월 29일 매일경제가 평가 대상 기업과 이해관계가 없는지 확인할 절차와 중복 신청을 막을 장치가 보이지 않는다고 보도하자, 과기정통부는 하루 만에 480명 넘게 신청했다며 무작위로 뽑고, 이해관계가 드러나면 점수에서 빼고 민형사상 조치도 할 수 있다는 동의서를 받으며, 중복 여부를 걸러 같은 사람이 두 번 참여할 수 없다고 설명했습니다.
과기정통부는 1월 1차 평가 이후 평가 체계를 세 군데 고쳤다고 설명했습니다. 모델의 성능은 국제적으로 알려진 지수로 재고, 전문가 평가에서는 현장 확산을 더 크게 보고, 사용자 평가에는 일반 국민을 새로 넣었습니다.
| 영역 | 1차 (2026년 1월) | 2차 (2026년 8월) |
|---|---|---|
| 벤치마크 | 팀들이 고른 글로벌 공통·개별 벤치마크 + NIA | AAII + NIA(지시 이행·한국어 추가) |
| 전문가 평가 | 개발성과·계획 15, 파급효과·기여계획 10 | 개발성과·계획 10, 파급효과·기여계획 15 |
| 사용자 평가 | AI 전문 사용자진 | AI 전문 사용자진 + 일반 국민 |
전문가 평가에서 5점이 옮겨 간 파급효과·기여계획 항목은 모델 밖의 실적을 묻습니다. 평가표에 적힌 세부 항목은 국민 AI 접근성 증진 실적과 계획, 전 분야 AX(인공지능 전환) 지원 실적, 모델 공개를 통한 생태계 확장, 대학·스타트업과 국산 AI 반도체 지원, 글로벌 시장 진출 실적입니다. 과기정통부는 이 비중을 늘려 고성능 모델 개발을 넘어 실제 현장 확산을 유도하려 했다고 밝혔습니다.
1차 평가의 개별 벤치마크는 팀이 자기 환경에서 다섯 번 재 평균을 내고, 한국정보통신기술협회(TTA)가 무작위로 재현을 검증하는 방식이었습니다. 이번에는 아티피셜 애널리시스가 직접 쟀습니다. 과기정통부는 AAII가 비정기적으로 문항을 바꾸고 일부 문제를 공개하지 않아 오염이 적고, 최상위 모델도 고득점이 어려운 지수라서 도입했다고 설명했습니다.
영역별 숫자를 나란히 적으면 배점 순서와 격차 순서가 거꾸로 나옵니다. 배점이 가장 큰 벤치마크의 1위·4위 격차는 4.0점, 전문가 평가는 2.4점이고, 배점이 가장 작은 사용자 평가에서 5.0점이 벌어졌습니다.
| 영역 | 배점 | 1차 평균(5팀) | 2차 평균(4팀) | 2차 1위·4위 격차 | 격차 ÷ 배점 |
|---|---|---|---|---|---|
| 벤치마크 | 40 | 30.4 | 22.5 | 4.0 | 10.0% |
| 전문가 평가 | 35 | 28.56 | 28.8 | 2.4 | 6.9% |
| 사용자 평가 | 25 | 20.76 | 17.6 | 5.0 | 20.0% |
벤치마크 평균이 1차의 30.4점에서 22.5점으로 내려간 데는 시험지가 바뀐 영향이 큽니다. 팀마다 고른 벤치마크 대신 최상위 모델도 점수를 잘 못 받는 AAII를 쓰면서 점수대 자체가 내려갔습니다. 전문가 평가는 네 팀 평균이 35점 만점의 82%로 1차와 비슷했고, 1위와 4위가 2.4점 안에 몰렸습니다. 위원 10명의 점수에서 가장 높은 점수와 가장 낮은 점수를 빼고 평균을 내는 방식이라, 한 위원이 한 팀에 유독 높거나 낮은 점수를 줘도 결과에 잘 들어가지 않습니다.
사용자 점수는 1~5점 절대평가를 합산해 전문 사용자 15점, 국민 10점 만점으로 환산한 값입니다. 1차 때는 1위 팀을 만점으로 놓고 나머지를 환산했는데, 이번에도 그렇게 했다면 1위가 25점, 4위가 20점이 되고 평균은 20점을 넘게 됩니다. 평균이 17.6점이니 이번에는 만점 기준의 비례 환산으로 보이고, 그렇다면 5.0점 차이는 두 평가단을 합친 5점 척도 평균으로 1점 차이입니다. 「보통」과 「우수」 사이가 1점입니다.
벤치마크 격차가 4.0점에 머문 이유는 AAII 점수가 배점으로 옮겨지는 과정에서 짐작됩니다. 아티피셜 애널리시스가 공개한 AAII 점수는 모티프 3가 47점, Solar Open2가 37점, A.X K2가 35점, K-EXAONE 2.0이 31점으로 1위와 4위 사이가 16점입니다. 100점 만점의 지수를 25점 배점에 비례해 옮기면 이 차이는 4점 남짓이 되고, 나머지 15점은 문제와 정답이 공개되지 않은 NIA 벤치마크가 채웁니다.
모티프가 AAII에서 얻은 우위를 벤치마크 영역에서 지켰다면, 그보다 큰 점수를 전문가 평가나 사용자 평가에서 잃었다는 계산이 나옵니다. 어느 영역에서 얼마나 뒤졌는지는 팀별 점수가 공개돼야 확인됩니다.
모티프테크놀로지스는 1차 평가 뒤 열린 추가 공모에서 트릴리온랩스와 경쟁해 2월 20일 네 번째 정예팀으로 합류했습니다. 과기정통부는 기존 팀과 같은 수준으로 B200 GPU 768장과 데이터 구축·구매 비용을 지원했고, 기존 세 팀이 1월부터 6월까지 개발한 것처럼 모티프에도 2월부터 7월까지 같은 6개월을 줬습니다. 다른 세 팀은 여기에 앞서 지난해 8월부터 12월까지 1차 개발을 거쳤습니다.
@motif_techX 게시물 · 원문 보기
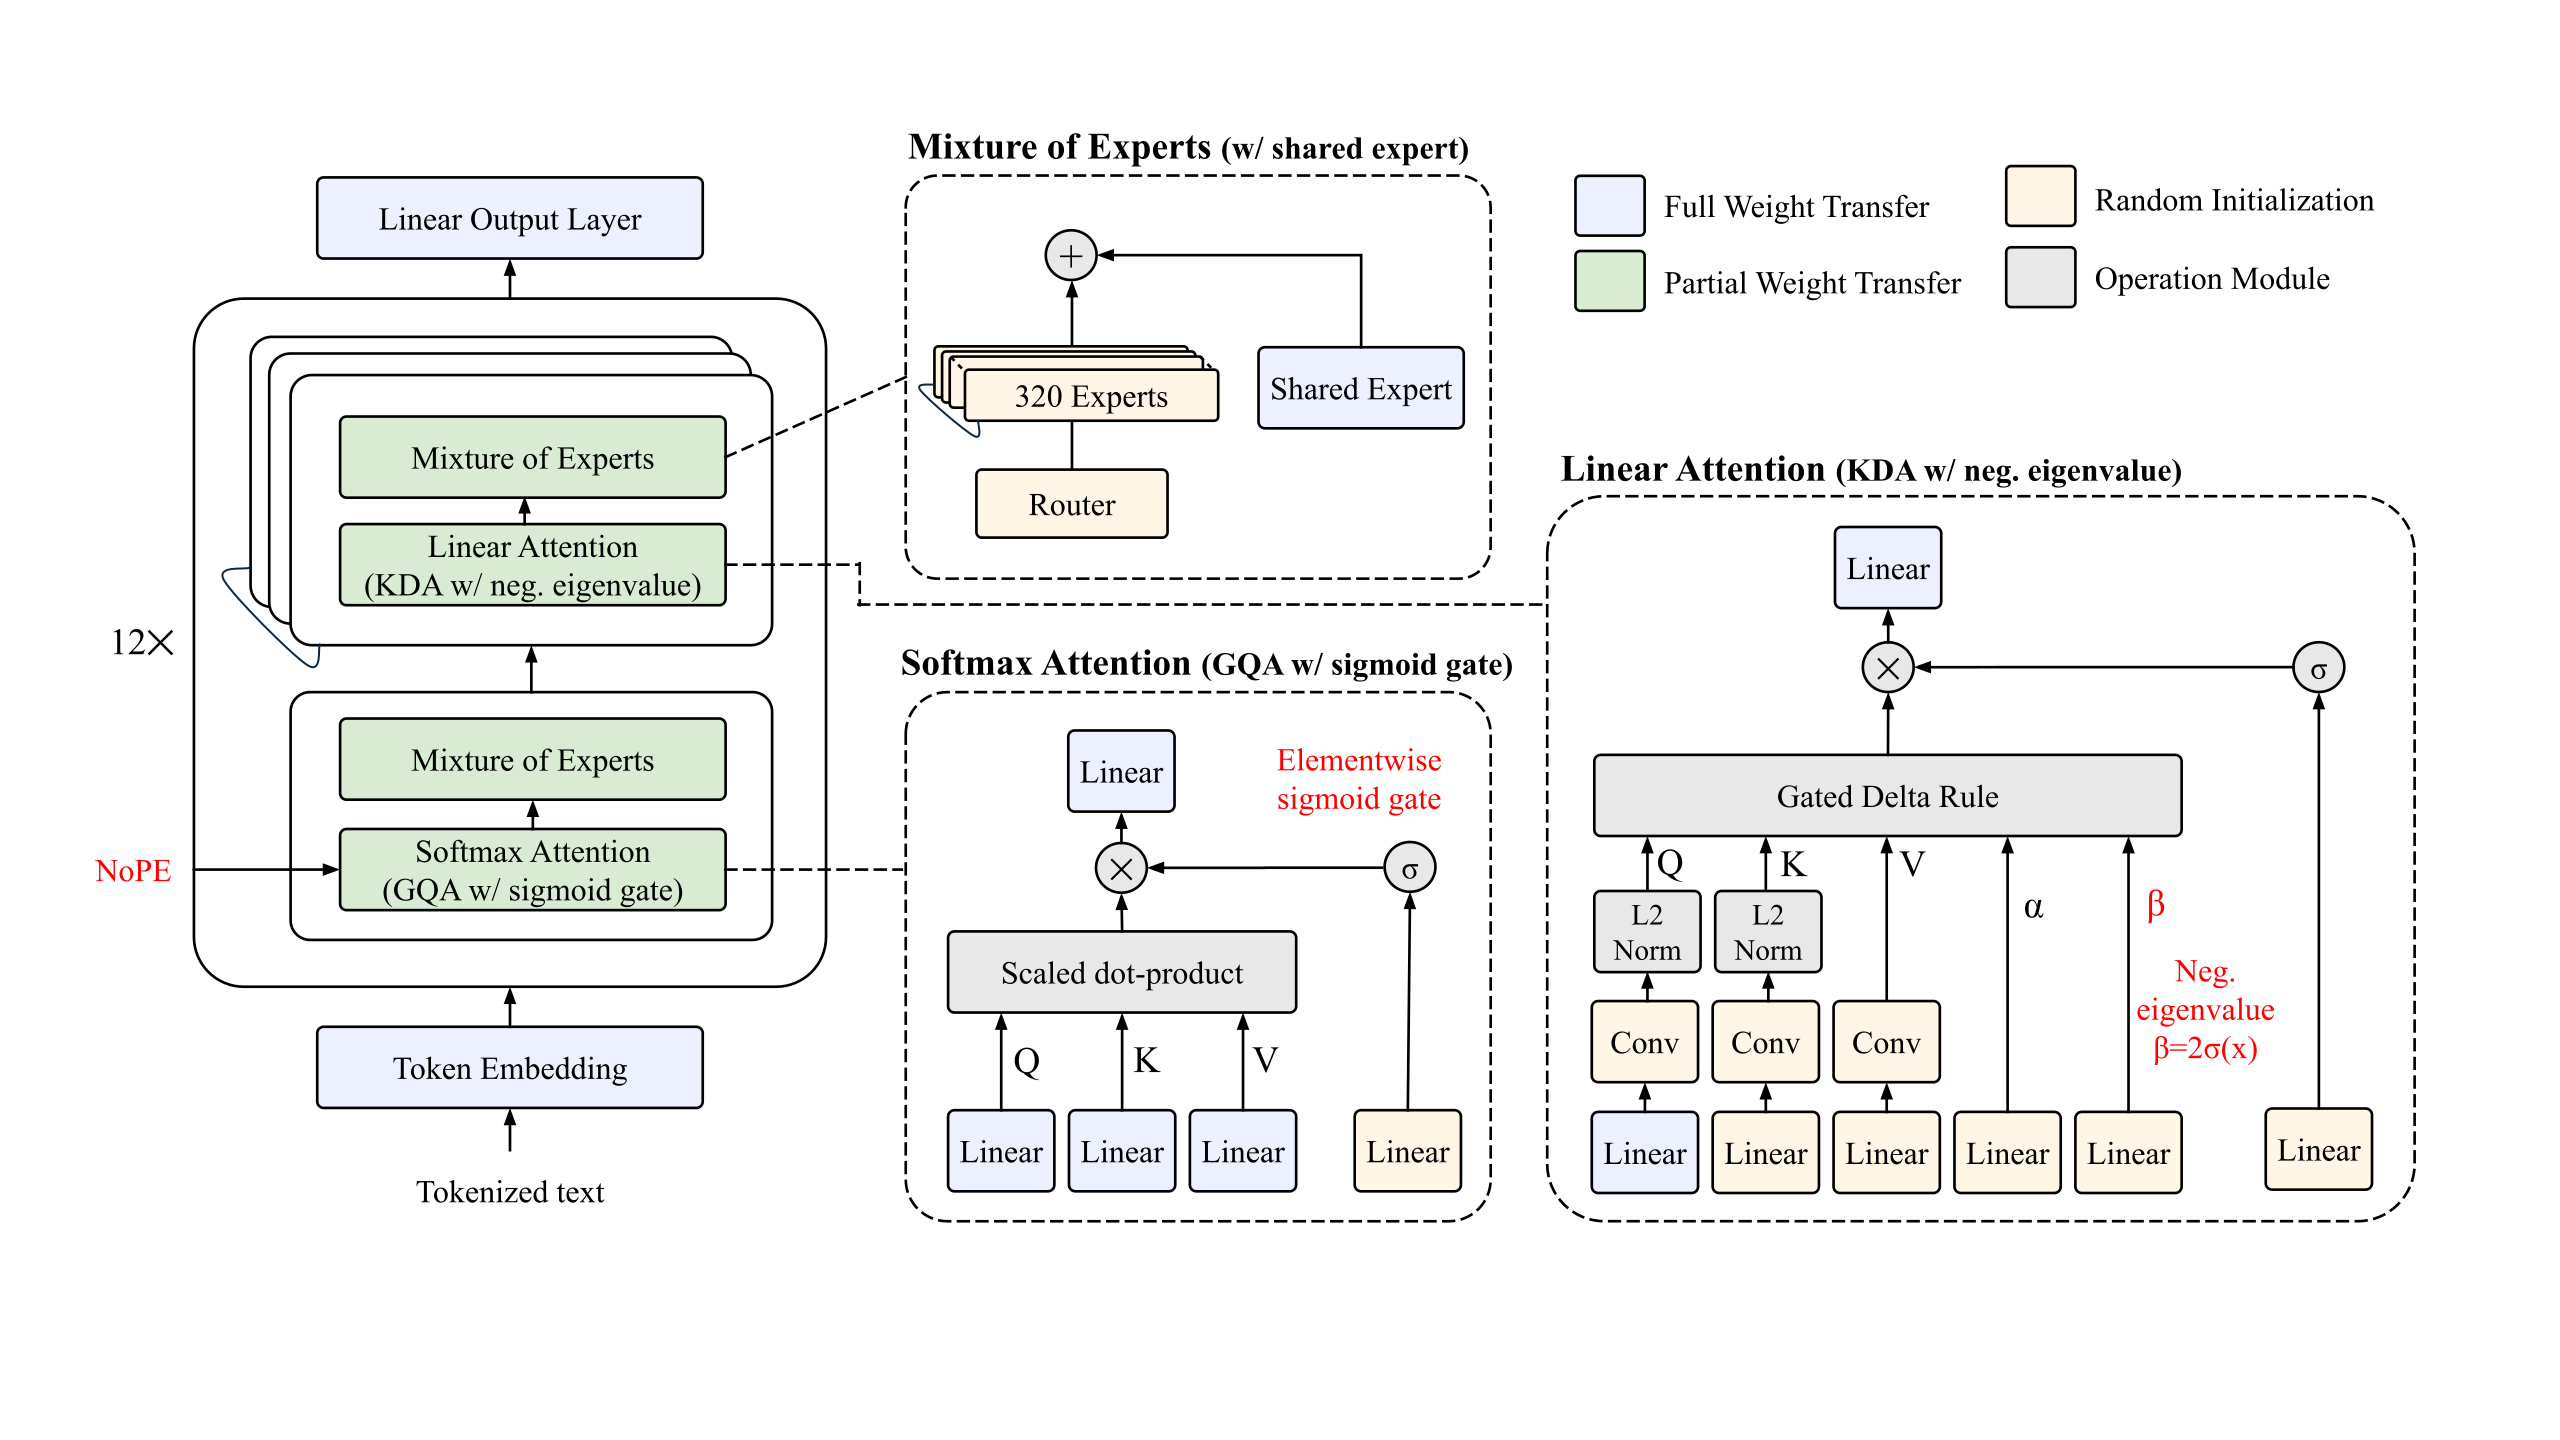
모티프가 8월 11일 공개한 Motif 3는 전체 3,140억 파라미터 가운데 토큰마다 132억 개를 쓰는 전문가 혼합 모델입니다. MoE 레이어마다 전문가 384개를 두고 토큰마다 8개를 고르며, 자체 설계한 어텐션 구조로 약 12조 5,000억 토큰을 학습했다고 기술 보고서에 적었습니다. 모티프는 과기정통부 지원을 받아 엔비디아 B200으로 학습했다고 밝혔고, 가중치는 상업 이용과 수정이 자유로운 MIT 라이선스로 풀었습니다. 과기정통부 발표에 따르면 Motif 3는 오픈웨이트 모델 AAII 순위에서 Kimi K3(60점), Qwen3.8(58점), GLM-5.2(53점) 등에 이어 6위이고, 회사별 최고 모델로 줄을 세우면 세계 10위입니다.
| 회사별 순위 | 회사 | 모델 | AAII |
|---|---|---|---|
| 1 | 앤트로픽 | Claude Opus 5 (max) | 63 |
| 2 | 오픈AI | GPT-5.6 Sol (max) | 61 |
| 3 | SpaceXAI | Grok 4.6 (high) | 61 |
| 4 | 문샷AI | Kimi K3 (max) | 60 |
| 5 | 알리바바 | Qwen3.8 Max | 58 |
| 6 | 메타 | Muse Spark 1.2 (xhigh) | 57 |
| 7 | 구글 | Gemini 3.7 Flash (high) | 56 |
| 8 | 딥시크 | DeepSeek V4 Pro 0813 (max) | 53 |
| 9 | Z AI | GLM-5.2 (max) | 53 |
| 10 | 모티프테크놀로지스 | Motif 3 | 47 |
| - | 업스테이지 | Solar Open2 | 37 |
| - | SK텔레콤 | A.X K2 | 35 |
| - | LG AI연구원 | K-EXAONE 2.0 | 31 |
전문가위원회도 모티프의 기술을 높이 평가했습니다. 아키텍처부터 토크나이저, 옵티마이저, 커널까지 자체 개발해 외부 종속을 없앴고, 독자 기술을 적용하며 얻은 기술적 한계와 시행착오 데이터도 국가적 자산으로 가치가 높다는 의견이었습니다. 과기정통부는 모티프가 앞으로도 국내 AI 생태계에 다각도로 기여할 것으로 기대한다고 덧붙였습니다.
과기정통부가 공개한 전문가위원회 의견을 보면 통과한 세 팀의 강점은 모델 밖에서 많이 나옵니다. 업스테이지는 포털 다음과 타임리 플랫폼에 모델을 연계하고, 퓨리오사AI의 국산 NPU로 실제 다음 서비스 환경에서 실증한 점을 호평받았습니다. SK텔레콤은 수리 추론과 한국어에서 비교군 최상위 성능을 냈고, 국방 분야에 A.X K1을 제공하고 제조 에이전트를 실증하고 법무·세무 분야에서 시연한 실적을 인정받았습니다.
LG AI연구원은 국제기구와의 협업 전략, 에이전틱 AI의 차별성, 안전하고 신뢰할 수 있는 AI를 위한 활동이 평가 의견에 올랐습니다. 과기정통부는 성능 성과도 팀마다 하나씩 따로 소개했습니다. Solar Open2는 한 번에 100만 토큰을 처리하고, A.X K2는 매스아레나의 AIME 2026 순위표에서 정확도 97.1%로 공동 1위에 올랐고, K-EXAONE 2.0은 AAII 구성 지표인 환각 최소화 지표에서 세계 9위였습니다. K-엑사원 2.0의 구조와 성적표와 688B 모델 A.X K2는 앞서 정리했습니다.
평가표의 파급효과·기여계획 15점은 이런 실적을 점수로 옮기는 항목입니다. 포털과 연결하고, 국방·제조 현장에 넣고, 국제기구와 손잡는 일은 모델 성능보다 기업의 사업 기반과 협력 관계에 크게 기대는 성과입니다. 1차부터 참여한 세 팀은 지난해 8월부터 이런 실적을 쌓았고, 2월에 합류한 모티프는 6개월 안에 모델과 실적을 함께 만들어야 했습니다.
정부가 평가에 현장 확산과 국민 사용성을 넣은 논리는 발표문에 적혀 있습니다. 성능 좋은 모델을 만드는 데서 멈추지 않고 모델을 국내 산업 현장에 붙이고, 국민 눈높이에 맞는 모델을 만들도록 유도하겠다는 것입니다. 1월 발표문은 이 사업의 정책적 목적을 국방·외교·안보와 전력망·통신망 같은 국가 기반 시설에서 외산 모델에 기대지 않고 AI를 스스로 개발하고 통제할 역량을 갖추는 일로 설명했습니다.
저는 그 목적이라면 평가도 산업별로 짜는 편이 맞다고 봅니다. 국방에 들어갈 모델은 국방 시나리오로, 법무에 쓸 모델은 법률 문서 처리로 재야 점수에 근거가 생깁니다. 이번 사용자 평가는 전문 사용자와 국민이 각 팀의 웹사이트에서 모델을 써 보고 1~5점을 매긴 결과이고, 그 점수가 25점 배점 안에서 네 팀 사이를 가장 크게 벌렸습니다.
그래도 한국 모델의 성적표는 반년 전보다 나아졌습니다. 과기정통부가 인용한 AAII 기준으로 국내 최고 모델과 세계 최고 모델의 격차는 1월 19점(GPT-5.2 51점, 국내 32점)에서 8월 16점(Claude Opus 5 63점, Motif 3 47점)으로 줄었습니다. 과기정통부는 그사이 AAII 산정 기준이 바뀌었다는 단서도 달았습니다. 네 팀 모델은 모두 미국 비영리 연구기관 에포크 AI의 주요 모델 목록(Notable AI Models)에 올랐고, 올해 이 목록에 모델을 올린 나라는 미국과 중국, 한국 셋입니다. 과기정통부는 허깅페이스가 이 사업을 정부 주도 오픈소스 정책의 우수 사례로 평가하고 공동 홍보 같은 협력을 제안해 왔다고도 밝혔습니다.
다음 단계에 오른 세 팀에는 GPU 지원이 늘어납니다. 과기정통부 발표에 따르면 B200 기준 지원 규모는 지난해 하반기 500장 수준, 올해 상반기 768장 수준에서 하반기 1,000장 수준으로 커집니다. 과기정통부는 최상위급 독자 모델 개발을 위해 기존 방식을 뛰어넘는 지원 체계를 관계 부처와 논의하고 있으며 구체적인 내용은 따로 발표하겠다고 했습니다.
이번 발표에 빠진 숫자도 분명합니다. 팀별 총점과 영역별 점수, 사용자 평가의 문항과 점수 분포가 없어서, 모티프가 어느 영역에서 얼마나 뒤졌는지는 바깥에서 알 수 없습니다. 1차 평가 때는 항목별 1위 팀과 점수를 공개했는데, 이번에는 그마저 빠졌습니다. 국내 AAII 최고점 모델이 떨어진 평가에서 그 이유를 설명할 숫자가 나와야, 3차에서 각 팀이 무엇을 준비할지도 정해집니다.
읽어 주셔서 고맙습니다.
초이 드림


