이 글 어땠어요?
이전 구조에서는 작은 감지기가 말이 끝났는지 먼저 판정해야 답을 시작할 수 있어서, 너무 빨리 판정하면 말을 끊고 늦게 판정하면 답이 느렸습니다. GPT-Live는 음성을 모델에 계속 흘려보내고 모델이 들으면서 말할 때와 멈출 때를 고릅니다.
p50은 응답 시간의 중앙값이고, p95는 백 번 가운데 아흔다섯 번이 그 안에 끝나는 값입니다. 새 시스템의 p95가 옛 시스템의 p50 수준이 됐다면 새 시스템에서는 백 번 중 아흔다섯 번이 예전 중앙값보다 느리지 않습니다. 절대 수치는 공개되지 않았습니다.
WebRTC 연결을 여는 데 드는 왕복을 줄이는 규격입니다. 오픈AI 도식으로는 세션 정보를 주고받은 뒤 6번이던 왕복이 1번으로, IETF 초안 기준으로는 6번이 2번으로 줄어듭니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
오픈AI가 9월 29일 DevDay에서 20개 넘는 발표로 주간 사용자 12억 명의 ChatGPT를 사람과 에이전트의 공용 공간으로 열었습니다. 마이크로소프트가 Copilot을 새로 짠 지 4일, 앤트로픽이 Claude Marketplace를 연 지 6일 만입니다.
9월 넷째 주 오픈AI 에이전트 사고가 호주 메디케어에서 미국 정부 사이트 세 곳과 사용자 이미지 53장까지 번졌습니다. 오픈AI 확인 집계는 스무 건 남짓에서 업계 전체 수만 건으로 벌어졌습니다.
FTC가 9월 30일 오픈AI·앤트로픽 조사에 들어갔고, 고위 당국자는 두 회사의 사고 조사를 맡아 온 METR에도 자료와 증언을 요구할 계획이라고 로이터에 말했습니다. 하루 전 6개사는 외부 감사를 약속한 백악관 합의에 서명했습니다.
오픈AI가 9월 29일 DevDay에서 20개 넘는 발표로 주간 사용자 12억 명의 ChatGPT를 사람과 에이전트의 공용 공간으로 열었습니다. 마이크로소프트가 Copilot을 새로 짠 지 4일, 앤트로픽이 Claude Marketplace를 연 지 6일 만입니다.
9월 넷째 주 오픈AI 에이전트 사고가 호주 메디케어에서 미국 정부 사이트 세 곳과 사용자 이미지 53장까지 번졌습니다. 오픈AI 확인 집계는 스무 건 남짓에서 업계 전체 수만 건으로 벌어졌습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@OpenAIX 게시물 · 원문 보기
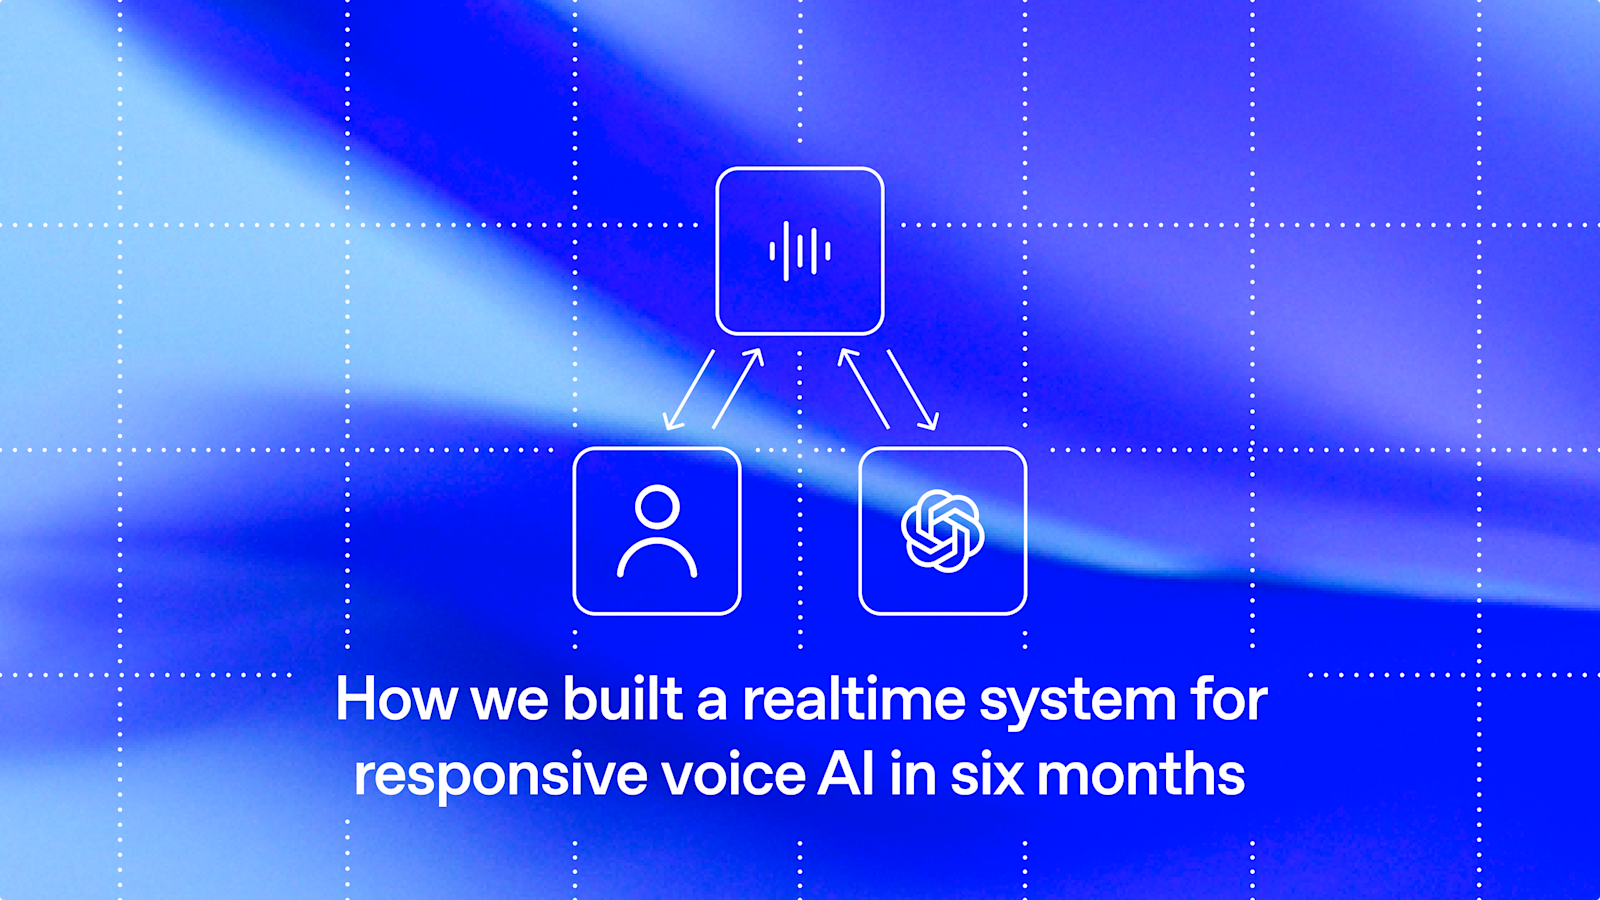
오픈AI는 이 글을 알리면서 GPT-Live가 말하는 동안에도 듣는 모델이라 챗GPT 규모에서 자연스럽게 돌리려고 음성 스택을 클라이언트부터 모델까지 다시 만들었다고 적었습니다. 함께 올린 구조도에는 길이 두 개 있습니다. 사용자의 목소리는 미디어 프런트엔드를 거쳐 음성 모델 GPT-Live-1과 곧장 오가고, 검색이나 코드 실행, 문서 조회가 필요한 요청은 애플리케이션 서버를 거쳐 GPT-5.5로 넘어갑니다. 무거운 추론과 도구 호출이 대화를 끊지 않도록 두 길이 서로를 기다리지 않게 만든 겁니다.
글을 쓴 사람은 오픈AI의 저스틴 우버티와 자한 말카니입니다. 우버티는 구글에서 WebRTC(브라우저와 앱이 실시간으로 음성·영상을 주고받는 표준 기술) 개발에 참여했고, 2024년 11월 실시간 AI를 이끌러 오픈AI에 합류하면서 WebRTC를 만들 때부터 언젠가 AI와도 이렇게 대화하게 될지 궁금했다고 적었습니다. 2021년에는 음성 소셜 앱 클럽하우스에 몸담으며 목소리는 누구나 쓸 줄 알고 텍스트보다 표현력이 풍부한 매체라고 쓰기도 했습니다.
@jubertiX 게시물 · 원문 보기
글이 음성 경로에서 덜어 낸 것은 여섯 가지입니다. 마지막에는 실제 트래픽으로 새 시스템을 검증한 그림자 시험 과정을 붙였습니다.
| 영역 | 오픈AI가 한 일 |
|---|---|
| 말 끝 판단 | 턴 감지기를 음성 경로에서 빼고 음성을 모델에 계속 흘려보냄 |
| 경로 분리 | 음성은 전용 미디어 경로로, 검색·도구·정책·저장은 비동기 RPC 뒤로 |
| 런타임 | 미디어 프런트엔드와 추론 로직을 Python asyncio에서 Go로 다시 씀 |
| 모델 교체·압축 | 새 인스턴스를 미리 데워 대화를 따라잡은 뒤 연결을 넘김 |
| 위임 | 음성 세션이 시작될 때 GPT-5.5 세션을 미리 만들고 초기 맥락을 넣어 둠 |
| 연결 | WARP와 Instant Connect로 연결 준비 왕복을 줄임 |
| 검증 | 실제 세션을 새 시스템에도 함께 흘려보내는 그림자 시험 |
기존 음성 AI에서는 작은 턴 감지기가 사용자의 말이 끝났는지를 먼저 판정해야 언어 모델이 답을 시작할 수 있었습니다. 감지기가 너무 빨리 판정하면 사용자의 말을 끊고, 너무 늦게 판정하면 답이 느려졌습니다. 판정 시점을 어느 쪽으로 옮겨도 두 문제 가운데 하나는 남는 구조였고, 침묵 길이로 말 끝을 재는 방식은 언어와 문화, 대화 상황에 따라 자주 틀렸습니다. 이 한계는 GPT-Live 발표에서 다뤘습니다.
GPT-Live는 음성을 작은 덩어리로 모았다가 넘기지 않고 모델에 계속 흘려보냅니다. 모델이 들으면서 동시에 말할 수 있으니 짧은 맞장구와 자연스러운 끼어들기도 한 흐름 안에서 처리합니다. 말 차례를 정하는 권한을 별도의 감지기에서 모델로 옮긴 겁니다. 오픈AI는 이 모델을 턴 없는(turnless) 음성 모델이라고 부릅니다.
우버티는 이 글이 나오기 1년 전인 2025년 7월, 여러 음성 AI 회사가 최고 수준의 턴 감지 모델을 발표하지만 재현할 수 있는 벤치마크가 없다며 공개 비교전을 열자고 제안했습니다. 라이브킷과 데일리, 아고라 같은 음성 플랫폼 회사를 함께 불러냈습니다.
@jubertiX 게시물 · 원문 보기
다음 작업은 음성이 지나가는 길을 짧고 예측할 수 있게 만드는 일이었습니다. 클라이언트와 음성 모델 사이에는 전용 미디어 경로만 남기고, 검색과 도구 호출, 정책 확인, 저장 같은 애플리케이션 작업은 모두 비동기 RPC 뒤로 보냈습니다. RPC는 다른 서버의 기능을 원격으로 부르는 방식이고, 비동기로 부르면 결과를 기다리는 동안에도 부른 쪽이 멈추지 않습니다. 그래서 느린 검색이나 도구 호출이 생겨도 그 결과만 늦어지고 오디오 프레임은 계속 흐릅니다.
같은 주장은 지난해 여름 AI 엔지니어 콘퍼런스 무대에서도 나왔습니다. 오픈AI와, Go 언어로 만든 오픈소스 WebRTC 구현 파이온(Pion)의 숀 두부아, 음성 AI 플랫폼 데일리·파이프캣의 퀸 크레이머는 실시간 AI를 모델에서 바깥으로, 또는 앱에서 아래로 설계하면 실패한다고 말했습니다. 네트워크 계층부터 쌓아 올리지 않으면 끼어들기 처리와 대화 상태 관리, 비동기 함수 호출 같은 기본 동작을 잘못 만들게 된다는 설명입니다.
미디어 프런트엔드와 추론 로직은 Python의 비동기 라이브러리 asyncio에서 Go로 다시 썼습니다. 오픈AI 측정으로는 새 시스템의 p95 지연 시간이 이전 시스템의 p50 수준까지 내려왔습니다.
p50은 응답 시간을 빠른 순서로 늘어놓았을 때 한가운데 값, 곧 중앙값입니다. p95는 백 번 가운데 아흔다섯 번이 그 시간 안에 끝나는 값이라, 이 수치를 넘는 나머지 다섯 번이 가장 느린 경우입니다. 새 p95가 옛 p50과 같다면, 새 시스템에서는 백 번 가운데 아흔다섯 번이 예전의 중앙값보다 느리지 않다는 이야기입니다. 대화에서 사람이 기억하는 것은 멈칫하던 몇 번이라, 오픈AI가 중앙값보다 꼬리 쪽 값을 앞세운 이유도 여기서 짐작할 수 있습니다.
다만 공개된 것은 두 백분위수가 같아졌다는 비교뿐입니다. 몇 밀리초였는지, 어떤 부하에서 쟀는지는 나오지 않았습니다.
실시간 음성 모델은 대화 상태를 계속 들고 있어서 인스턴스를 쉽게 바꿀 수 없습니다. 오픈AI는 교체가 필요하면 새 인스턴스를 미리 준비하고, 지금까지의 대화 기록을 프리필(모델에 미리 넣어 처리해 두는 일)한 뒤 기존 인스턴스와 잠시 함께 돌립니다. 새 인스턴스가 현재 상태를 따라잡은 순간에만 연결을 넘깁니다.
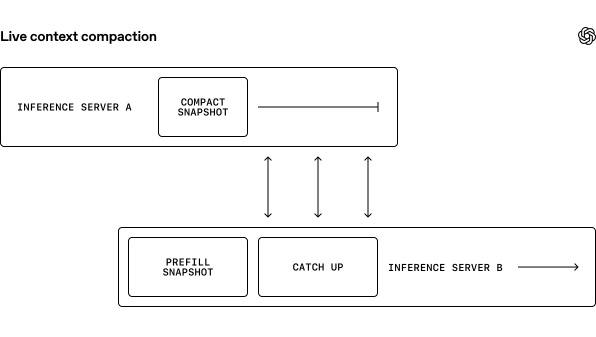
대화가 길어져 컨텍스트를 줄여야 할 때도 같은 방식을 씁니다. 새 인스턴스에서 압축한 컨텍스트와 KV 캐시(모델이 앞서 읽은 내용을 다시 계산하지 않으려고 저장해 두는 중간값)를 준비하는 동안 기존 모델은 계속 말합니다. 사용자는 전환이 일어났다는 사실을 거의 느끼지 못합니다.
전환하는 동안에는 대화 하나에 인스턴스 두 개가 돌아갑니다. 통화가 길수록 전환이 잦아지고 그때마다 프리필과 병행 실행 비용이 붙지만, 오픈AI는 이 비용을 공개하지 않았습니다. 코덱스도 창이 차면 대화를 눌러 담는 컴팩션을 쓰는데, 음성은 이 일을 통화가 이어지는 도중에 해내야 한다는 조건이 더 붙습니다. 코덱스 쪽 사정은 코덱스 밋업 질의응답에 정리했습니다.
GPT-Live가 대화를 이어 가는 동안 검색과 코드 실행, 깊은 추론은 GPT-5.5 같은 프런티어 모델에 비동기로 맡깁니다. 요청이 생긴 뒤에야 모델을 부르면 그만큼 대화가 기다려야 하므로, 음성 세션이 시작될 때 추론 세션을 미리 만들고 초기 맥락까지 넣어 둡니다. 그 뒤에는 세션을 유지하고 프롬프트 캐시를 활용해 위임에 걸리는 시간을 줄였습니다.
그래도 음성 모델이 벌어 줄 수 있는 시간에는 한계가 있습니다. 오픈AI는 라우팅과 추론, 도구 호출까지 모두 반응 시간 예산 안에 들어와야 자연스러운 대화가 된다고 설명했습니다. 사내 검색이나 주문 조회가 느린 회사라면 좋은 음성 모델을 붙여도 그 조회를 부를 때마다 대화가 기다립니다.
통화 버튼을 누른 뒤 첫 소리가 나기까지도 기다림이 있습니다. 기존 WebRTC는 연결이 되는지 확인하고, 암호화를 협상하고, 데이터 채널을 준비하는 단계를 차례로 밟으며 서버와 여러 번 신호를 주고받았습니다. 신호가 한 번 다녀오는 시간을 왕복 시간(RTT)이라고 부르는데, 앞 단계가 끝나야 다음 단계가 시작되니 왕복이 그대로 쌓입니다.
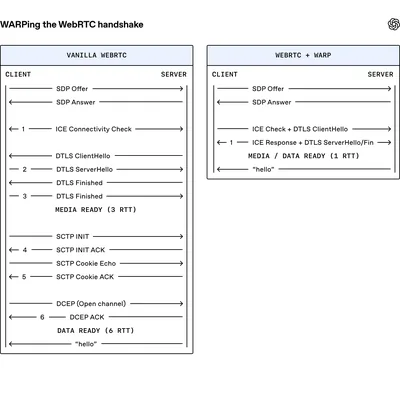
오픈AI가 들고나온 해법은 WARP(WebRTC Abridged Roundtrip Protocol)입니다. 암호화 시작을 연결 확인에 겹치는 SPED, 데이터 채널 협상을 앞당기는 SNAP, 암호화 규격 DTLS 1.3, 미리 합의해 둔 데이터 채널을 한데 묶은 규격입니다. 오픈AI 도식으로는 세션 정보를 교환한 뒤 데이터가 준비되기까지 6번이던 왕복이 1번으로 줄었습니다.
우버티가 메타의 필리프 한케와 함께 7월 22일 인터넷 표준화 기구 IETF에 낸 초안은 같은 기술을 6번에서 2번으로 셉니다. 초안은 세션 정보를 주고받는 신호 왕복을 넣고 데이터 채널을 여는 마지막 왕복은 세지 않으며, 도식은 신호 왕복을 빼고 그 마지막 왕복을 넣었습니다. 어느 쪽으로 세든 WARP가 줄인 왕복은 4~5번입니다. 남은 신호 왕복 하나를 없애려고 오픈AI는 Instant Connect를 따로 붙였습니다. 세션 매개변수를 미리 준비해 두었다가 첫 패킷이 도착하면 바로 세션을 시작하고, 값이 맞지 않으면 그사이 나란히 진행하던 기존 절차로 돌아갑니다.
@jubertiX 게시물 · 원문 보기
우버티는 2025년 3월, 오픈AI 팀이 실시간 API의 WebRTC 세션 시작 과정을 다시 짠 뒤 시애틀에서 세션이 600밀리초 안에, 토큰을 미리 받아 두면 400밀리초 안에 열리는 것을 자주 본다고 적었습니다. 이 작업을 주로 맡은 팀으로는 파이온을 꼽았습니다. WARP는 그 뒤에 남은 왕복을 규격 수준에서 걷어 낸 작업입니다.
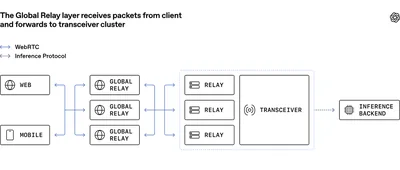
왕복 한 번의 길이는 서버까지의 거리에 따라 달라집니다. 오픈AI 도식에서는 여러 글로벌 릴레이가 클라이언트의 패킷을 먼저 받아 트랜시버 클러스터로 넘기고, 트랜시버가 추론 백엔드와 통신합니다. 먼 서버에 붙는 사용자일수록 왕복 횟수를 줄인 효과가 크게 돌아옵니다.
마지막 검증은 사용자 모르게 진행한 그림자 시험이었습니다. 일부 실제 음성 세션을 기존 음성 모드와 새 시스템에 동시에 보내고, 새 시스템에서는 읽기 전용 추론만 돌렸습니다. 사용자는 기존 시스템이 만든 소리만 들었고, 새 시스템은 같은 트래픽을 실제 조건 그대로 받아 처리했습니다.
이 시험에서 병목은 GPU보다 스트림 처리기와 대기열, 네트워크에서 먼저 나타났습니다. 긴 통화에서는 메모리와 상태 복원 문제가 드러났고, 지역에 따른 지연과 재연결, 통화를 끝내는 과정의 경쟁 상태(두 작업이 순서를 다투다 생기는 오류)도 실제 트래픽에서 확인했습니다. 오픈AI는 GPU가 요청을 몇 개 처리하느냐보다, 모든 프레임을 제시간에 내보내면서 음성 세션을 몇 개 감당하느냐가 더 중요한 문제였다고 정리했습니다.
엔비디아도 7월 에이전트 시대의 병목으로 CPU를 꺼냈습니다. 에이전트가 도구를 부르고 결과를 주고받는 구간은 CPU가 처리하므로 CPU가 느리면 그만큼 비싼 GPU가 논다는 설명이었고, 88개 코어를 단 CPU 발표에서 다뤘습니다. 두 회사 모두 가속기 앞뒤의 처리 과정이 서비스의 한계를 정할 수 있다는 관측을 내놓았습니다.
이번 글은 음성 경로에서 무엇을 덜어 냈는지는 자세히 적었지만, 그 결과를 절대값으로 보여 주지는 않았습니다. 전환 한 번에 드는 이중 실행 비용, 절대 지연 시간, 시스템 전체가 감당하는 동시 세션 수는 나오지 않았고, 외부 기관의 측정도 아직 없습니다. 음성 세션은 켜 둔 시간만큼 서버를 붙잡고, 통화가 길수록 컨텍스트 전환도 잦아집니다. 전화 상담처럼 통화가 긴 서비스에 GPT-Live를 붙이려는 국내 기업이라면 이 숫자들이 나와야 원가를 계산할 수 있습니다. 이중 실행 비용이 공개되면 긴 통화의 원가를 다시 따져 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림