

블룸버그가 한국 시각 10월 6일, 딥시크가 최소 800억 위안(120억 달러)의 투자 유치를 마무리하는 단계라고 보도했습니다.
배터리 회사 CATL과 위챗 운영사 텐센트가 가장 많은 금액을 약정한 투자자에 들었고, 딥시크는 처음 약 500억 위안을 목표로 했지만 최신 모델 출시 뒤 수요가 예상을 넘었습니다.
서명된 투자 조건서 기준 최종 규모는 1,000억 위안에 가까워질 수 있으며, 딥시크는 2027년 초 기업공개를 준비하고 있습니다.
Choi
같은 날 블룸버그는 문샷 AI가 기업가치 약 500억 달러로 마지막 비공개 투자를 마치고 내년 1분기 홍콩 상장을 준비한다고 보도했습니다. 문샷은 이르면 이달부터 기관 투자자의 수요를 미리 살피는 사전 면담을 시작합니다.
딥시크가 DeepSeek Harness를 macOS와 윈도우용 데스크톱 앱으로 내놨습니다.
문서와 스프레드시트, PDF 분석부터 차트와 슬라이드 제작, 코드 수정과 실행까지 한 대화에서 처리하고 결과물을 바로 확인합니다.
「Everything is a plugin」 구조라 기능부터 화면까지 플러그인으로 넓힐 수 있고, 딥시크는 공식 플러그인 마켓도 만들 계획입니다.
Choi
DeepSeek Harness는 전 세계 공개 프리뷰이자 오픈소스로 나왔고, 채팅으로 플러그인을 만드는 Creator mode를 갖췄습니다.
딥시크가 한국 시각 9월 30일 DeepGEMM Ascend를 MIT 라이선스로 공개했습니다.
엔비디아 GPU용으로 만든 DeepGEMM을 화웨이 어센드 950 계열 NPU로 옮긴 것으로, API가 같아 다른 플랫폼에서 쓰던 코드를 거의 그대로 돌릴 수 있습니다.
BF16과 FP8, FP4 행렬곱과 MQA 로짓, MegaMoE를 지원하고, 딥시크는 일반 행렬곱에서 하드웨어 한계 성능의 99.8%, MegaMoE에서 98%에 이르렀다고 밝혔습니다.
Choi
라이브러리가 어센드 특유의 분형 행렬 배치와 정렬 제약, 주소 계산을 감춰 커널 코드를 짧게 유지합니다. 어센드 950을 쓰는 쪽이 CUDA 없이도 성능을 끌어내는 길이 넓어집니다.
텍스트 성능은 기존 V4-Flash와 같습니다.
에이전트, 추론, 지식 전부 그대로인데 이미지를 읽는 능력이 붙었고, 멀티모달 에이전트 벤치마크에서는 Opus 4.8 턱밑까지 올라왔다고 밝혔습니다.
일부 에이전트 평가에서는 비전을 달고도 오히려 점수가 올라, 애초에 비전까지 학습해두고 눈만 가려둔 모델이었다는 평가가 나옵니다.
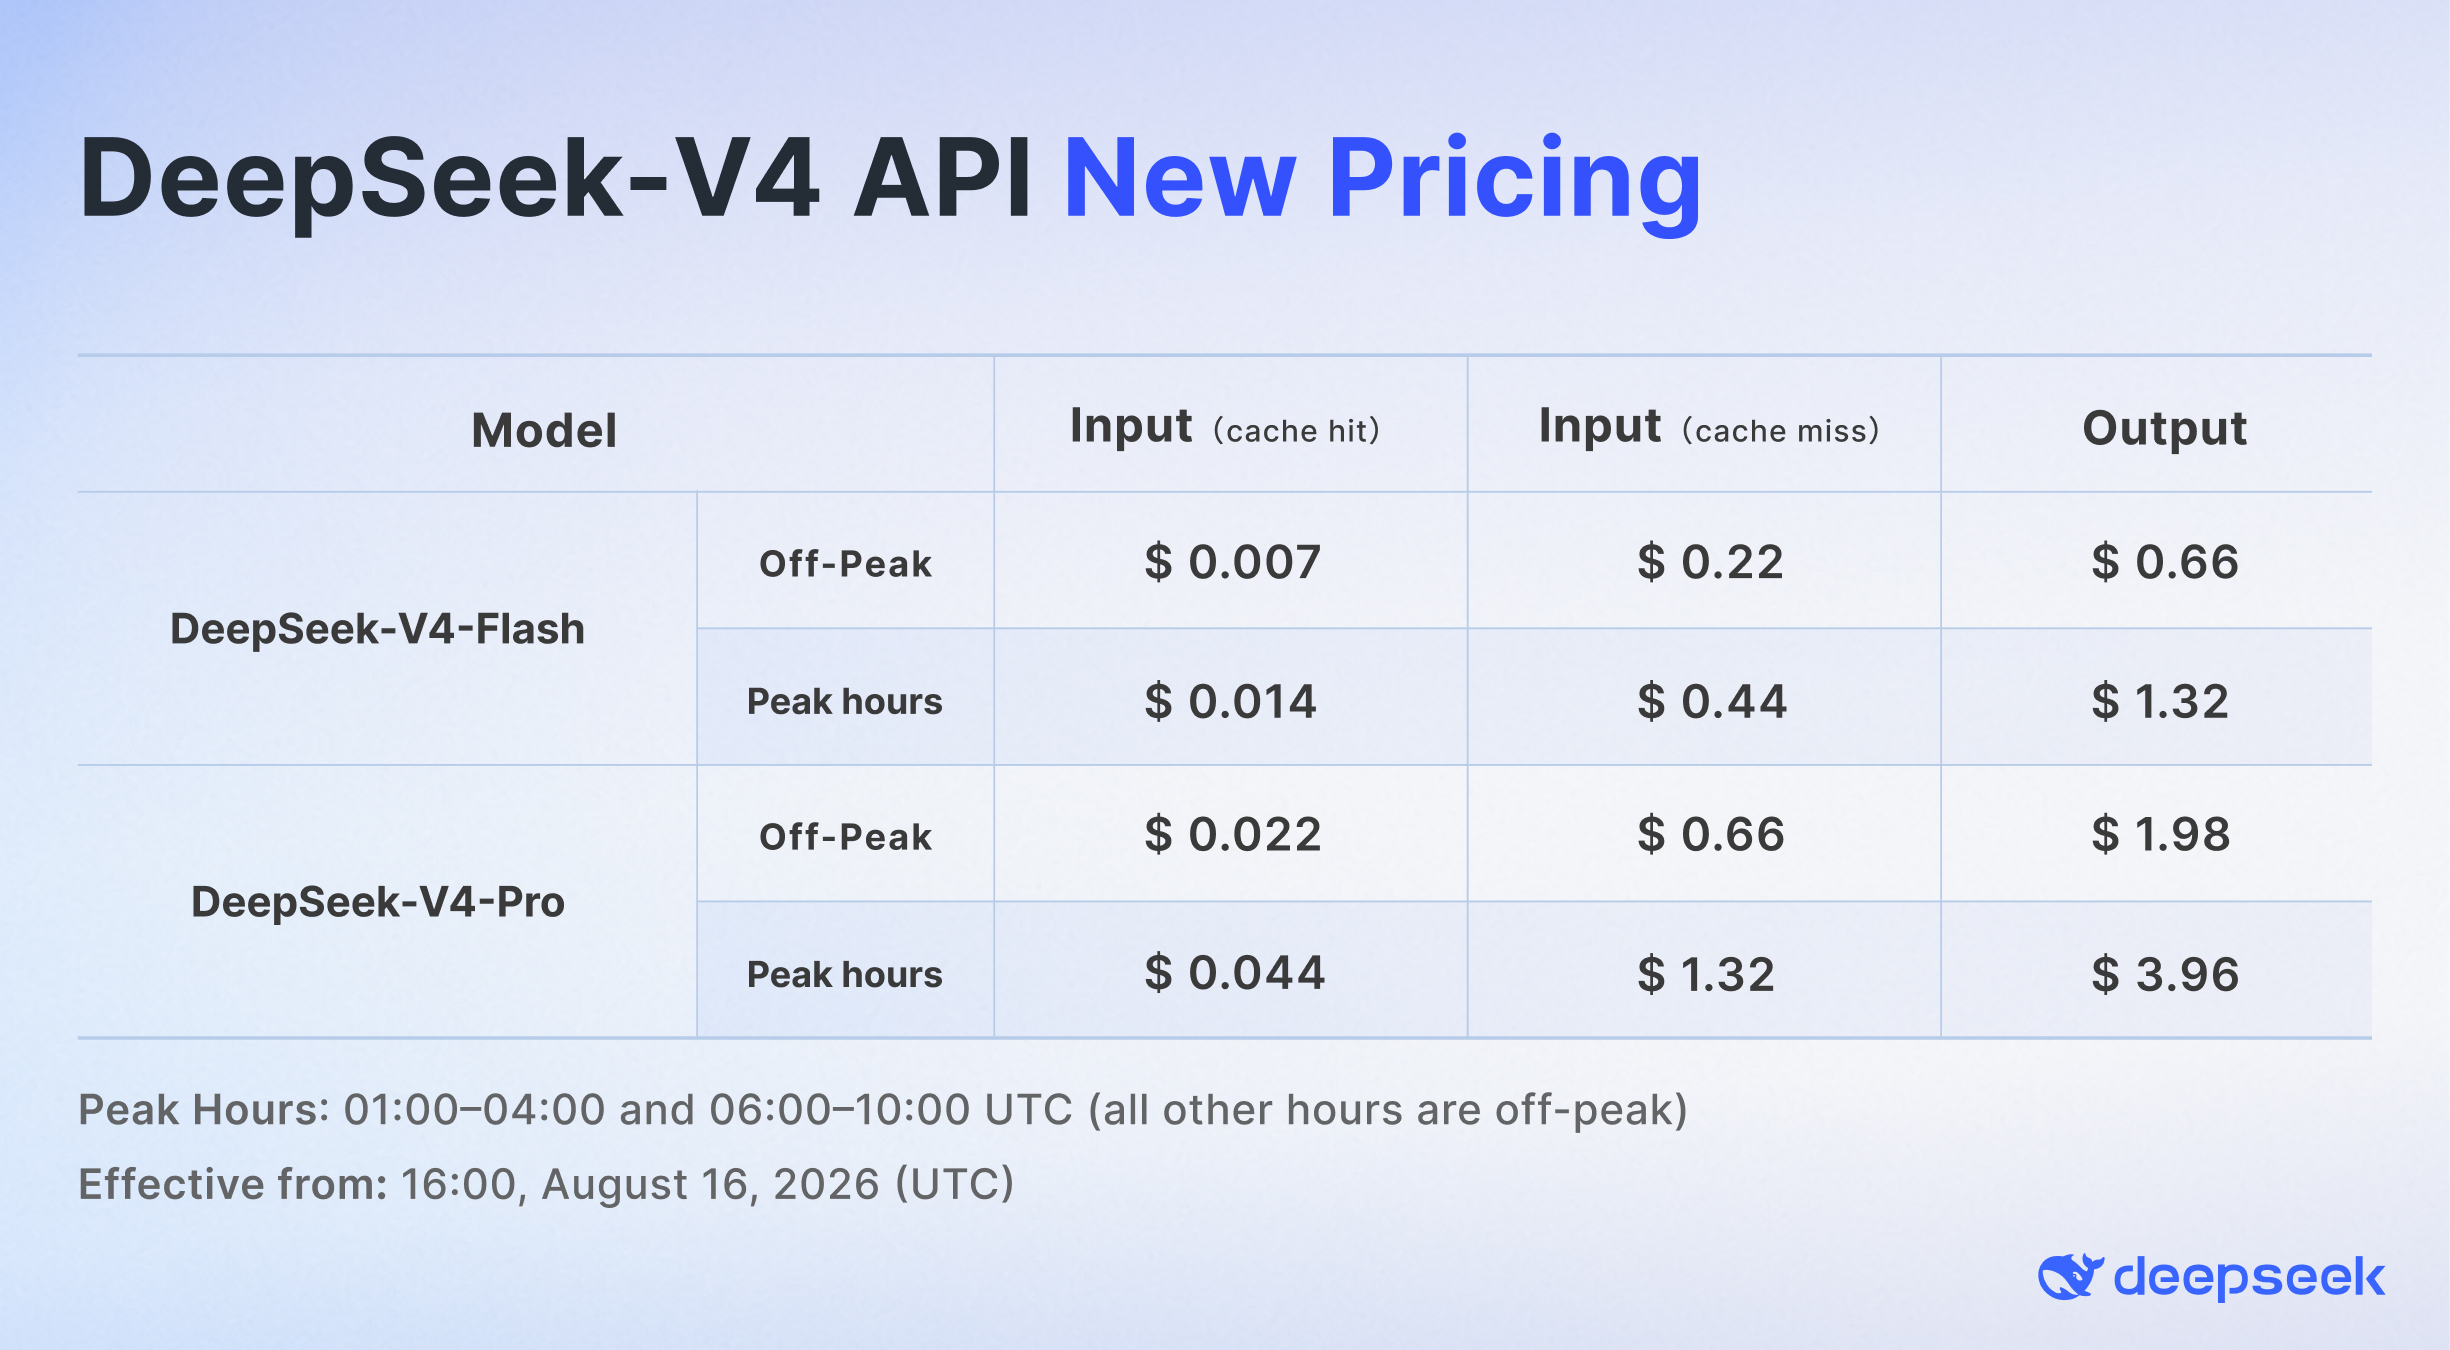
가격은 이미지를 장당 최대 384토큰으로 환산해 기존 Flash 요금 그대로 받고, 한 번 올린 이미지를 재사용하는 Files API는 무료입니다.
스크린샷을 읽고 화면을 이해하는 에이전트 작업까지 이 가격대로 내려와, 저렴한 에이전트를 쓸 수 있는 작업이 늘었습니다.
가중치 공개는 아직인데, 지난달 가중치를 풀었던 전례를 보면 이번에도 시간문제일 가능성이 높습니다.
Choi
이미지를 장당 최대 384토큰으로 환산해 텍스트와 같은 요금을 받으므로, 스크린샷을 여러 장 읽는 에이전트 작업도 기존 V4-Flash 단가로 계산됩니다.
에이전트 코딩을 재는 DeepSWE는 7.4에서 54.4로 뛰었고, 터미널 작업을 재는 Terminal Bench 2.1은 82.7, 보안 취약점 발굴인 Cybergym은 76.7을 받았습니다.
총 284B에 토큰당 13B를 쓰는 구조는 4월 프리뷰와 같습니다.
Responses API를 네이티브로 지원하고 Codex 설정 가이드까지 붙였습니다.
가격은 100만 토큰당 출력 0.28달러로, 오늘 오픈AI가 GPT-5.6 Luna를 80% 내려 1.20달러로 맞췄는데도 4배 넘게 낮습니다.
DeepSeek V4-Pro 정식판도 곧 나올 것 같습니다.
Choi
사전학습을 다시 돌리지 않고 후반 공정만으로 등급을 넘었다면 성능의 여유가 아직 남아 있습니다. 가격 경쟁의 바닥도 같이 내려갑니다.
기술 보고서도 같이 나왔고 라이선스는 MIT입니다.
4월 프리뷰와 구조도 크기도 같은 모델입니다.
총 284B 가운데 토큰당 13B만 켜는 방식 그대로입니다.
바꾼 건 학습 후반 공정뿐인데, 에이전트 성능이 올라 활성 49B를 쓰는 상위 등급 V4-Pro를 벤치마크에서 앞섰다고 밝혔습니다.
직접 돌리는 쪽에서 더 반가운 건 체크포인트에 DSpark라는 투기적 디코딩 모듈이 붙어 나온다는 부분입니다.
작은 모델이 먼저 여러 토큰을 써 보고 본 모델이 한 번에 검증하는 방식이라, 딥시크 서빙 환경에서 사용자당 생성 속도가 기존 방식보다 60~85% 빨랐다고 합니다.
같은 가중치에서 속도를 얼마나 더 꺼낼 수 있는지 확인한 공개입니다.
Choi
가중치에 서빙 가속 모듈까지 얹어 풀면 자체 운영 원가가 내려가고 API를 떠날 이유가 생깁니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.