이 글 어땠어요?
두 모델 모두 Jev와 같은 형식의 요청을 받습니다. Clef는 Workers AI에서 호출하거나 허깅페이스에서 가중치를 내려받아 돌리고, Strands Decider는 내려받아 PC나 서버에서 직접 실행합니다.
입력 100만 토큰당 Clef는 0.24달러, Clef-flash는 0.09달러로 Jev의 0.042달러보다 비쌉니다. 클라우드플레어가 잰 응답 시간 중앙값은 Clef 209밀리초, Clef-flash 39밀리초, Jev 524밀리초였습니다.
클라우드플레어와 AWS는 한국어 점수를 공개하지 않았습니다. 국내 회사 다키클라우드가 9월 24일 공개한 측정에서 Jev는 처음 보는 한국 정책 문서 119문항 가운데 93.3%를 맞혔습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
TypeSafe의 판단 전용 모델 Jev가 공개 5일 만인 9월 20일 모든 개발자에게 열렸습니다. 그사이 X에 올라온 데모는 사례 모음 사이트에 모인 것만 194개였고, Jev처럼 선택지에 확률을 매기는 공개 모델도 4개 나왔습니다.
CopilotKit이 10월 1일(미국 시각) 오픈AI dots의 오픈소스 대안 OpenDots를 MIT 라이선스로 공개했습니다. 저장소는 dots 키노트 도중 만들어졌고 첫 코드는 5시간 16분 만에 합쳐졌습니다. 코드는 무료이고 모델과 대화 저장 비용은 따로 듭니다.
퍼플렉시티가 10월 2일 결정 모델 pplx-decider-v1-27b의 가중치를 풀고 입력 100만 토큰당 0.04달러 API를 열었습니다. 종합 정확도 85.71%로 Jev를 앞섰지만 시험 11개 단순 평균은 Jev가 0.21%포인트 높았습니다.
TypeSafe의 판단 전용 모델 Jev가 공개 5일 만인 9월 20일 모든 개발자에게 열렸습니다. 그사이 X에 올라온 데모는 사례 모음 사이트에 모인 것만 194개였고, Jev처럼 선택지에 확률을 매기는 공개 모델도 4개 나왔습니다.
CopilotKit이 10월 1일(미국 시각) 오픈AI dots의 오픈소스 대안 OpenDots를 MIT 라이선스로 공개했습니다. 저장소는 dots 키노트 도중 만들어졌고 첫 코드는 5시간 16분 만에 합쳐졌습니다. 코드는 무료이고 모델과 대화 저장 비용은 따로 듭니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.

클라우드플레어 발표 글의 그림은 고객 지원 문의 한 건으로 결정 모델의 쓰임을 설명합니다. 기업 고객이 「API가 20분 전부터 500 오류를 내서 주문을 처리하지 못한다」고 문의하면, 프로그램은 이 문의와 함께 「어느 팀이 맡나(결제·기술·영업)」와 「급한가(예·아니요)」 두 질문을 모델에 보냅니다. 모델은 두 질문에 한 번에 답해 기술팀 100%, 급함 100%라는 확률을 돌려주고, 프로그램은 이 숫자대로 문의를 기술팀에 넘기고 긴급 절차를 켭니다.
챗GPT 같은 언어모델은 답을 토큰(글자 조각) 하나씩 이어 붙여 만듭니다. 결정 모델은 입력을 한 번 읽고 정해 둔 선택지 전부에 점수를 매기는 데서 계산을 끝내므로 글을 생성하는 단계가 없습니다. 답이 처음 정한 선택지 밖으로 나갈 수 없어서, 「네, 매우 급해 보입니다」 같은 문장에서 값을 다시 뽑아내는 코드도 필요 없습니다.
함께 돌아오는 확신도는 보정(calibration)이 돼 있어야 쓸모가 있습니다. 보정은 모델이 0.9라고 답한 것들이 실제로 열에 아홉쯤 맞는 상태를 가리킵니다. AWS는 Strands Decider가 처음 보는 짧은 분류 과제에서 확신도 0.9 이상으로 낸 답의 약 95%가 맞았다며, 그보다 낮으면 결과를 다시 확인하거나 사람에게 물으라고 안내합니다.

Clef는 알리바바의 공개 모델 큐원(Qwen)을 바탕으로 만들었습니다. Qwen3.8-27B(Clef)와 Qwen3.5-9B(Clef-flash)를 얼려 둔 채(가중치를 고정한 채) 그 위에 선택지를 채점하는 작은 헤드와 rank-256 LoRA 어댑터만 학습했고, 허깅페이스에 올라온 파라미터 수는 각각 274억 개와 94억 개입니다. 입력은 앞부분을 한 번 계산하는 프리필(prefill)만 거치고, 그 뒤 허용된 선택지들을 동시에 채점하므로 글자를 하나씩 만드는 과정이 없습니다.
학습 방법에서는 이름 하나가 겹칩니다. 클라우드플레어는 확률이 실제 정답률과 맞도록 브라이어 손실(예측 확률과 정답의 차이를 제곱한 값)을 쓰고, 두 번째 목표로 「보정된 결정을 위한 강화학습(RLCD)」을 직접 개발했다고 적었습니다. RLCD는 TypeSafe가 9월 15일 Jev를 발표하며 자기 학습법에 붙인 이름이고, 허깅페이스의 Jev 재현 추적 페이지는 아직 공개되지 않은 것으로 TypeSafe의 가중치와 RLCD 알고리즘을 꼽습니다. 클라우드플레어판 RLCD는 순서가 있는 선택지에서 정답 바로 옆을 고르면 부분 점수를 주고, 원래 모델에서 너무 멀어지면 벌점을 매기는 방식입니다.
클라우드플레어가 내세운 차이는 두 가지입니다. Clef에는 이미지를 읽는 비전 인코더가 있어 요청 하나에 이미지를 4장까지 넣을 수 있고, 한 번에 넣는 분량(문맥)은 6만 5,536토큰입니다. 발표 글은 Jev의 문맥을 3만 2,000토큰으로 적었는데, TypeSafe 문서에서 이 값은 상태와 가장 긴 질문 하나를 합친 한도이고 질문을 모두 합친 요청 한도는 6만 4,000토큰입니다.
클라우드플레어가 직접 결정 모델을 만들어 본 첫 기록은 Jev 공개 3일 뒤에 나왔습니다. 이번 발표 글의 공동 필자 미셸 첸은 9월 18일(미국 시각) 오픈소스 언어모델의 토큰 확률로 Jev를 흉내 낼 수 있는지 시험한 데모를 X에 올렸습니다. 구글의 텍스트 확산 모델 DiffusionGemma를 Workers AI에서 돌린 실험으로, 개발자 매트 마스트라치의 독립 연구를 바탕으로 삼았습니다.
@michellechenX 게시물 · 원문 보기
Clef는 같은 발상에서 바탕 모델만 큐원으로 바꿔 13일 만에 나왔습니다. 클라우드플레어는 위협 정보팀이 먼저 써 본 결과도 공개했습니다. 도메인 하나를 넘기면 Clef가 Browser Run으로 사이트를 불러와 그린 뒤 「패션 95%, 쇼핑몰 85%, 피싱 1% 미만」처럼 분류하는데, 여기까지 2.2초가 걸렸습니다. 같은 흐름에서 클라우드플레어가 가진 가장 빠른 범용 모델 gpt-oss-120b는 4.7초가 걸렸고 분류도 두 개만 내놨습니다.
Workers AI 가격표에서 Clef는 입력 100만 토큰당 0.24달러, Clef-flash는 0.09달러이고, 출력 단가는 따로 적혀 있지 않습니다. 클라우드플레어는 미세조정 서비스를 쓰는 경우를 빼고는 요청과 응답을 읽거나 저장하거나 학습에 쓰지 않는다고 약속했습니다.
Strands Decider는 AWS 엔지니어 마크 브루커의 개인 프로젝트에서 나왔습니다. 브루커는 AWS에서 에이전트 AI의 안전과 정책을 맡고 있고, 그 전에는 EC2와 EBS, 데이터베이스, 서버리스 분야에서 일했습니다. 그는 9월 28일 개인 블로그에 Jev를 보고 직접 모델을 만들어 봤다며 Hobson이라는 모델을 소개했습니다. 집에 있는 GPU로 돌리려고 크기를 약 20억 파라미터로 묶었고, 코드는 한 줄도 빠짐없이 에이전트가 썼다고 적었습니다.
3일 뒤 이 모델은 AWS의 오픈소스 에이전트 SDK Strands Agents의 실험 프로젝트 모음 Strands Labs에서 다듬어져 Strands Decider 2B로 나왔습니다. 공개된 모델 이름 strands-decider-2B-hobson-v19에 Hobson이 그대로 남아 있고, 공식 발표 글의 첫 필자도 브루커입니다. TechCrunch는 이 개인 프로젝트가 JevBench의 같은 크기 모델 가운데 잠깐 1위에 오른 뒤 AWS 엔지니어들이 정리해 내놓았다고 전했고, 브루커는 블로그 각주에 1위였던 시간이 아마 24시간쯤이었다고 적었습니다.
구조는 큐원 Qwen3.5-2B-Base의 몸통(torso)에서 글을 만드는 출력부(LM 헤드)를 떼어 내고, 파라미터 약 100만 개짜리 포인터 헤드를 붙인 형태입니다. 포인터 헤드는 「답」 위치의 은닉 상태와 선택지마다 마지막 토큰의 은닉 상태를 견줘 점수를 매기고, 몸통은 rank-16 LoRA로만 조정했습니다.
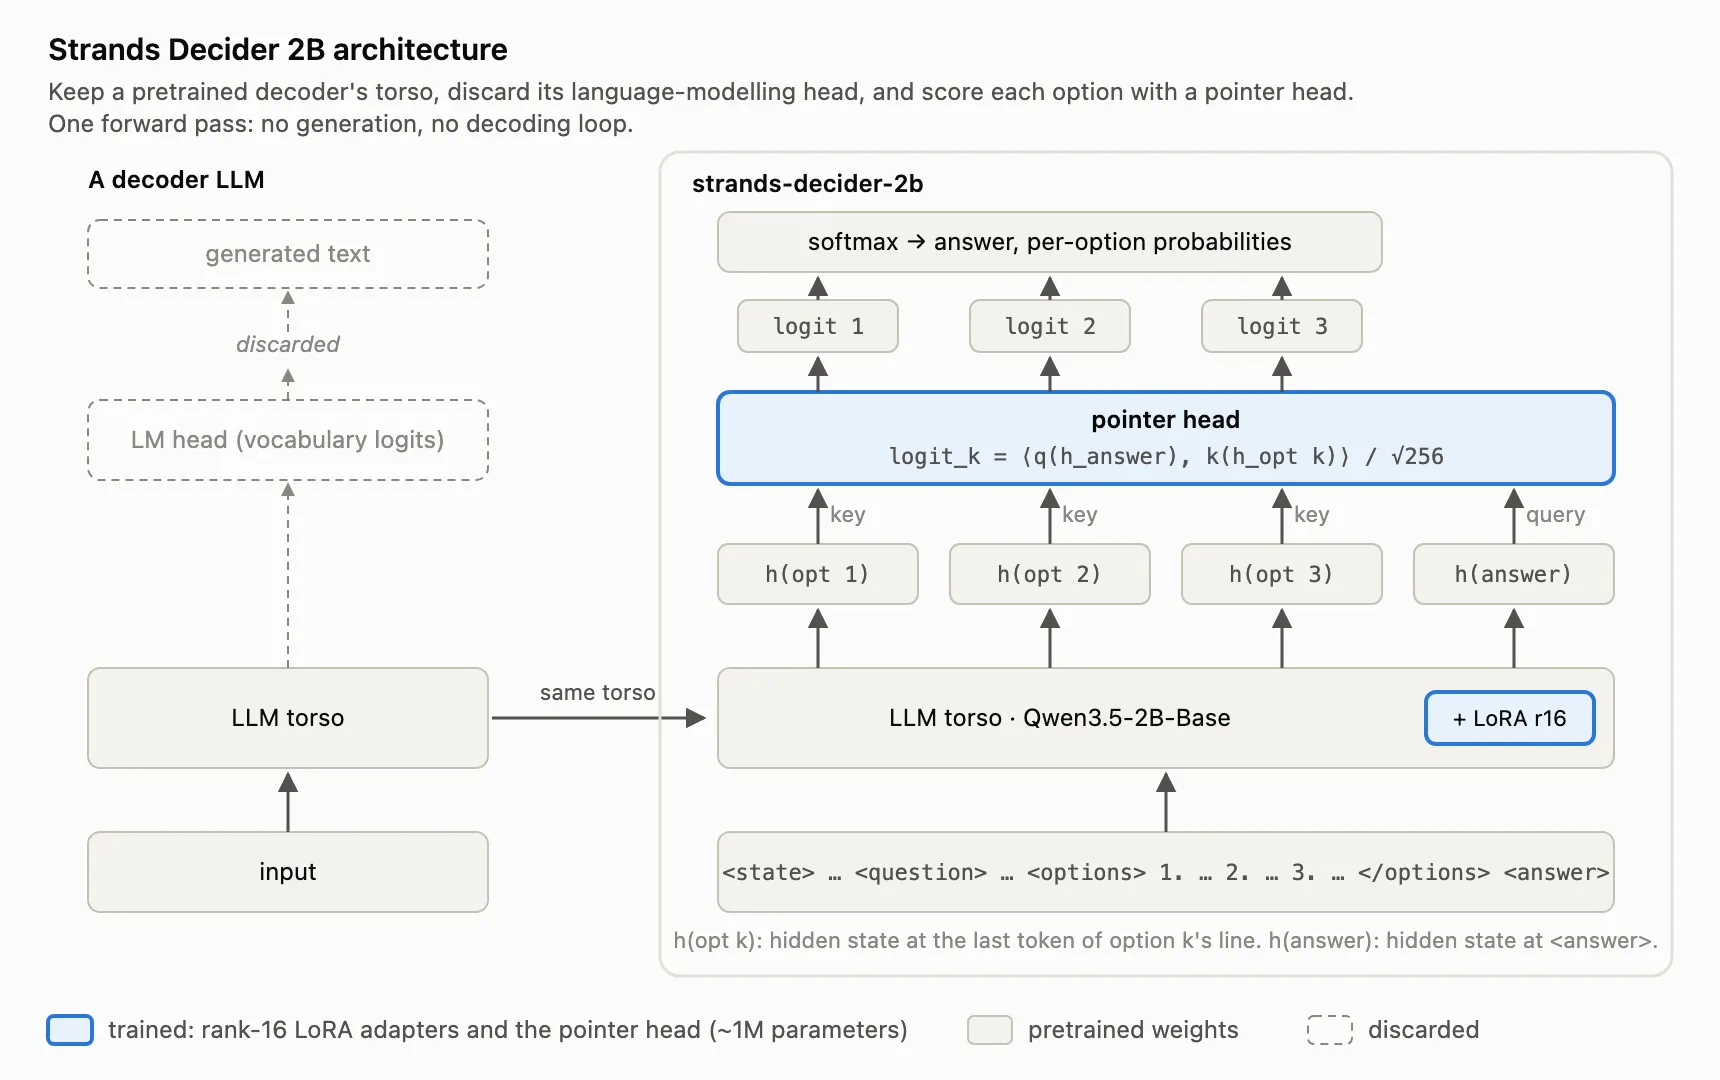
헤드에 선택지마다 따로 배정한 파라미터가 없어서 선택지 수에 상한이 없고, 첫 번째 선택지가 자주 정답이라는 식의 버릇을 배울 수도 없다는 것이 AWS의 설명입니다. 전체 파라미터는 19억 개이고, 레시피를 처음부터 다시 돌리는 데 RTX 3090 한 장으로 약 11시간, H100 8장으로 1시간 10분이 걸립니다.
AWS는 성능을 Benchmark Heaven이 운영하는 제3자 벤치마크 JevBench의 공개 과제 231개로 쟀습니다. Strands Decider는 167개를 맞혀 정확도 72.3%를 냈고, 9월 25일 순위표 기준으로 전체 89개 시스템 가운데 50위, 2B급 33개 가운데 3위였습니다. 질문 하나에 답하는 시간은 RTX 3090에서 중앙값 115밀리초, 애플 M3 Pro 맥에서 153밀리초였고, JevBench에서 확신도 0.9 이상으로 낸 답 53개는 모두 맞았습니다.
이 계열 모델에 처음 끌린 이유는 워크플로의 한 단계에서 지금 위치를 보고 다음에 할 일을 정하는 결정자로 꼭 맞기 때문이었습니다.— 마크 브루커, AWS 수석 엔지니어 (TechCrunch 인터뷰)
저장소에는 에이전트 안에서 쓰는 예제도 있습니다. 사용자가 장소를 말하지 않고 날씨를 물으면, 일부러 성급하게 만든 에이전트가 도시를 짐작해 날씨 도구를 부르려 합니다. 도구가 실행되기 직전 Strands Decider가 대화와 도구 호출을 읽고 「인자 값이 사용자가 실제로 한 말에 근거하는가」와 「지금 부르기엔 이른가」 두 질문에 답하면, 에이전트는 도구를 부르는 대신 어느 도시인지 되묻습니다. AWS는 이만큼 싼 판단은 LLM 호출을 넣을 수 없던 경로에도 넣을 수 있다고 적었습니다.
9월 20일 글에서 다룬 Jev와 이번 두 회사의 모델, 오픈AI의 Decisions API를 한 표에 모았습니다. 날짜는 미국 시각이고, 값은 입력 100만 토큰 기준입니다.
| 모델 | 만든 곳(공개일) | 크기(바탕 모델) | 입력 100만 토큰당 | 공개된 정확도 | 가중치 |
|---|---|---|---|---|---|
| Jev 1.13 | TypeSafe(9월 15일) | 비공개 | 0.042달러, 출력 무료 | Decision Index 57.9 | 비공개, API로만 |
| Clef | 클라우드플레어(10월 1일) | 274억(Qwen3.8-27B) | 0.24달러 | Decision Index 61.2(자체 보고) | 아파치 2.0 |
| Clef-flash | 클라우드플레어(10월 1일) | 94억(Qwen3.5-9B) | 0.09달러 | Decision Index 57.1(자체 보고) | 아파치 2.0 |
| Strands Decider 2B | AWS Strands Labs(10월 1일) | 19억(Qwen3.5-2B-Base) | 내려받아 직접 실행 | JevBench 공개 과제 72.3% | 아파치 2.0 |
| Decisions API | 오픈AI(9월 29일) | GPT-6 Luna 기반 | 미발표 | 미발표 | 비공개, 제한 프리뷰 |
| 모델 | 한 번에 넣는 분량 | 이미지 입력 | 응답 시간 |
|---|---|---|---|
| Jev 1.13 | 요청당 6만 4,000토큰(상태와 가장 긴 질문은 3만 2,000토큰) | 안 받음 | 클라우드플레어 측정 중앙값 524밀리초 |
| Clef | 6만 5,536토큰 | 요청당 4장 | 209밀리초 |
| Clef-flash | 6만 5,536토큰 | 요청당 4장 | 39밀리초 |
| Strands Decider 2B | 기본 4,096토큰 | 소개 없음 | RTX 3090 중앙값 115밀리초 |
| Decisions API | 미발표 | 받음 | 소티오 「몇백 밀리초 안」 |
입력 10억 토큰으로 환산하면 Jev는 42달러, Clef-flash는 90달러, Clef는 240달러를 받습니다. Strands Decider는 AWS가 따로 호스팅 가격을 내놓지 않았고, 돌리는 비용은 GPU나 맥을 마련하는 값이 정합니다.
클라우드플레어가 43개 평가에서 잰 응답 시간 중앙값은 Clef 209.3밀리초, Clef-flash 38.8밀리초, Jev 524.1밀리초였습니다. Jev보다 Clef는 2.5배, Clef-flash는 13.5배 빠르고, 클라우드플레어는 모델을 자기 네트워크 곳곳의 GPU에서 돌려 네트워크 지연까지 줄인다고 밝혔습니다. 에이전트가 판단할 때마다 거치는 경로에 Clef를 넣고, 행동은 Workers AI의 언어모델에 맡기라는 것이 클라우드플레어의 제안입니다.
한데 입력 단가를 견주면 Clef는 Jev의 5.7배, Clef-flash는 2.1배를 받습니다. TypeSafe는 Jev를 내놓으며 값은 앞으로 내려갈 것으로 본다고 적었고, 클라우드플레어는 가격 대신 속도와 이미지 입력, 공개 가중치를 앞세웠습니다.
가중치를 직접 돌리면 계산이 다시 달라집니다. Clef 모델 카드는 H200 한 장에서 시험했다고 적었고, Clef-flash는 94억 파라미터, Strands Decider는 애플 실리콘 맥이나 CPU에서도 돕니다. 이 경우 비용은 토큰 단가 대신 GPU를 빌리거나 사는 값과 요청량이 정합니다.
클라우드플레어는 발표 글에서 Clef가 Jev Decision Index 기준 1위라고 적었습니다. Jev Decision Index는 허깅페이스의 Jev 재현 추적 페이지가 여러 시험을 묶어 매기는 종합 점수이고, 발표 글의 그림에서 Clef는 61.2점, Jev는 57.9점, Clef-flash는 57.1점입니다. 같은 그림의 범례는 클라우드플레어 점수를 「자체 보고」로, 다른 공개 모델 점수를 「순위표 검증」으로 구분합니다.

발표 글 본문에는 시험 10개를 골라 실었고, 여기서는 Clef 계열이 7개에서 가장 높습니다. 모델 카드에 실린 Decision Index 시험 41개를 모두 보면 Clef와 Clef-flash 가운데 하나라도 Jev보다 나은 시험은 30개, Jev가 두 모델을 모두 앞선 시험은 11개입니다. Jev가 앞선 시험에는 대학원 수준 과학 문제 GPQA Diamond, 어려운 지식 문제 MMLU-Pro, 여러 단계 추론 문제 BBH처럼 생각을 여러 번 이어야 풀리는 시험이 몰려 있습니다.
| 시험 | 무엇을 재나 | Clef | Clef-flash | Jev |
|---|---|---|---|---|
| BANKING77 | 은행 문의 77가지 의도 분류 | 94.2 | 90.9 | 79.7 |
| CLINC150+OOS | 의도 150가지와 범위 밖 문의 가려내기 | 97.4 | 66.8 | 89.3 |
| 가전 시뮬레이터 | 가전 조작 명령 정확 일치 | 83.0 | 97.7 | 52.3 |
| GPQA Diamond | 대학원 수준 과학 문제 | 48.0 | 51.0 | 78.3 |
| MMLU-Pro | 어려운 지식 문제 | 65.9 | 65.3 | 82.7 |
| BBH | 여러 단계 추론 문제 | 73.7 | 68.9 | 92.9 |
표의 Jev 점수도 클라우드플레어가 직접 돌린 값입니다. TypeSafe가 만든 업무 흐름 평가 4개에서는 Clef가 3개를 앞섰지만 차이는 송장 처리 2.9점, 고객 서비스 0.3점, 보안 사고 1.2점이었고, 에이전트 실행 기록 관측에서는 Jev가 3.1점 앞섰습니다.
AWS 쪽 기록에도 비슷한 숫자가 있습니다. Strands Decider 저장소의 실험 기록을 보면, 학습을 전혀 하지 않은 Qwen3.5-4B에 선택지를 A부터 P까지 글자로 붙이고 그 글자의 확률만 읽는 방식(SemIf)이 같은 231개 과제에서 81.0%를 냈습니다. 같은 몸통을 쓴 Mapika의 decider-2b 최신판은 AWS의 측정에서 175개를 맞혀 Strands Decider보다 8개 많았습니다. JevBench 순위표 맨 위에는 추론 모델 GPT-6 Luna(99.6%)가 있고, AWS도 발표 글에서 결정 모델은 복잡한 문제에서 추론 모델보다 크게 뒤진다고 적었습니다.
사람들이 골드러시라고 생각하는 건 이해하지만, 모델을 정말 똑똑하게 만드는 일이 얼마나 어려운지 과소평가하고 있을지 모릅니다.— 디오고 알메이다, TypeSafe CEO (TechCrunch 인터뷰)
Jev가 나온 뒤 16일 동안 이어진 일을 날짜순으로 놓으면 이렇습니다. 9월 28일까지는 개인 개발자와 스타트업, 대기업 엔지니어의 실험이 이어졌고, 9월 29일부터 3일 사이에 오픈AI와 클라우드플레어, AWS가 공식 제품을 냈습니다.
| 날짜(미국 시각) | 있었던 일 |
|---|---|
| 9월 15일 | TypeSafe, Jev 공개(입력 100만 토큰 0.042달러, 출력 무료) |
| 9월 16일 | 매트 마스트라치, DiffusionGemma를 Jev처럼 쓰는 패치 공개(판단 한 번 약 0.21초) |
| 9월 18일 | 클라우드플레어 미셸 첸, DiffusionGemma로 만든 Jev식 데모 공개 |
| 9월 20일 | Jev, 대기자 명단 없이 공개 |
| 9월 24일 | Respan, 행동 판정 전용 Span-01 공개(입력 100만 토큰 0.02달러) |
| 9월 28일 | 마크 브루커, 개인 블로그에 2B 결정 모델 Hobson 소개 |
| 9월 29일 | 오픈AI, DevDay에서 Decisions API 제한 프리뷰 |
| 10월 1일 | 클라우드플레어 Clef·Clef-flash, AWS Strands Decider 2B 공개 |
오픈AI는 9월 29일 DevDay에서 Decisions API를 내놨습니다. TechCrunch에 따르면 샘 올트먼은 모델을 선택 하나에 집중시키면 이미지 이해와 폭넓은 언어 지원, 안전장치를 유지하면서도 매우 빠르게 만들 수 있다고 설명했습니다. 오픈AI 제품 책임자 티보 소티오는 이 API가 처음부터 끝까지 몇백 밀리초 안에 결정을 내리도록 조정됐다고 적었습니다.
@thsottiauxX 게시물 · 원문 보기
한 시간쯤 뒤 알메이다는 X에 「클론 전쟁이 시작됐다」는 농담을 올렸습니다. 그는 오픈AI를 좋아하고 경쟁과 검증은 개발자에게 좋은 일이라며, 시스템 원(TypeSafe가 빠른 직관적 판단을 부르는 이름) 방식에 맞춰 만드는 쪽이 미래라는 신호이길 바란다고 덧붙였습니다.
@CompleteSkepticX 게시물 · 원문 보기
클라우드플레어가 밝힌 이유는 사내 수요입니다. 신뢰·안전 신고 심사, 고객 지원 문의 분류, 크롤러가 좋은 봇인지 나쁜 봇인지 가리는 봇 제품처럼 아주 좁은 분류 일이 많고, 15년 넘게 쌓은 네트워크 데이터로 이런 일에 맞춘 모델을 다시 학습시킬 수 있다는 설명입니다. 발표 글은 Jev를 향한 반응이 빠르고 작고 특정한 분류 모델이 필요하다는 증거였고, 이 분야를 강화학습 실험의 출발점으로 골랐다고 적었습니다.
그래서 Clef와 함께 미세조정 서비스도 내놨습니다. 처음에는 현장 배치 엔지니어(FDE) 팀이 고객 업무에 맞춰 직접 학습시키고, 나중에는 고객이 데이터를 모아 학습하고 다시 배포하는 셀프서비스로 넓힌다는 계획입니다. AI Gateway가 실제 요청과 응답을 쌓고, Workers AI가 답을 뽑고, Containers가 채점 환경을 돌리고, 새 학습 도구가 가중치를 고치는 구성입니다.

AWS의 설명은 고객 쪽에서 나옵니다. 브루커는 TechCrunch에 이 모델이 필요하다는 생각이 AWS 고객과의 대화에서 나왔고, 고객의 에이전트 워크플로가 매번 완전한 LLM의 능력과 비용을 요구하지는 않는다고 말했습니다. AWS는 모델 라우팅, 도구 선택, 평가, 가드레일, 기억과 문맥 관리, 정책 분류를 쓰임으로 들었고, 어려운 결정은 LLM이 맡고 반복적인 결정은 결정 모델이 맡는 하이브리드 에이전트로 비용과 지연을 줄인 실험들을 소개했습니다.
만드는 데 드는 돈도 작아서, Strands Decider 레시피는 RTX 3090 한 장으로 11시간이면 다시 학습할 수 있습니다. TechCrunch에 따르면 브루커는 프런티어 연구소가 이 시장을 꼭 차지할 것으로 보지 않았고, 시장이 좁으면 쓸 만한 모델을 수백에서 수천 달러로 만들 수 있다고 봤습니다. JevBench 순위표에 오른 시스템은 1.2판의 52개에서 9월 25일 1.4.2판의 89개로 늘었고, Jev Decision Index가 9월 28일까지 추적하거나 채점한 모델은 74개였습니다.
클라우드플레어와 AWS가 이번에 낸 모델은 모두 알리바바의 큐원 위에 섰습니다. Clef는 Qwen3.8-27B, Clef-flash는 Qwen3.5-9B, Strands Decider는 Qwen3.5-2B-Base이고, 클라우드플레어가 비교한 Kev 9B와 뒤에서 볼 다키클라우드의 한국어 모델도 큐원을 썼습니다. Jev의 바탕 모델은 공개되지 않았습니다.
결정 모델이 줄이는 것은 에이전트 비용의 일부입니다. 9월 20일 글에서 다룬 사기 메일 판별에서는 Jev가 메일 100통을 1.42초에 걸렀지만, 확신이 95%에 못 미친 31통을 넘겨받은 Kimi K3가 비용의 96%를 썼습니다. 다음 날 글의 Minecraft 실험에서도 조작을 맡은 Jev는 0.01달러, 계획을 세운 GPT-6 Astra는 0.96달러를 썼습니다.
이런 구성에서 청구서를 정하는 것은 결정 모델의 단가보다 넘겨지는 비율과 넘겨받는 모델의 값입니다. 확신도가 믿을 만해야 넘길 것만 넘길 수 있고, 기준을 높게 잡을수록 넘겨지는 비율과 큰 모델 비용이 함께 늘어납니다. 9월 28일 글에서 다룬 Respan의 Span-01은 입력 100만 토큰당 0.02달러에 행동 판정을 맡으면서, 이제 LLM 판정을 치울 때라고 내세웠습니다.
세 회사 모두 한국어 점수는 내놓지 않았습니다. TypeSafe 문서는 영어가 주 학습 언어이고 한중일 문자는 처리하지만 같은 수준은 아니라고 적었고, 클라우드플레어와 AWS의 발표에는 언어별 결과가 없습니다. 브루커는 TechCrunch에 정확도와 보정을 끌어올리면서도 여러 언어를 이해하는 능력과 지식을 떨어뜨리지 않는 균형을 찾기가 까다롭다고 말했습니다.
한국어로 Jev를 잰 숫자는 국내 회사 다키클라우드가 내놨습니다. 다키클라우드는 9월 24일 기술 블로그에 Jev와 같은 /v1/systemone 형식으로 답하는 한국어 결정 모델 K-Decision(kd-4b-ko-v0)을 공개하고, 같은 질문을 Jev와 함께 돌린 결과를 실었습니다.
| 시험 세트 | 문항 | K-Decision | Jev | 다키클라우드의 해석 |
|---|---|---|---|---|
| 한국 법령 발췌 | 39 | 98.8% | 97.4% | 차이가 통계적으로 유의하지 않음 |
| 한국 정책 문서 | 119 | 83.1% | 93.3% | Jev가 유의하게 앞섬 |
| KoBEST·KLUE 변환 과제 | 1,981 | 87.7% | 81.8% | K-Decision이 학습한 분포라 유리 |
다키클라우드는 자기 모델이 학습한 분포에서는 앞서고, 처음 보는 정책 문서에서는 Jev가 앞섰다고 정리했습니다. 법령 세트는 원래 57문항이었지만 Vercel 게이트웨이를 거친 Jev가 눈금이 10개를 넘는 점수형 질문을 받지 않아 39문항만 비교됐습니다. 이 회사가 한국어판을 만든 이유로 든 것은 망 분리입니다. 금융·보험·공공·국방 고객은 문서를 사내망 밖으로 보낼 수 없는데 Jev는 클라우드 API로만 쓸 수 있고, AI 허브 데이터로 학습한 가중치는 공개할 수 있어도 데이터는 나라 밖으로 내보낼 수 없다는 설명입니다.
이런 조건에서는 이번 두 회사의 공개 가중치가 후보에 오릅니다. Clef와 Clef-flash, Strands Decider 모두 아파치 2.0 가중치라 사내 GPU에 올릴 수 있고, Strands Decider는 학습 데이터와 스크립트까지 공개돼 자기 데이터로 다시 학습할 수 있습니다. 다만 한국어 정확도는 자기 문서로 재기 전에는 알 수 없고, 다키클라우드의 측정에서도 처음 보는 정책 문서에서는 Jev와 8.4%포인트 차이가 났습니다.
오픈AI는 Decisions API를 며칠 안에 넓게 풀겠다고 했고 가격은 아직 밝히지 않았습니다. 클라우드플레어는 강화학습 미세조정을 셀프서비스로 넓힐 계획이고, AWS는 Strands 에이전트에 결정 모델을 붙이는 라이브러리를 만들고 있다고 밝혔습니다. TypeSafe의 최신판은 여전히 jev-1.13입니다. 오픈AI의 가격이 나오면 다섯 가지 선택지의 값을 다시 맞춰 보겠습니다.
읽어 주셔서 고맙습니다.
초이 드림


