이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
판단 전용 모델에서 오래 남는 것은 특정 모델보다 선택지를 주고 확률을 돌려받는 호출 방식이다
9월 21일 기준 근거는 6일 사이 나온 Jev식 공개 모델 4개와 Claude Code 라우터, Vercel AI Gateway 연결입니다.
9월 20일(미국 시각)부터 대기자 명단 없이 가입할 수 있고, 모든 사용자에게 약 1억 2,000만 토큰어치인 5달러 크레딧을 줍니다. 서비스는 미국 서부에 있고 영어에서 정확도가 가장 높습니다.
Bespoke-Nimble-9B와 Laya는 가중치가 Apache 2.0, CUA-S1-FORMS는 MIT 라이선스입니다. 공개된 비교에서 Nimble은 사람 라벨 3,880건 일치율 75.9%로 Jev의 77.3%에 조금 못 미쳤습니다.
Cua의 폼 작성 전용 모델은 자기 과제에서 99.7%로 Jev의 83.6%를 앞섰습니다. 다만 무엇을 할지 판단하는 결정만 보면 Jev도 추가 학습 없이 96%를 맞혔습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
클라우드플레어가 10월 2일 0시 34분 결정 모델 Clef를, AWS가 30분쯤 뒤 Strands Decider 2B를 오픈소스로 냈습니다. Jev 공개 16일, 오픈AI Decisions API 발표 이틀 만입니다.

뉴욕시의회가 10월 5일 AI 4사 정책 책임자를 선서시키고 에이전트가 안전장치를 늘 지키느냐고 물었지만 보장한 회사는 없었습니다. 회사를 떠난 연구자 3명도 증언했고, 의회는 제3자 검증·신고 보상 법안 10건을 심사했습니다.
CopilotKit이 10월 1일(미국 시각) 오픈AI dots의 오픈소스 대안 OpenDots를 MIT 라이선스로 공개했습니다. 저장소는 dots 키노트 도중 만들어졌고 첫 코드는 5시간 16분 만에 합쳐졌습니다. 코드는 무료이고 모델과 대화 저장 비용은 따로 듭니다.
클라우드플레어가 10월 2일 0시 34분 결정 모델 Clef를, AWS가 30분쯤 뒤 Strands Decider 2B를 오픈소스로 냈습니다. Jev 공개 16일, 오픈AI Decisions API 발표 이틀 만입니다.

뉴욕시의회가 10월 5일 AI 4사 정책 책임자를 선서시키고 에이전트가 안전장치를 늘 지키느냐고 물었지만 보장한 회사는 없었습니다. 회사를 떠난 연구자 3명도 증언했고, 의회는 제3자 검증·신고 보상 법안 10건을 심사했습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@typesafeaiX 게시물 · 원문 보기
TypeSafe는 모든 사용자에게 5달러어치 크레딧을 주고, 이 돈으로 약 1억 2,000만 토큰을 쓸 수 있다고 덧붙였습니다. 입력 100만 토큰에 0.042달러를 받고 출력에는 요금을 매기지 않는 가격표로 계산하면 맞는 숫자입니다. 문을 연 날 한국 시각 오후 5시 30분에는 API와 콘솔에 장애가 났다는 공지가 올라왔고, 약 1시간 20분 뒤 복구됐다는 공지가 이어졌습니다.
Jev가 어떤 모델이고 공개 뒤 3일 동안 어떤 사례가 나왔는지는 전날 정리한 첫 15건의 계산서에 있습니다. 이 글은 그다음 이야기, 모델 하나를 둘러싸고 6일 사이에 생긴 것들을 다룹니다.
사례 모음 사이트 Jevable은 벤처캐피털 FPV의 파트너 니쿤지 코타리가 만들었습니다. 그는 한국 시각 9월 19일 아침 X에 올라온 Jev 데모를 갈래별로 걸러 볼 수 있는 사이트를 열었다고 알렸고, 누구나 자기 프로젝트를 올릴 수 있게 했습니다. 사이트에 모인 데모 194개는 모두 9월 16일부터 20일 사이에 X에 올라온 것입니다.
@nikunjX 게시물 · 원문 보기
날짜별로 세면 한국 시각으로 16일 4개, 17일 25개였던 데모가 18일 84개, 19일 79개로 늘었습니다. 데모가 늘기 시작한 17일 아침 TypeSafe는 대기자 명단에서 사람들을 한꺼번에 대거 풀었다고 알렸고, 1시간 40분 뒤에는 Vercel AI Gateway에서도 Jev를 쓸 수 있게 했습니다.
| 갈래 | 데모 수 |
|---|---|
| 게임 | 39 |
| 개발 도구 | 34 |
| 생산성 | 31 |
| 에이전트 | 19 |
| 실험 | 18 |
| 창작 도구 | 16 |
| 데이터·리서치 | 9 |
| 금융 | 8 |
| 로보틱스 | 7 |
| 브라우저 확장 | 7 |
| 마케팅 | 6 |
아래 12개 데모를 만든 사람 가운데에는 구글의 AI 제품 담당자, 클라우드플레어 엔지니어, 문서 처리 회사 라마인덱스의 CEO, 오픈AI 직원이 있습니다. 모두 공개된 지 일주일이 안 된 스타트업의 API를 며칠 만에 붙여 만든 것입니다.
클라우드플레어의 스티브 포크너는 9월 18일(한국 시각) 장난감 프로그래밍 언어 Probably를 공개했습니다. 사람들이 Jev를 「AI if문」이라고 부르는 것을 보고 정말 if문으로 만들어 봤다는 설명입니다. 「feels」는 질문을 던지고, 「match」는 설명 가운데 맞는 쪽으로 보내고, 「while」은 무언가가 참으로 느껴지지 않을 때까지 반복합니다. 판단은 Jev가, 글쓰기는 LLM이 맡고 작은 프로그램이 둘을 잇습니다.
AI 회사 SPIRITT의 CEO 타미르가 만든 JevForm은 앞의 답을 보고 다음 질문을 고르는 설문 폼입니다. 그는 평생 복잡한 if/then 논리로 폼을 수백 개 만들었는데 Jev가 그 문제를 풀었다고 적었고, 화면은 Vercel의 json-render로, 상태 관리는 xstate로 붙였습니다. 오픈AI에 다니는 드미트리 코발렌코의 Jevassembler는 한 걸음 더 나갔습니다. 작업을 주면 Jev가 CPU가 실행할 다음 명령어를 실행 중에 하나씩 고르게 해서, 코드를 쓰거나 컴파일하지 않고 프로그램을 돌려 본 실험입니다.
@southpolesteveX 게시물 · 원문 보기
미리 만들어 둔 부품 가운데 알맞은 것을 고르는 데모가 가장 많았습니다. X 사용자 LTV는 구스타보(@heyimgustavo)가 만든 무한 FAQ에 Vercel의 json-render와 Jev를 붙였습니다. LLM이 답변을 쓰면 Jev가 화면 구성요소를 고르고, json-render가 제품 대시보드 화면을 밀리초 단위로 그립니다. Thesys의 창업 엔지니어 Zahle Khan은 생성형 UI 실험으로, 입력하는 내용을 읽고 다음 행동을 제안하는 키보드 jev board를 만들었습니다.
중국의 AI 뉴스레터 필자 구이짱(歸藏)은 설명을 넣으면 3D 실내를 꾸며 주는 도구를 만들었습니다. 미리 준비한 3D 모델 수십에서 100여 개 가운데 필요한 것을 고르는 판단을 수백 번 동시에 돌리고, 색과 조명, 위치까지 정해 약 1초 만에 방 하나를 채웁니다. 그는 몇 시간 뒤 이 도구를 누구나 써 볼 수 있게 공개했습니다.
@op7418X 게시물 · 원문 보기
입력과 검색에도 같은 방식이 쓰였습니다. 스타트업 창업자 마커스 로는 복사한 글을 읽고 이름과 주소 같은 입력란에 나눠 붙이는 Jaste를 베타로 내놨고, 구글의 AI 제품 담당자 슈밤 사부는 낱말이 아닌 뜻으로 페이지를 찾는 크롬 확장을 오픈소스로 공개했습니다. 사부는 Vercel이 게이트웨이에서 한동안 Jev를 무료로 풀어 준 덕에 실험할 수 있었다고 적었습니다.
라마인덱스의 공동창업자 제리 리우는 9월 21일 새벽 문서 분류·분할 오픈소스 라이브러리 DocJev를 공개했습니다. 문서와 자연어로 쓴 분류 기준을 주면 Jev가 문서 종류를 맞히거나, 여러 문서가 섞인 파일에서 문서가 바뀌는 경계를 찾습니다. 그는 GPT-5.6 Luna와 같은 정확도로 6배 빠르다고 적었습니다.

한데 보고서 그림을 보면 조건이 붙어 있습니다. 문서 분류는 둘 다 40개 중 40개를 맞혔지만, 여러 문서를 묶은 파일 8개의 경계를 찾는 과제에서는 Jev가 7개, Luna가 8개를 정확히 나눴습니다. 표본은 작게 고른 PDF 40개이고, 판단 시간에는 글자 인식(OCR)이 빠져 있으며, 정답 라벨은 에이전트가 검토했다고 그림 아래에 적혀 있습니다.
개발자 키체(kitze)가 무료 오픈소스로 공개한 Unclutter는 웹페이지에서 광고와 쿠키 배너, 유료 전환 권유, 쓸데없는 대화 상자를 찾아 치웁니다. AI 에이전트 데이터 회사 Asymptote Labs의 오픈소스 Beacon은 원래 여러 코딩 에이전트의 작업 기록을 한곳에 모으는 도구입니다. 9월 21일 개발자 아비 차울라가 Beacon이 Jev로 그 기록을 거르는 과정을 영상으로 소개했고, Asymptote Labs가 그 글을 인용해 알렸습니다. Jev가 세션마다 증거, 다른 작업에 다시 쓸 가능성, 사람이 고쳐 준 흔적을 점수로 매기면 정책 코드가 그 세션을 채택·검토·폐기로 나누고, 채택한 교훈은 Claude Code와 Codex, Cursor, OpenCode 같은 다른 에이전트가 쓰는 스킬로 바뀌어 저장됩니다.
전날 글에서 본 Minecraft 생방송에서는 혼자 조작을 맡은 Jev가 48시간 넘게 돌을 캐지 못했습니다. 9월 20일 트래젝터리 랩스 공동창업자 로낙 말데는 역할을 나눴습니다. Jev가 WASD 이동과 점프, 클릭, 마우스를 조작하고, GPT-6 Astra가 계획을 세워 Jev에게 따로 지시를 보냈습니다. 에이전트가 실패할 때마다 Astra가 다음에 쓸 기술을 파일로 추가했고, 그렇게 쌓은 끝에 엔더 드래곤을 8분 43초에 잡았습니다.
@rronak_X 게시물 · 원문 보기
비용은 1달러가 안 됐습니다. Jev가 0.01달러, Astra가 0.96달러로, 돈의 99%는 계획을 맡은 큰 모델이 썼습니다. 그는 스피드런에 흔히 쓰는 Minecraft 1.16.5 시드에서 기록을 냈고, 코드를 공개하며 다음에는 이 행동을 오픈소스 모델에 추가 학습시켜 보겠다고 적었습니다.
앞에서 다루지 않은 데모까지 12개를 모으면 아래와 같습니다. 이름을 누르면 만든 사람의 원본 게시물로 이동합니다.
| 데모 | 하는 일 | 만든 사람 |
|---|---|---|
| Unclutter | 광고·쿠키 배너·권유 팝업 제거 | 키체 |
| jev board | 입력을 읽고 다음 행동 제안 | Zahle Khan |
| Probably | Jev를 조건문으로 쓰는 언어 | 스티브 포크너 |
| JevForm | 답에 따라 다음 질문 선택 | 타미르 |
| Jevassembler | 다음 CPU 명령어를 실행 중 선택 | 드미트리 코발렌코 |
| 3D 실내 꾸미기 | 3D 모델 수십~100여 개 중 골라 약 1초에 배치 | 구이짱 |
| Minecraft 스피드런 | Astra 계획, Jev 조작, 8분 43초 | 로낙 말데 |
| 뜻으로 찾는 ⌘F | 낱말 대신 뜻으로 페이지 검색 | 슈밤 사부 |
| DocJev | 문서 분류와 경계 찾기 | 제리 리우 |
| FAQ 화면 구성 | 답변에 맞는 화면 부품 선택 | LTV |
| Jaste | 복사한 글을 입력란에 나눠 붙이기 | 마커스 로 |
| Beacon | 에이전트 작업 기록에서 교훈 선별 | Asymptote Labs |
Jev의 가중치는 공개되지 않았습니다. 같은 방식을 직접 돌려 보려는 시도는 공개 다음 날 나왔습니다. 개발자 매트 마스트라치는 한국 시각 9월 17일 아침, 구글의 텍스트 확산 모델 DiffusionGemma에 Jev의 아이디어를 빌린 vLLM 패치를 올리며 「우리 집에도 Jev가 있다」고 적었습니다. 답의 형식을 고정해 두고 확률만 읽는 방식으로, 엔비디아 DGX Spark 한 대에서 판단 한 번에 약 0.2초가 걸렸습니다.
@mmastracX 게시물 · 원문 보기
그로부터 이틀 사이 새 모델이 줄줄이 나왔고, 구글 Gemma 공식 계정도 9월 19일(한국 시각) 「Jev로서의 DiffusionGemma」를 소개했습니다. 네 모델이 내놓은 비교는 아래와 같습니다.
| 모델 | 만든 곳 | 방식 | 공개된 비교 |
|---|---|---|---|
| DiffusionGemma as Jev | 매트 마스트라치 | 구글 DiffusionGemma에 vLLM 패치 | DGX Spark 한 대에서 판단당 약 0.2초 |
| Bespoke-Nimble-9B | Bespoke Labs | Qwen3.5-9B를 2,676개 예시로 추가 학습 | 사람 라벨 3,880건 일치율 75.9%, Jev 77.3% |
| CUA-S1-FORMS | Cua | 파라미터 70만 개, 2.8MB 폼 작성 전용 | 폼 작성 평가 99.7%, Jev 83.6% |
| Laya | ConvAI Innovations | 인코더 모델, 가중치 Apache 2.0 | 질문 하나 32.8ms, Banking77은 Jev 0.870 대 0.425 |
Bespoke Labs는 Nimble을 하루 만에 만들었고 Jev의 답을 베껴 배우지 않았다고 밝혔습니다. 대신 데이터를 고르는 방법을 공개했는데, 사실 하나를 바꿔 정답이 뒤집히게 만든 예시로 학습시키는 방식입니다. 따로 떼어 둔 324개 문제에서는 Nimble이 90.1%, Jev가 93.2%, 추가 학습 전 Qwen3.5-9B가 66.4%였습니다.
Laya의 비교는 조건이 다릅니다. Laya 쪽 숫자는 직접 쟀지만 Jev 쪽 숫자는 제3자가 공개한 측정을 옮긴 것이라 표본과 질문이 다르고, Banking77도 Jev는 라벨 72개, Laya는 77개로 잰 값입니다. Laya는 선택지가 20개를 넘으면 라벨 하나에 돌아가는 토큰이 3~4개로 줄어 성능이 떨어진다고 스스로 적었습니다. TypeSafe는 Jev가 선택지를 255개까지 받는다고 밝혔습니다.
도구를 만드는 Cua의 CUA-S1-FORMS는 폼에 있는 요소마다 FILL(값 채우기), CHECK(체크), CLICK(제출), SKIP(건너뛰기) 가운데 하나를 고르는 모델입니다. 값은 문서에서 뽑은 것 가운데서만 고르고, 순서는 바깥 코드가 정합니다. 같은 과제를 실제 Jev API에 맡겼더니 CUA-S1은 99.7%, Jev는 83.6%를 받았습니다.
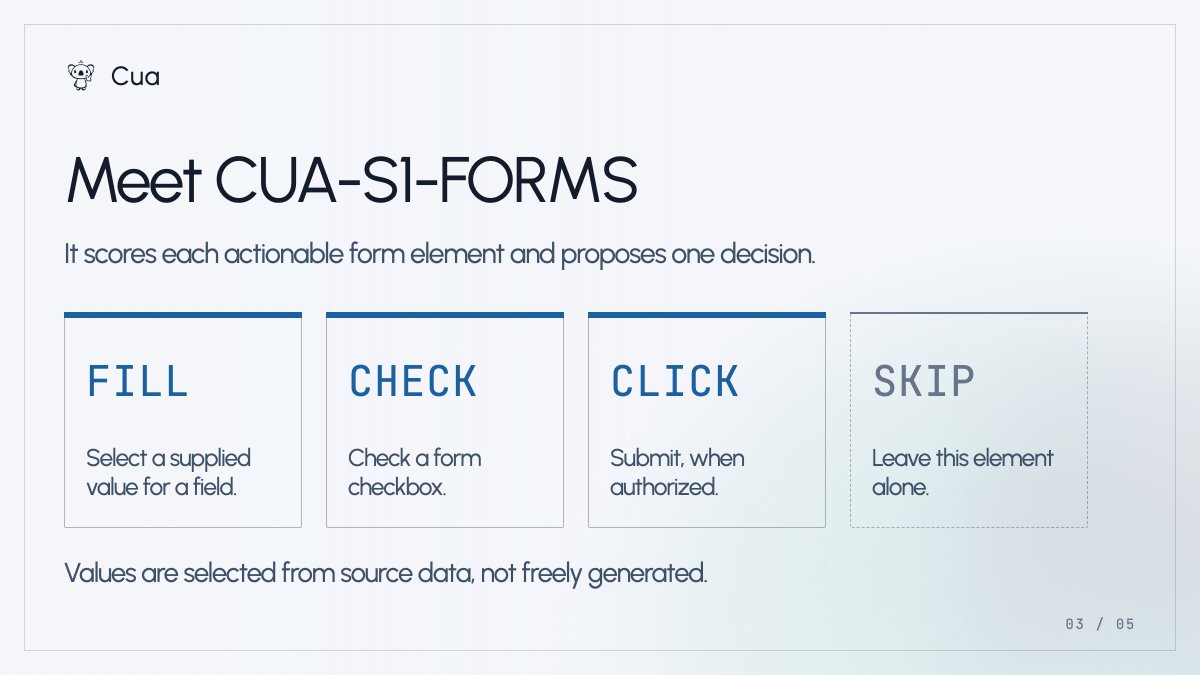
한데 세부를 보면 차이가 어디서 났는지 보입니다. 채우기와 체크, 클릭 가운데 무엇을 할지 판단해야 하는 결정에서는 Jev도 96%를 맞혔고, 크게 틀린 곳은 이미 채워진 입력란을 손대지 않고 넘기는 결정(74%)이었습니다. Cua의 모델은 그 약속을 학습했고 Jev는 배운 적이 없습니다. Cua는 자기 모델이 합성 폼과 실제 판단 196개로만 검증됐다고 한계도 함께 적었습니다.
AI 엔지니어 조시 쿠클리는 이 결과를 인용해, Jev는 학습 없이 바로 분류하는 데 뛰어나지만 상업적 쓰임은 전용 분류기가 차지할 것이라고 봤습니다. 그는 GLiNER 2.5를 51분 동안 추가 학습시켜 한 과제에서 Jev를 크게 앞섰고, 로컬에서 8.8배 빨랐다고 적었습니다.
@JoshKuechlyX 게시물 · 원문 보기
TypeSafe는 이런 비교를 반기는 쪽입니다. 디오고 알메이다 CEO는 공개 다음 날 공개 벤치마크는 나쁜 행위자에게 유리하다며 좋은 점수가 나오더라도 앞세우지 않기로 미리 정했다고 적었고, 회사 계정은 9월 19일 Jev가 어디서 나쁜지 알려 달라고 올렸습니다. TypeSafe가 낸 비교는 자체 업무 흐름 평가뿐이어서, 공개된 시험지로 Jev를 다른 모델과 견준 숫자는 모두 바깥 개발자들이 만들었습니다.
데모와 비교만 나온 것은 아닙니다. 헤지니어의 AI 책임자 대니얼 아빌라(X 이름 Daniel San)는 9월 19일 Claude Code 확장 Jev Model Router를 공개했습니다. Claude Code에 요청이 들어올 때마다 Jev에게 세 가지를 한꺼번에 묻습니다. 일이 기계적인지, 보통인지, 어렵거나 위험한지, 추론이 얼마나 필요한지를 네 단계로, 그리고 운영 환경이나 돈, 인증 정보, 되돌릴 수 없는 상태를 건드리는지입니다.
@dani_avila7X 게시물 · 원문 보기
라우터는 이 답을 비대칭으로 씁니다. 기본 등급은 haiku, sonnet, opus 셋이고, 더 비싼 모델이나 더 긴 추론으로 올리는 결정은 확신도 0.3이면 따르고, 더 싼 쪽으로 내리는 결정은 0.6이 넘어야 따릅니다. 위험 질문의 확률이 0.7을 넘으면 확신도와 상관없이 가장 강한 등급으로 보냅니다. 하위 에이전트의 모델은 기본으로 Jev가 고르지만 대화 중인 메인 모델은 기본값에서 바꾸지 않는데, 중간에 모델을 바꾸면 프롬프트 캐시가 깨져 아낀 돈보다 더 쓸 수 있기 때문입니다. 추론 강도를 한 단계 올릴 때 비용이 어떻게 달라지는지는 Claude Code의 모델과 노력 설정을 풀어 쓴 글에 있습니다.
아빌라는 공개 12시간쯤 뒤 사람들이 벌써 확장을 시험하고 고치고 있다며, Vercel AI Gateway 연결 문제를 고친 풀 리퀘스트가 들어왔다고 알렸습니다. TypeSafe 문서의 활용 사례 목록에도 모델 라우팅과 LLM 오류 검출처럼 에이전트의 실행 틀(하네스)을 다듬는 쓰임이 한 갈래로 올라 있습니다.
Jev는 이제 대기 없이 쓸 수 있지만 서비스는 미국 서부에 있고, TypeSafe 문서는 영어에서 정확도가 가장 높다고 적었습니다. 이 6일 사이 한국어 숫자를 낸 쪽은 Laya 하나였습니다. Laya가 9월 20일 저장소에 올린 51개 언어 측정에서 한국어 의도 분류(선택지 20개, 무작위로 찍으면 5%)는 다국어판이 45.0%, 영어판이 11.0%였습니다. Jev의 한국어 점수는 공개되지 않았습니다.
직접 돌릴 수 있는 선택지는 늘었습니다. Laya와 Nimble은 가중치가 Apache 2.0이고, Nimble은 애플 실리콘 맥이나 엔비디아 GPU에서 돌아가며, CUA-S1은 MIT 라이선스의 2.8MB 파일입니다. 데이터를 밖으로 보내기 어려운 국내 조직이라면 폼 작성처럼 좁고 반복되는 일은 Cua처럼 자기 데이터로 작은 모델을 학습시키는 길과, 넓은 판단은 Jev API에 맡기는 길을 나란히 놓고 따져 볼 수 있게 됐습니다.
저는 Jev라는 모델 하나보다 선택지를 주고 확률을 돌려받는 호출 방식이 더 오래 남을 것으로 봅니다. 6일 사이 이 방식을 흉내 낸 공개 모델이 4개 나왔고, 이 방식으로 판단을 받는 Claude Code 확장과 게이트웨이 연결이 생겼습니다. TypeSafe는 첫 발표에서 가격이 앞으로 내려갈 것으로 본다고 적었습니다.
읽어 주셔서 고맙습니다.
초이 드림