이 글 어땠어요?
토큰 가격표(100만 토큰당 입력 10달러, 출력 50달러)는 같고 캐시 읽기만 1달러에서 0.25달러로 내렸습니다. 앤트로픽은 기본 강도의 실제 사용량 기준으로 약 25%, 에이전트 작업은 최대 45% 싸진다고 했고, Artificial Analysis는 최고 강도에서 출력 토큰이 늘어 과제당 비용이 20% 올랐다고 쟀습니다.
심사를 거친 사이버 보안·생명과학 기관만 신뢰 접근 프로그램으로 쓸 수 있고, 지금은 미국 기관에만 열려 있습니다. Fable 5.1은 모든 플랫폼에서 쓸 수 있습니다.
프롬프트는 한 번이어도 서브에이전트 5개를 띄운 사례가 있고, 비용이나 추론 강도를 밝히지 않은 영상이 많습니다. 조건을 밝힌 비교는 가장 높은 추론 강도에서 18분에 12.6달러가 들었습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
Opus 5.5 공개 뒤 정리한 사례 40건 가운데 16건은 이미지·영상 모델 없이 코드로 그림과 소리를 만들었습니다. 12시간을 맡긴 뮤직비디오와 6억 9,700만 토큰짜리 데모까지 나왔지만 성공률을 밝힌 사례는 없었습니다.
7월 24일 나온 Claude Opus 5로 사용자들이 만든 3D 결과물 15건을 모았습니다. 같은 3D 작업에서 Opus 5는 4.2달러, Fable 5는 9.6달러였고, 성공은 규칙을 코드로 적는 작업에, 실패는 관찰과 물리 계산에 몰렸습니다.
수출통제로 막혔던 Claude Fable 5가 7월 1일 돌아오자 주간 한도의 50%를 추가 요금 없이 쓰는 동안 게임과 3D 결과물이 쏟아졌습니다. 프롬프트 4번에 173달러, 슈팅 게임 한 편에 150달러 같은 청구서도 함께 올라왔습니다.
Opus 5.5 공개 뒤 정리한 사례 40건 가운데 16건은 이미지·영상 모델 없이 코드로 그림과 소리를 만들었습니다. 12시간을 맡긴 뮤직비디오와 6억 9,700만 토큰짜리 데모까지 나왔지만 성공률을 밝힌 사례는 없었습니다.
7월 24일 나온 Claude Opus 5로 사용자들이 만든 3D 결과물 15건을 모았습니다. 같은 3D 작업에서 Opus 5는 4.2달러, Fable 5는 9.6달러였고, 성공은 규칙을 코드로 적는 작업에, 실패는 관찰과 물리 계산에 몰렸습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@claudeaiX 게시물 · 원문 보기
두 모델은 같은 모델에 안전장치만 다르게 건 관계입니다. Fable 5.1은 모든 플랫폼에 열렸고, 사이버 보안과 생명과학용 안전장치를 푼 Mythos 5.1은 심사를 거친 기관에만, 지금은 미국 기관에만 제공됩니다. 앤트로픽은 출시 당일 모든 사용자의 5시간 한도와 주간 한도를 초기화했고, Fable 5.1의 기본 추론 강도는 Claude Code에서 High, Claude.ai와 Cowork에서 Medium으로 잡았습니다.
에이전트는 한 턴이 끝날 때마다 지금까지 쌓인 대화와 파일 내용을 모델에 통째로 다시 보냅니다. 캐시는 이미 처리한 이 앞부분을 저장해 뒀다가 다음 턴에 싸게 읽는 장치이고, 여기서 읽는 토큰에 매기는 값이 캐시 읽기 요금입니다. Fable 5에서 100만 토큰당 1달러였던 이 값이 Fable 5.1에서 0.25달러가 됐습니다.
앤트로픽이 내놓은 25%와 45%는 8월 4주 동안의 실제 사용량을 기본 강도로 다시 계산한 값입니다. 공개한 그래프에서 읽으면 Claude Enterprise와 Claude Code, API를 합친 보통 작업에서는 캐시 읽기가 Fable 5 비용의 약 40%를 차지했고, 문맥과 도구를 많이 쓰는 에이전트 작업에서는 약 65%였습니다. 캐시 비중이 큰 작업일수록 인하 폭이 커지는 구조입니다.

성능표도 함께 나왔습니다. 가장 크게 오른 것은 과학 연구 과제를 터미널에서 푸는 Terminal-Bench-Science로, Fable 5의 두 배를 넘었습니다.
| 평가 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| Humanity's Last Exam(도구 없이) | 60.9% | 57.8% | 56.6% | - |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
표는 앤트로픽 발표 기준이고, 안전장치를 켠 채 잰 값입니다. 안전장치가 개입한 과제는 OSWorld 2.0(두 Fable 모델)과 AutomationBench(Fable 5)에서만 0점으로 셌고, 나머지는 사이버 과제를 Opus 4.8이, 생물학 과제를 Opus 5가 대신 풀었습니다. 안전장치를 푼 Mythos 5.1은 Terminal-Bench 4.0에서 60.9%로 Fable 5.1보다 5.1포인트 높았는데, 앤트로픽은 이 차이가 예전의 덜 정교한 사이버 안전장치가 막은 과제에서 나왔다고 설명했습니다. 낮은 강도의 Fable 5.1이 Fable 5 최고 강도의 점수를 따라잡은 과학 평가는 앞선 발표 정리에 적었습니다.
첫 결과물은 앤트로픽 안에서 나왔습니다. 앤트로픽의 알렉스 앨버트는 출시 한 시간이 채 안 돼, 빈 집터 사진 한 장을 주자 Fable 5.1이 그 땅에 맞는 집을 설계하고 렌더링한 뒤 집 안팎을 둘러보는 영상까지 코드로 만들었다며 결과를 올렸습니다.
@alexalbert__X 게시물 · 원문 보기
AI 개발 방송을 하는 BridgeMind(@bridgemindai)는 마리오 카트를 닮은 3D 레이싱 게임을 올리며 Fable 5.1이 한 번에 만들어 냈다고 적었습니다. 댓글에서 비용을 묻자 얼마가 들었는지는 모르겠다며, Fable 5.1 서브에이전트 5개를 띄워 방송하면서 만들었다고 답했습니다. 프롬프트는 한 번이었지만 그 아래에서는 에이전트 다섯이 일을 나눠 맡았습니다.
@bridgemindaiX 게시물 · 원문 보기
Max(@MozeTech)는 긴 요구사항 문서 없이 음성 받아쓰기로 크로시 로드 게임의 특징을 두서없이 말했는데 플레이할 수 있는 게임이 한 번에 나왔다고 했습니다. Techartist(@techartist)는 후지산을 오르는 판타지 3D 세계를 한 번에 코드로 만들었고, wick(@holytrinity)은 한 시간 전 GLM 5.3에 줬던 병 속의 배 프롬프트를 Fable 5.1에 그대로 넣어 결과를 나란히 올렸습니다. 중국어로 글을 쓰는 SuSu(@NFT\Chen)는 4행정 디젤 엔진을 뜯어 보여 달라고 했는데, 점화 플러그 없이 연료 분사기로 압축 착화하는 순서까지 맞게 돌아간다고 적었습니다.
게임 두 개를 섞은 사례도 있습니다. 크리스(@ChrisGPT)는 최고 강도(max)로 마인크래프트 안에 레드 데드 리뎀션 풍 서부 마을을 짓게 했습니다. 술집과 기차역, NPC에 협곡과 구름, 노을까지 들어갔고, 그는 흔해진 마인크래프트 복제보다 한 단계 어려운 과제를 주고 싶었다고 적었습니다.
@ChrisGPTX 게시물 · 원문 보기
이번 묶음에서 사용자들이 가장 자주 적은 것은 시간과 돈이었습니다. Bhavy(@Bhavani_00007)는 문샷AI의 오픈 모델 Kimi K3와 Fable 5.1에 같은 프롬프트를 각각 가장 높은 추론 강도로 넣었습니다. Fable 5.1은 18분에 12.6달러, Kimi K3는 10분에 약 6.95달러가 들어, 시간과 비용 모두 1.8배 차이가 났습니다.
@Bhavani_00007X 게시물 · 원문 보기
그는 앞서 프롬프트 3개로 한 비교에서도 3D 화면 하나에 Fable 5.1은 약 12달러, Kimi K3는 5달러 미만이 들었다며, 두 모델 모두 결과는 아름다웠지만 Fable 5.1은 여전히 어둡고 따뜻한 색만 고르는 버릇이 있다고 적었습니다. 몇 시간 뒤에는 Fable 5.1이 토큰을 너무 많이 먹는다는 답글을 남기면서, 다음에는 두 모델에 같은 금액 상한을 걸고 결과를 비교하겠다고 했습니다.
7월 Fable 5 때 프롬프트 4번에 173달러짜리 게임을 올렸던 라일리 브라운(@rileybrown)은 이번에 1인칭 슈팅 게임을 올리며 금액부터 적었습니다. 프롬프트 3번에 218달러로, 7월보다 프롬프트는 하나 적고 금액은 45달러 많습니다. 7월의 결과물과 금액은 Fable 5가 다시 열린 일주일의 기록에 모아 두었습니다.
@rileybrownX 게시물 · 원문 보기
반대 목소리도 같은 날 나왔습니다. 크리스는 마인크래프트 마을을 올리기 몇 시간 전, 지금 Fable 5.1 영상을 올리는 사람들은 아직 올릴 만한 것을 만들지 못했다고 썼습니다.
좋은 프롬프트는 서브에이전트를 여럿 붙여도 만드는 데 몇 시간씩 걸립니다. 이 정도 Three.js 품질을 한 시간 안에 뽑을 수 없는 데는 이유가 있습니다.— 크리스(@ChrisGPT)
이 글에 한 사용자가 Opus 5로는 그런 작업을 대략 4~6시간이면 끝낸다고 답하자, 크리스는 이 프롬프트가 Opus 5에서 딱 그만큼 걸렸다고 받았습니다. 그가 최고 강도로 만든 마인크래프트 마을은 그로부터 약 10시간 뒤에 올라왔습니다.
앤트로픽이 발표문에 실은 초기 고객의 평가도 짧은 시연 쪽이 아니었습니다. 투자회사 밀레니엄에서는 약 100만 번에 한 번 나는 충돌의 원인을 4~5년 동안 아무도 설명하지 못했는데, Fable 5를 포함해 시험한 모든 모델이 놓친 원인을 Fable 5.1이 처음 찾았다고 밝혔습니다. 외부 업체 라이브러리를 역어셈블해 코어 덤프와 맞춰 본 끝에 그 라이브러리의 버그를 짚었습니다. 몽고DB의 엔지니어는 Fable 5.1이 약 3일 만에 복잡한 시제품을 만들었고, 검증 루프를 붙인 채 몇 시간씩 사람 없이 돌아 아침마다 다음 단계가 끝나 있었다고 적었습니다.
앤트로픽의 25%와 사용자들의 금액 사이를 채우는 숫자는 출시 두 시간쯤 뒤에 나왔습니다. 모델 평가 기관 Artificial Analysis는 Fable 5.1이 자기들 지능 지수에서 66점으로 지금까지 잰 모델 가운데 가장 높다고 밝히면서, 과제당 비용은 Fable 5보다 20% 늘었다고 적었습니다.
최고 강도(max)에서 Fable 5.1은 지수 과제 하나에 3.76달러를 썼습니다. 같은 강도의 Fable 5는 3.14달러, Opus 5는 2.34달러였습니다. 캐시 읽기 인하로 과제마다 약 1.4달러를 아꼈지만 출력 토큰을 Fable 5의 약 1.7배 쓰면서 그 이상이 다시 나갔고, 인하가 없었다면 과제당 약 5.16달러였을 것이라는 계산입니다.
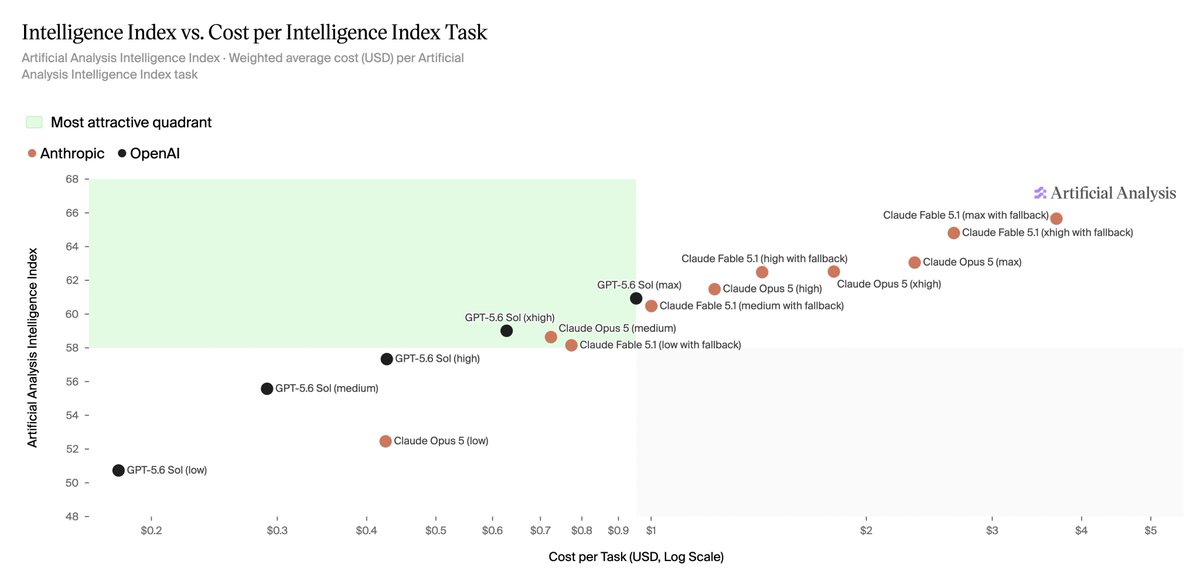
강도를 한 단계 내리면 계산이 달라집니다. xhigh에서는 65점에 과제당 2.72달러로 max보다 1.04달러 쌌고, 다섯 강도를 통틀어 출력 토큰은 1,310만 개에서 1억 4,370만 개까지 11배, 점수는 58점에서 66점까지 벌어졌습니다. 앤트로픽의 25%는 기본 강도의 실제 사용량에서, Artificial Analysis의 20% 증가는 최고 강도의 평가 과제에서 나온 값이라 두 숫자는 함께 성립합니다. 강도를 한 칸 올릴 때 토큰이 얼마나 늘어나는지는 Claude Code의 노력 설정을 잰 글에서 다뤘습니다.
쇼케이스 가운데 강도를 밝힌 사례는 최고 강도였습니다. Bhavy의 12.6달러는 가장 높은 추론 강도에서 나왔고, 크리스의 마인크래프트 마을도 max로 돌렸습니다. 두 사례의 조건은 앤트로픽이 말한 기본 강도보다 Artificial Analysis의 max 측정에 가깝습니다.
같은 평가에서 지식 업무 과제만 떼어 보면 Opus 5와의 차이는 거의 없었습니다. Fable 5.1은 GDPval-AA v2에서 1,853점으로 Opus 5(1,824점)를 앞섰지만 신뢰구간이 겹쳤고, 보고서와 발표 자료를 만드는 AA-Briefcase에서는 1,694점과 1,685점으로 사실상 같았습니다. 과제당 비용은 Fable 5.1이 Opus 5의 1.6배였습니다.
Artificial Analysis는 정확도와 환각도 따로 쟀습니다. Fable 5.1은 사실 지식 문항의 93.4%에 답을 시도해 정확도 67.2%로 지금까지 가장 높았지만, 틀린 문항 가운데 답을 지어낸 비율도 72.6%로 Fable 5의 63.6%보다 높았습니다.
Fable 5를 쓰던 사람들이 가장 자주 부딪힌 것은 비용보다 분류기였습니다. 7월 재배포 때 앤트로픽은 사이버 분류기를 일부러 넓게 잡았고, 평범한 코딩과 디버깅 요청도 Opus 4.8로 넘어가곤 했습니다.
Fable 5.1에서는 이 기준을 다시 조였습니다. 사이버 안전장치가 무해한 요청을 잘못 막는 경우가 이전보다 60% 줄었고, Claude Code 사용자는 세션당 개입을 평균 60%쯤 덜 겪을 것이라고 앤트로픽은 밝혔습니다. 소프트웨어 취약점을 찾는 방어 작업도 이번에 허용했지만, 침투 테스트와 공격 코드 작성, 바이너리 기반 취약점 스캔은 여전히 Opus 모델로 넘깁니다. 기초 생물학과 의학 질문에서 안전장치가 발동하는 비율은 Fable 5 출시 때보다 85% 낮아졌습니다.
사례 이름을 누르면 만든 사람의 원래 게시물로 이동합니다.
| 사례 | 조건·결과 | 올린 사람 |
|---|---|---|
| 음성으로 설명한 크로시 로드 게임 | 긴 문서 없이 받아쓰기 한 번 | @MozeTech |
| 후지산을 오르는 판타지 3D 세계 | 지형·안개·일출을 한 번에 코드로 | @techartist_ |
| 병 속의 배, GLM 5.3과 같은 프롬프트 | 유리병·배·섬·바다를 한 번에 | @holytrinity |
| 1차 세계대전 전장 디오라마 | 프롬프트 공개 | @holytrinity |
| 터널 굴착 과정 시각화 | 터널을 어떻게 뚫는지 보여 달라는 요청 | @holytrinity |
| 4행정 디젤 엔진 분해 | 흡입·압축·분사·배기 순서 재현 | @NFT_Chen |
| Three.js 고품질 3D 화면 | 서브에이전트 여럿, 몇 시간 | @ChrisGPT |
| Kimi K3와 프롬프트 3개 비교 | 화면 하나에 약 12달러 대 5달러 미만 | @Bhavani_00007 |
토큰 가격표가 그대로라 짧은 질문 위주로 쓰는 사용자의 비용은 크게 움직이지 않습니다. 인하가 큰 쪽은 긴 코드베이스나 문서를 문맥에 올려 두고 에이전트를 오래 돌리는 작업이고, 여기서도 강도를 max로 올리면 늘어난 출력 토큰이 인하분을 넘길 수 있다는 것이 Artificial Analysis의 측정입니다.
기업 고객에게는 데이터 보관 조건도 달라졌습니다. 앤트로픽은 6월 Fable 5를 내면서 Mythos급 모델의 기업 트래픽을 모두 30일 동안 보관하겠다고 했는데, Fable 5.1부터는 데이터를 고객이 관리하는 클라우드에 두는 Enterprise Frontier Safeguards(EFS)를 올가을부터 단계적으로 열고, 그전까지는 요건을 갖춘 고객에게 데이터를 남기지 않는 방식으로 제공하기로 했습니다. 개인정보와 영업 기밀 때문에 외부 보관을 꺼리는 국내 기업에는 가격보다 이 조건이 먼저 걸립니다.
API로 서비스를 만드는 개발자가 알아 둘 변화도 있습니다. 9월 1일 이후 새로 만든 API 계정은 여러 턴짜리 대화에서 Claude의 이전 사고 기록을 남긴 채 앞선 문맥을 손으로 고칠 수 없습니다. 앤트로픽은 모델의 사고를 빼내 다른 모델을 학습시키는 증류에 쓰이던 방법을 막으려는 조치라고 설명했고, 기존 계정에는 아직 적용하지 않지만 다음 모델부터는 모든 사용자에게 적용하겠다고 밝혔습니다.
Mythos 5.1은 아직 미국 기관에만 열려 있습니다. 앤트로픽은 국내외 파트너로 넓히기 위해 미국 정부와 협의하고 있다고 밝혔고, 생명과학 연구자용 접근 프로그램의 등록도 곧 열겠다고 했습니다.
읽어 주셔서 고맙습니다.
초이 드림