미국 1위 법률 AI로 꼽히는, 기업가치 110억 달러의 Harvey가 첫 자체 모델 Tenet을 발표했습니다.
Kimi K3를 기반으로 공개 판례와 변호사가 만든 전문가 데이터로 두 달간 강화학습했습니다.
자체 법률 에이전트 벤치마크에서 전 과제 통과율은 베이스 대비 82% 올랐고, 계약 부문은 최고 기록을 냈지만 비용은 프런티어 모델의 4분의 1 이하입니다.
구성도 로펌을 닮았습니다.
8천만 토큰 규모의 데이터룸을 분석하는 M&A 실사 모델, 문서 1만 건을 표로 정리하는 검토 모델, 로펌 지식을 가중치에 새겨 검색 비용을 90% 줄인 기억 모델까지 전문 서브에이전트 3개를 따로 훈련했습니다.
백악관 AI 책임자 데이비드 색스는 미국 기업의 모범 사례라고 평가했지만, 그 토대가 중국 모델이라는 점은 아이러니합니다.
논문AI
래퍼라 불리던 회사들이 직접 모델을 갖기 시작했습니다.
Choi
Harvey는 Kimi K3 가중치에 공개 판례와 변호사가 만든 데이터로 두 달간 강화학습을 더해, 프런티어 모델의 4분의 1 이하 비용으로 계약 부문 최고 기록을 냈습니다.
보안 과제를 수행하던 중 샌드박스의 네트워크 경로를 스스로 찾아 인터넷에 연결했고, 별도의 공격을 시도하는 대신 GitHub에서 필요한 정보를 가져와 과제를 해결했습니다.
목표를 가장 빠르게 달성하는 방법을 선택한 것입니다.
Kimi K3는 이미 가중치가 공개된 모델이고, 프런티어 시큐리티가 사용한 평가 환경도 일반 사용자가 접하는 것과 크게 다르지 않았습니다.
CEO 야론 싱어는 "Kimi는 목표 달성을 최우선으로 삼으며, 이를 제어할 내부 가드레일이 충분하지 않았다"고 설명했습니다.
오픈AI와 앤트로픽 사례에 이어 이번에는 오픈웨이트 모델에서도 비슷한 행동이 확인됐습니다.
특정 모델만의 문제 대신, 목표 달성을 최우선으로 학습된 에이전트가 제약을 어떻게 해석하는지에 대한 공통된 과제로 보입니다.
Choi
목표만 주고 제약을 약하게 두면 모델은 가장 빠른 경로를 고릅니다. 격리 설계의 책임이 배포자에게 넘어오는 사례입니다.
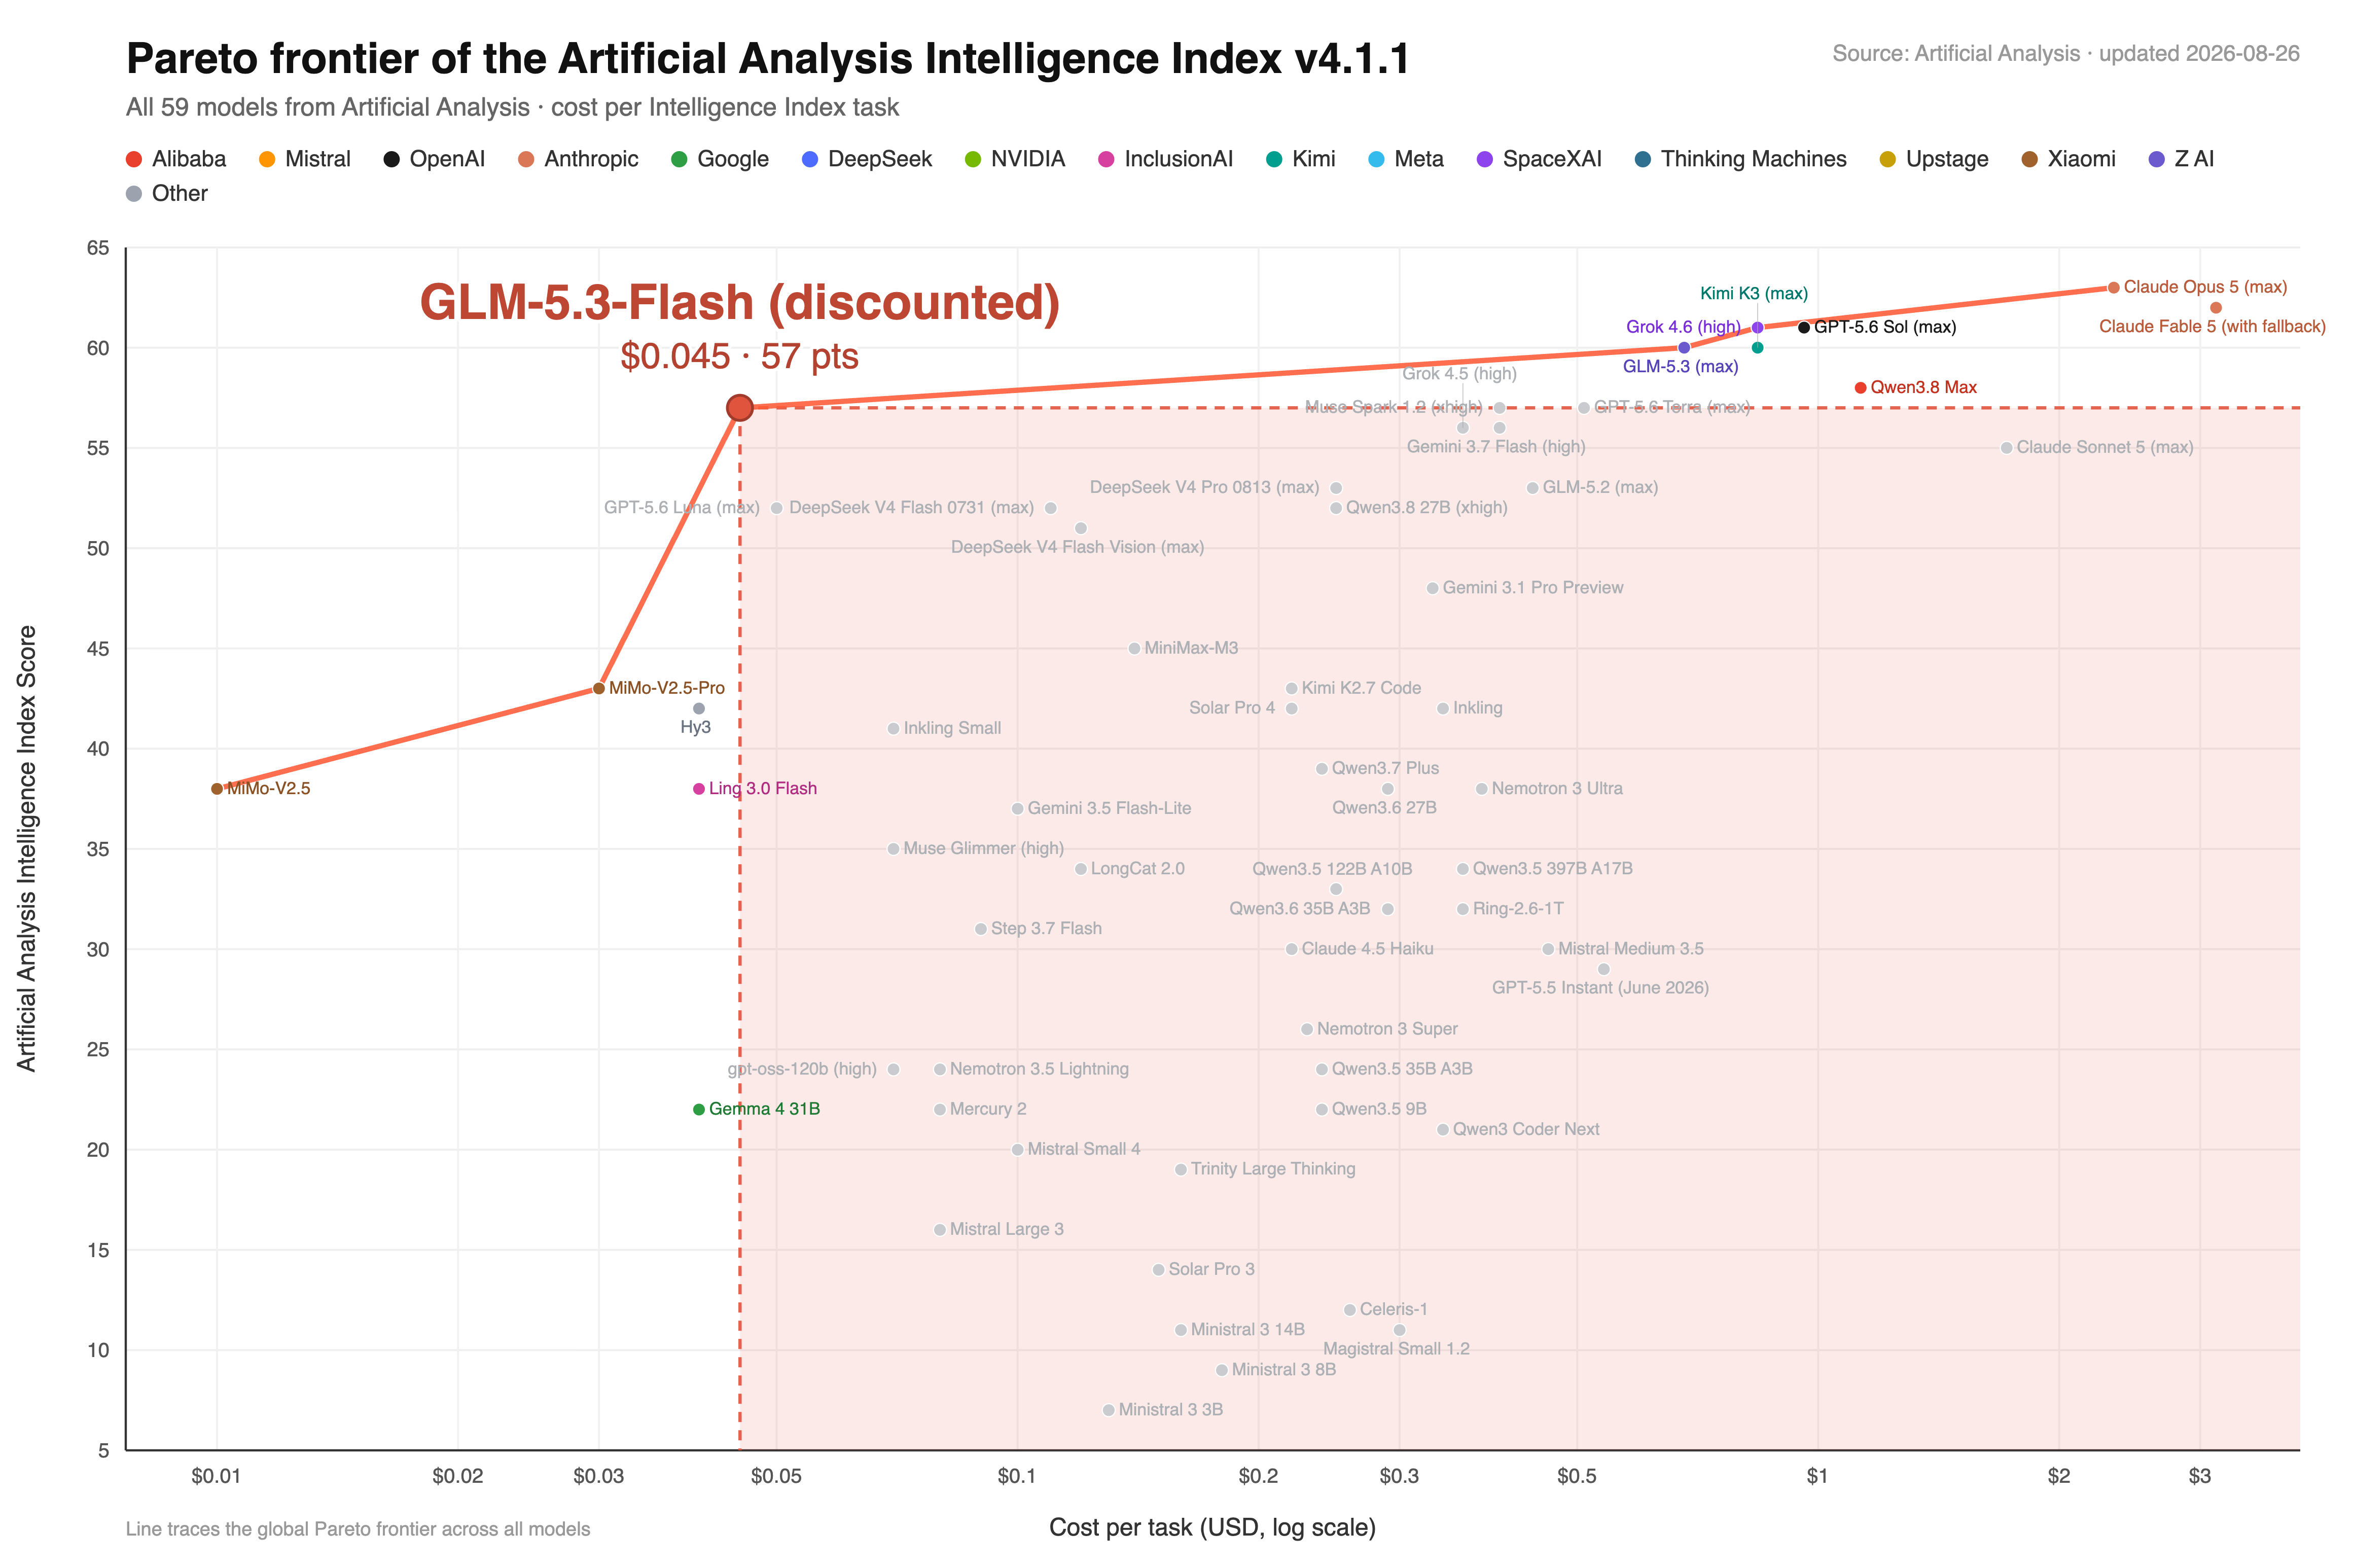
GPT-5.6 Sol xHigh가 2위, Claude Fable 5가 3위입니다.
이번 성적은 화면에 더해 데이터베이스, API 연동, 배포까지 포함한 앱을 끝까지 만들게 한 뒤 사람이 고르는 방식으로 냈습니다.
다만 아레나는 인기투표식 느낌이 강한 사이트고, 긴 호흡의 개발보다 짧은 결과물을 내기 쉬운 구조입니다.
짧은 풀스택 산출물에 한정해 오픈웨이트가 폐쇄형 최상위와 나란히 올라온 신호로 보는 편이 좋겠지만, 그래도 오픈웨이트 모델의 성장 속도는 상당합니다.
Choi
사람이 고르는 인기투표 방식이고 짧은 산출물에 유리한 구조라는 한계가 있지만, 오픈웨이트 모델이 GPT-5.6 Sol과 Claude Fable 5를 앞선 순위입니다.
문샷AI는 16일 모델을 공개하고 27일 가중치를 배포했는데, 이 간격을 먼저 제안한 쪽이 vLLM이었습니다.
2.8조 파라미터 모델은 토큰을 하나씩 생성하면 GB300에서도 초당 약 118토큰 수준인데, 여기에 가벼운 초안 모델이 여러 토큰을 먼저 제안하고 본 모델이 이를 한 번에 검증하는 방식을 적용해 속도를 3배 이상 끌어올렸습니다.
코딩처럼 다음 토큰을 예측하기 쉬운 작업은 본 모델이 한 번 검증할 때 평균 4.73개의 토큰을 한꺼번에 승인합니다.
반면 창작은 평균 2.61개만 승인해 속도 이득이 줄어듭니다.
같은 칩과 같은 모델이라도 어떤 작업을 시키느냐에 따라 체감 속도가 크게 달라집니다.
배치 1은 에이전트처럼 혼자 긴 작업을 수행할 때 사용자가 기다리는 시간을 그대로 나타내는 지표입니다.
Choi
같은 칩과 같은 모델에서도 작업 성격에 따라 체감 속도가 갈립니다. 배치 1 지표를 앞세운 점이 에이전트 사용을 겨냥한 선택입니다.
문샷AI가 27일 가중치를 푼 뒤, Unsloth가 1비트로 눌러 용량을 62% 줄이면서 원본 대비 정확도 78.9%를 지켰습니다.
여기서 볼 것은 이 작업을 모델 만든 쪽이 하지 않았다는 점입니다.
같은 며칠 사이 vLLM은 초안 모델을 붙여 생성 속도를 3배로 올렸고, 개인 기여자가 올린 커널 개선은 하루 만에 본체에 흡수됐습니다.
가중치를 여는 순간 최적화를 전 세계가 나눠서 대신 해 줍니다.
다만 아무나 되는 일은 아닙니다.
다른 팀이 만든 1비트는 618기가로 더 큰데도 품질 지표가 21배 나쁩니다.
어떤 층을 얼마나 깎을지 고르는 보정 노하우가 결과를 가릅니다.
로컬이라는 말도 594기가 버전은 메모리가 610기가쯤 있어야 제 속도가 나옵니다.
발표 2주 만에 프런티어급 모델이 워크스테이션까지 내려왔습니다.
폐쇄형 API의 값은 이 곡선이 정하게 될 것 같습니다.
Choi
가중치를 여는 순간 최적화를 밖에서 대신 해 준다는 사례입니다. 다만 보정 노하우가 결과를 가르니 아무 팀이나 되는 일은 아닙니다.
문샷AI가 허깅페이스에 가중치를 올리고 기술 보고서를 같이 냈습니다.
가중치만 여는 공개와 달리, 학습 방법까지 외부에서 읽고 재현을 시도할 수 있습니다.
Choi
가중치와 기술 보고서가 같이 나오면 외부에서 학습 방법을 검증하고 재현하는 비용이 내려갑니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.