
코딩 에이전트
coding agent · 코딩 어시스턴트
저장소를 읽고 명령을 실행하며 코드를 끝까지 고치는 에이전트입니다. 최근 모델 도약이 지식 문답 대신 이쪽에 몰려서, 딥시크 V4-Pro는 코딩 에이전트 평가 DeepSWE에서 12.8점이 62.7점이 됐습니다. 같은 모델도 어떤 하네스에 올리느냐에 따라 점수가 크게 달라집니다.
‘코딩 에이전트’ 이 나오는 글12
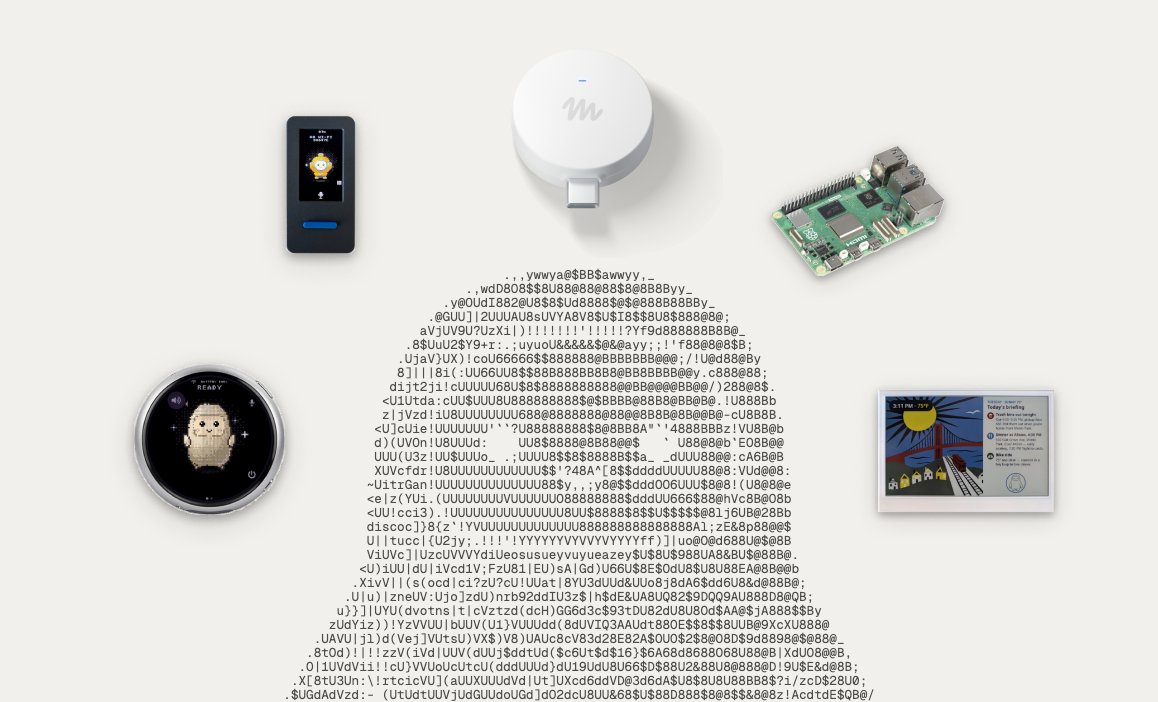
공짜 동글 5,000대에 코드까지, 메타 Muse가 집 안 TV·프린터를 다룹니다
메타가 10월 2일(미국 시각) Muse를 직접 만든 하드웨어에 잇는 Muse Gadgets를 공개했습니다. 집 안 와이파이에 꽂는 Home Link 5,000대를 미국 구독자에게 무료로 나눠 주고, 공개 당시 기기 스킬은 43개였습니다.
Opus 5.5에 2점 차 Sonnet 5.5, 값은 GPT-6 Sol과 같습니다
앤트로픽이 9월 28일 Claude Sonnet 5.5를 GPT-6 Sol과 같은 입력 2달러·출력 10달러에 공개했습니다. 독립 평가 지수는 56점으로 Opus 5.5에 2점 뒤졌고, 최고 강도에서는 과제당 비용이 7.60달러로 Opus 5.5보다 27% 더 들었습니다.
초안은 AI가, 마무리는 사람이… open-slide 2.0 '편집되는 PPTX'
오픈소스 발표 도구 open-slide가 9월 26일 2.0을 냈습니다. 에이전트가 React로 짠 슬라이드를 화면에서 끌어 고치고, 글자·도형·그림이 살아 있는 PPTX로 내보냅니다. 10일 앞서 Slidev도 같은 기능을 냈습니다.

Grok 4.7, 코딩 지수 9점 오를 때 종합은 2점, 과제당 비용은 2배
Grok Build에서 잰 Terminal-Bench 4.0 통과율이 17.7%에서 33.3%로 뛰었습니다. 같은 단가에 AA 지능 지수 과제 하나를 푸는 비용은 1.86달러에서 3.74달러로 늘어, 단가가 5배인 GPT-6 Astra(3.26달러)보다 많아졌습니다.
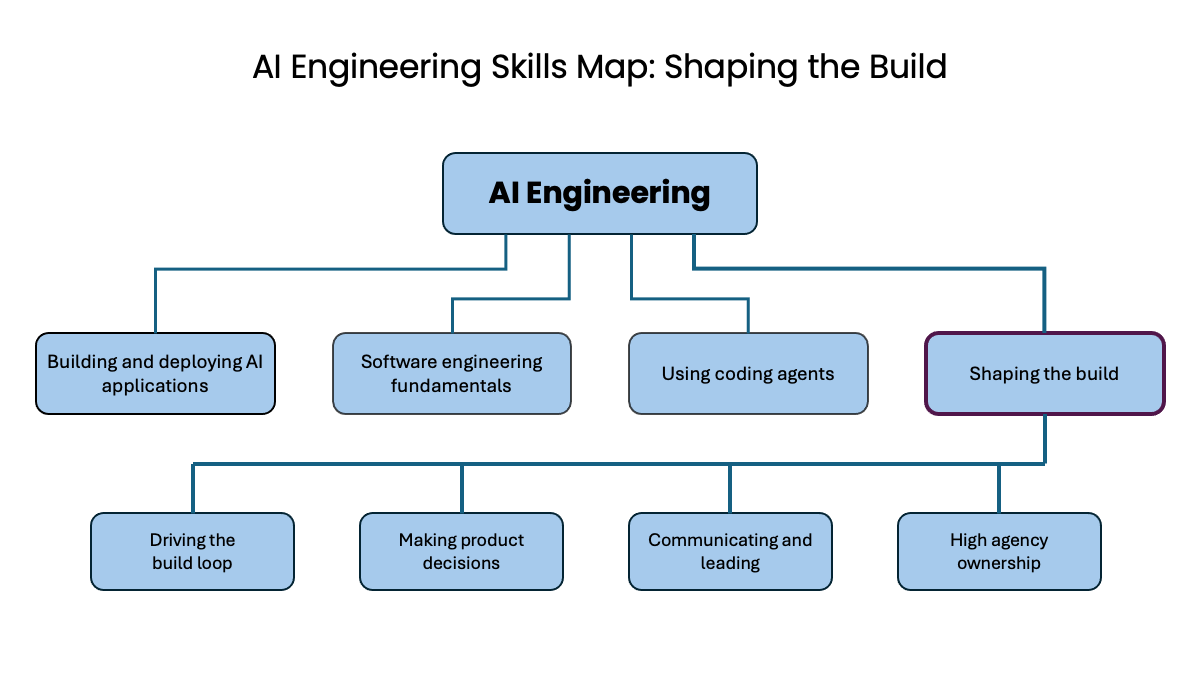
에이전트가 코드를 다 쓰면 개발자는 무엇을 하나, 앤드루 응의 답
앤드루 응이 역량 지도 3~5편으로 네 역량의 세부 지도를 모두 채웠습니다. 에이전트가 코드를 쓰는 동안 사람에게 남는 일로 트레이드오프 판단, 에이전트 지휘와 검토, 무엇을 만들지 정하는 일을 꼽았습니다.
지난 시도를 복기하는 AI, 구글이 모델은 그대로 두고 호출을 42% 줄였습니다
9월 14일 공개된 Dream-RSI는 모델 가중치 대신 어느 후보를 이어 갈지 정하는 탐색 정책 코드만 고칩니다. Gemini 3.1 Pro로 Lasso 알고리즘을 찾을 때 호출은 42% 줄었지만, 데이터셋 6개 가운데 5개에서는 고정 탐색보다 느렸습니다.
함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- Terminal-Bench터미널에서 여러 단계를 이어 수행하는 긴 작업을 재는 평가입니다. 단발 코드 생성과 달리 도구 사용과 오류 복구까지 포함해서, 에이전트 성능을 비교할 때 자주 인용됩니다.
- 오픈소스 라이선스공개된 가중치를 누가 어떤 조건으로 쓸 수 있는지 정하는 약관입니다. MIT와 아파치 2.0은 조건 없이 고치고 팔 수 있게 열어 두는 반면, 사용 지역이나 상업 이용에 제한을 붙인 자체 라이선스도 흔합니다. 텐센트 커뮤니티 라이선스는 EU와 영국, 한국을 사용 가능 지역에서 빼 두었다가 아파치 2.0 전환으로 그 조항을 없앴습니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.