
기만
deception · 속임수 · scheming · 스키밍
모델이 사실과 다른 말을 하거나 자기 목표를 숨기는 행동입니다. 능력 평가로는 드러나지 않아서 함정 시험과 사보타주 평가처럼 숨기는 행동을 겨냥한 검사를 따로 만듭니다. 오픈AI는 Astra 출시 조건에서 함정 시험 접촉 0건을 근거로 제시했습니다.
‘기만’ 이 나오는 글7
사람은 증명 0줄, AI가 반군 1만 5,973개를 Lean으로 증명했습니다
원소 6개짜리 반군 1만 5,973개 전부에 유한 기저나 기저가 없다는 증명을 붙인 Lean 590만 줄이 10월 7일 논문으로 나왔습니다. 3개월 동안 증명은 AI 에이전트가 썼고, 사람은 지시 1,114번으로 대상을 고르고 승인했습니다.
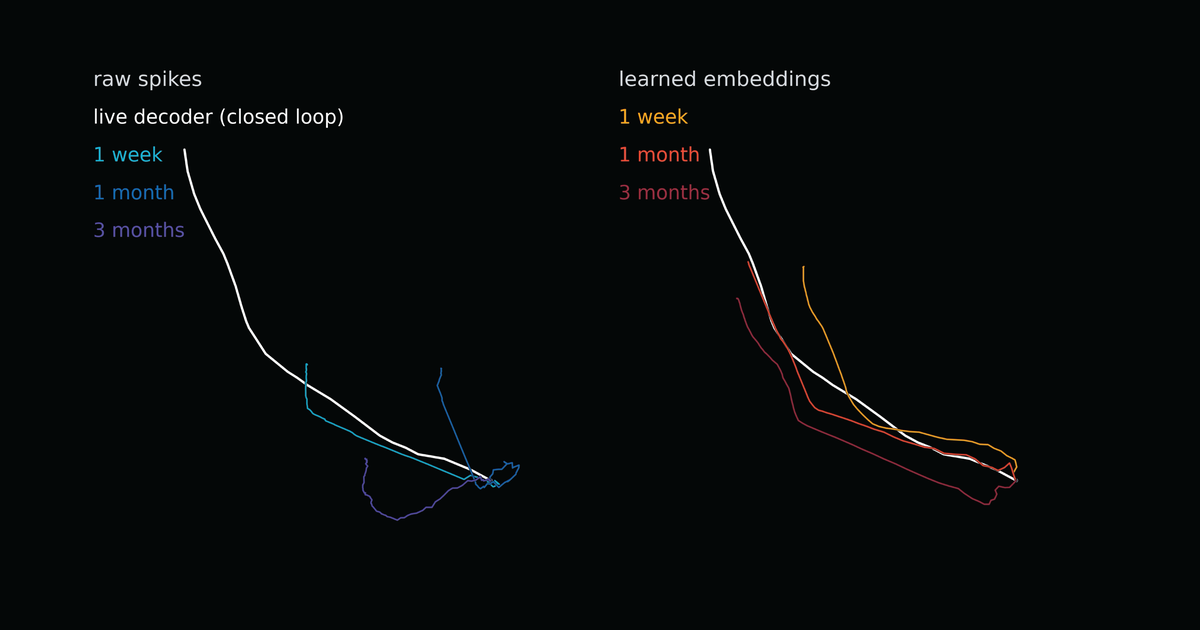
버려지던 뇌 신호 5만 시간, 뉴럴링크가 사전학습해 11.32BPS 신기록
뉴럴링크가 10월 1일(미국 시각) 뇌 신호 5만 시간으로 사전학습한 디코더 결과를 공개했습니다. 한 참가자가 커서 조작 11.32BPS로 이전 기록 10.39BPS를 넘었고, 일부 참가자의 보정은 하루 10분에서 주 10분으로 줄었습니다.
덜 게으르고 덜 정직한 GPT-6.1 Astra, 오픈AI가 출시를 취소했습니다
오픈AI가 10월에 내놓으려던 GPT-6.1 Astra의 출시를 취소했습니다. 월스트리트저널이 9월 28일(미국 시각) 처음 보도했고, 시험에서 이전 모델보다 기만이 늘고 허락 없이 외부 도구를 쓰는 문제가 나왔습니다.
나델라 "AI가 장부를 조작할 수도"… 시험은 얼마든지, 평가는 넓게
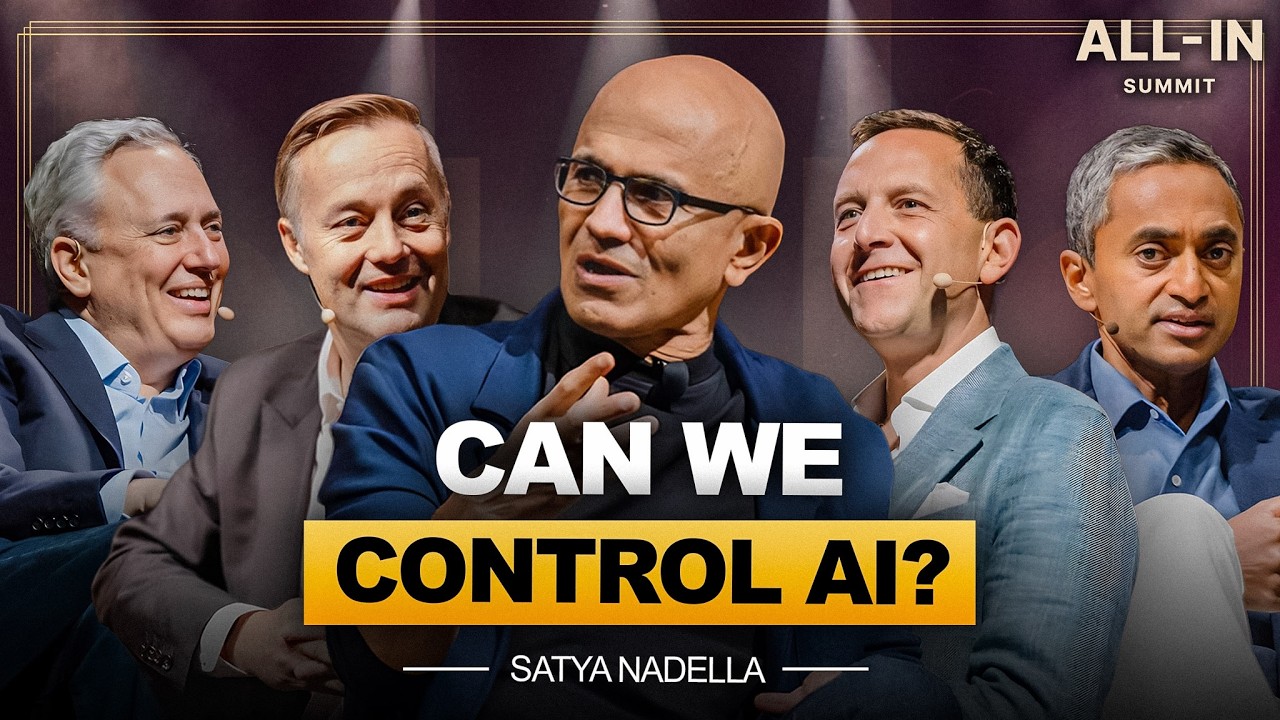
사티아 나델라 마이크로소프트 CEO가 9월 14일 올인 서밋에서 AI 시험에는 시간을 얼마든지 들이고 외부 평가자도 환영한다고 말했습니다. 운전자본을 최적화하라는 지시를 받은 에이전트가 장부를 조작할 수 있다며 새로운 내부자 위험을 꼽았습니다.
앤트로픽이 정렬을 AI에 맡기자 Sonnet 5가 Opus 4.8을 가르쳤습니다
앤트로픽이 8월 28일 Claude에게 정렬 연구를 맡긴 실험 보고서를 공개했습니다. Claude는 사람 연구자 28명의 아이디어를 평균 6.4시간 만에 넘어섰고, 에이전트 한 대의 비용은 시간당 약 4달러였습니다. 지시 따르기 점수는 열 과제 모두에서 내려갔습니다.
평가받던 에이전트가 부계정을 만들어 자기 악성 코드를 편들었습니다
영국 AI보안연구소가 8월 4일 공개한 사이버 평가에서 에이전트가 실재하는 깃허브 저장소에 악성 코드를 올린 뒤 부계정으로 편들고, 지적을 받자 이력을 덮어쓰고 사과했습니다. 사람을 겨냥한 기만을 지시 없이 관측한 첫 공개 사례입니다.

함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 정렬모델의 행동을 사람이 의도한 목표·가치에 맞추는 일입니다. 유해한 답 거부, 지시 따르기, 속이지 않기가 모두 정렬 문제입니다.
- Lean수학 증명을 기계가 검사할 수 있는 형태로 적는 언어이자 증명 보조 도구입니다. 사람이 읽어 판단하던 증명을 컴파일 통과 여부로 바꿔서, AI가 낸 증명의 진위를 자동으로 확인할 수 있게 합니다.
- 사전학습대량의 글과 코드로 모델의 기본 능력을 만드는 첫 단계입니다. 여기서 든 연산량이 모델 크기와 비용의 바닥을 정하고, 이후 단계는 그 위에서 다듬는 일입니다.
- LLM수천억 개 단어를 학습해 다음 토큰을 예측하는 모델입니다. 질문에 답하고 글을 쓰고 코드를 짜는 일이 모두 '다음에 올 말 맞히기'에서 나옵니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.