
사전학습
프리트레이닝 · pretraining · 사전 학습
대량의 글과 코드로 모델의 기본 능력을 만드는 첫 단계입니다. 여기서 든 연산량이 모델 크기와 비용의 바닥을 정하고, 이후 단계는 그 위에서 다듬는 일입니다.
‘사전학습’ 이 나오는 글7
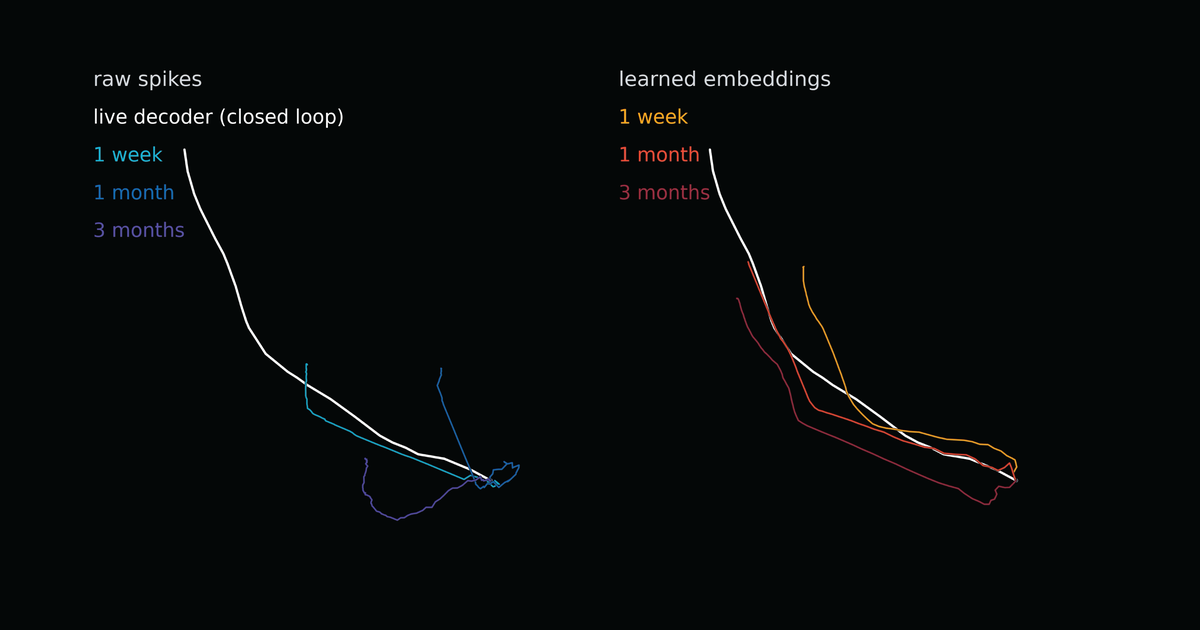
버려지던 뇌 신호 5만 시간, 뉴럴링크가 사전학습해 11.32BPS 신기록
뉴럴링크가 10월 1일(미국 시각) 뇌 신호 5만 시간으로 사전학습한 디코더 결과를 공개했습니다. 한 참가자가 커서 조작 11.32BPS로 이전 기록 10.39BPS를 넘었고, 일부 참가자의 보정은 하루 10분에서 주 10분으로 줄었습니다.
영상 만들던 런웨이가 로봇을 움직입니다, 가중치 공개할 Praxis-1
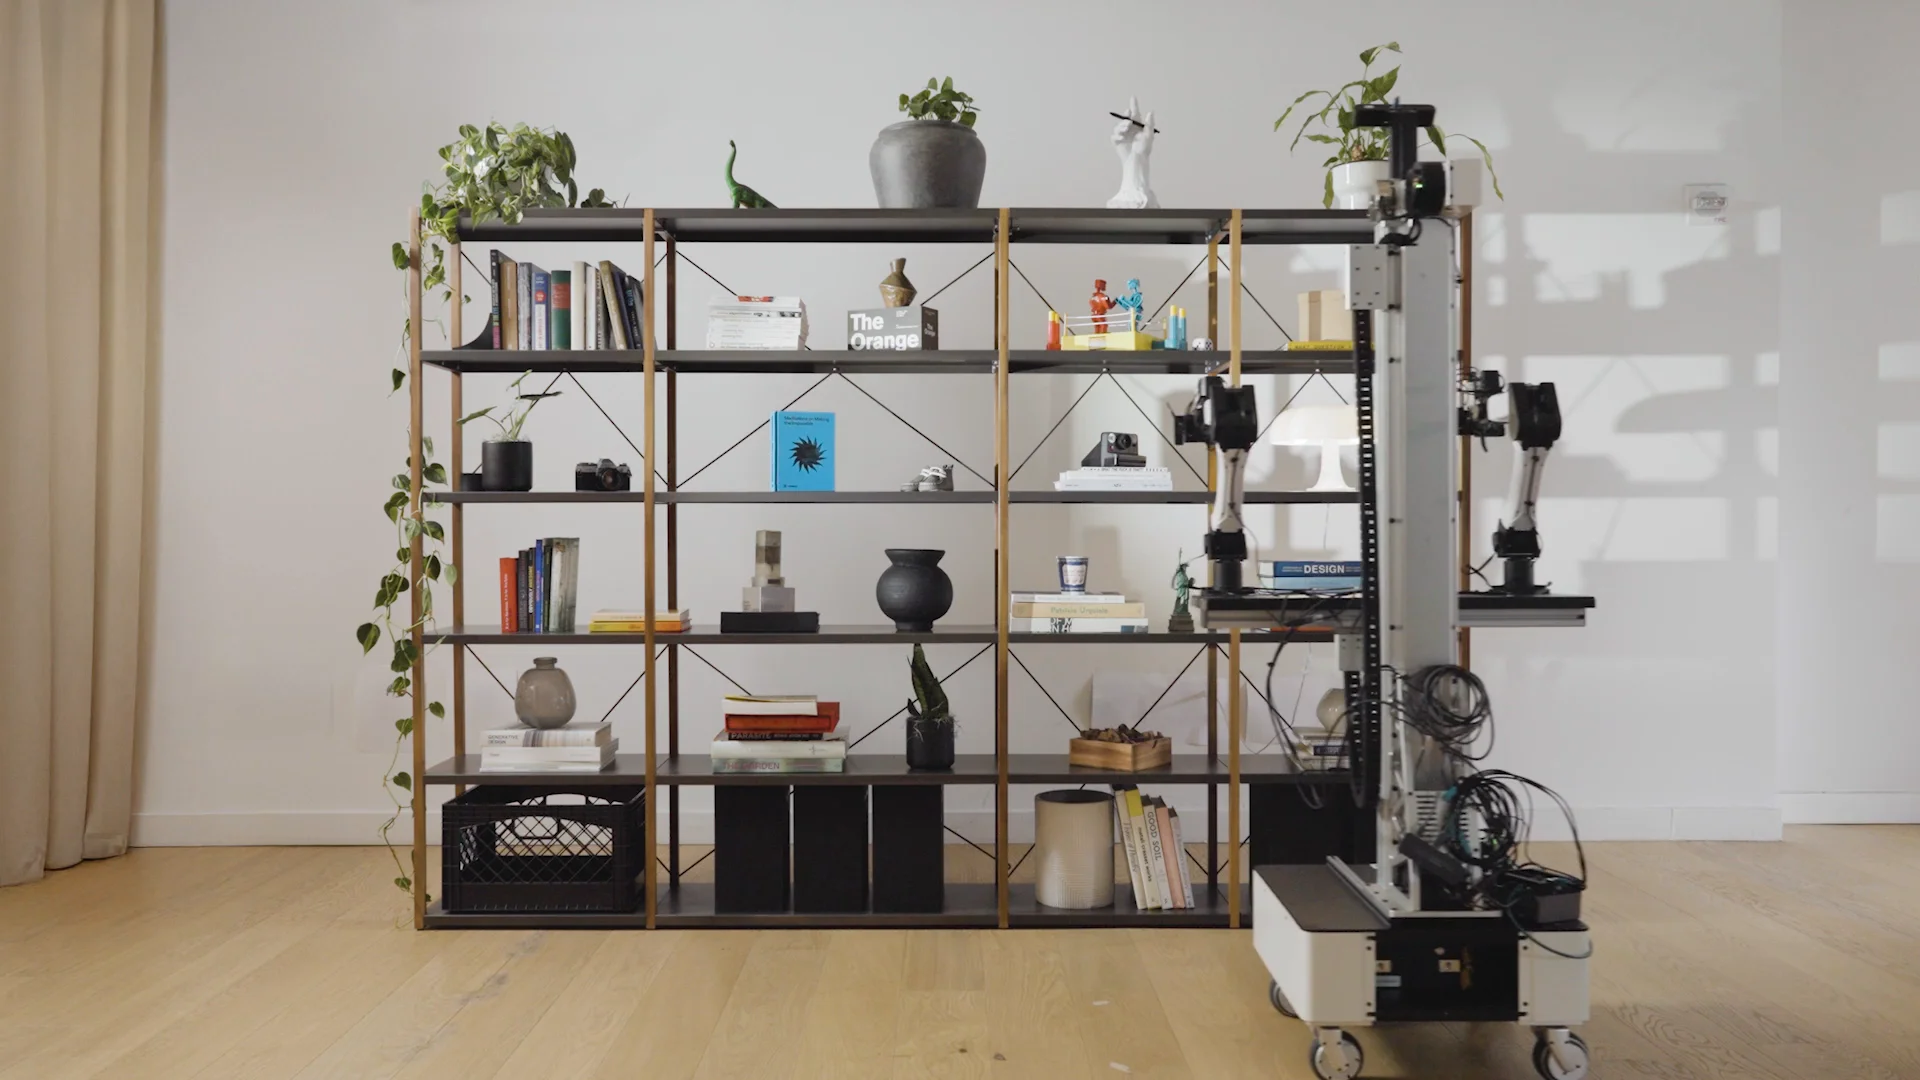
런웨이가 10월 1일 새벽(한국 시각) 로봇 제어 모델 Praxis-1을 공개했습니다. 웹 영상으로 사전학습한 정책의 오차가 로봇 영상으로 학습한 정책과 같았다(16.1cm 대 16.0cm)고 밝혔지만, 성공률과 모델 크기는 내놓지 않았습니다.
딥시크 "V4.1-Flash가 V4-Pro 앞서"… MIT 공개하고 요금 인하
딥시크가 9월 10일 552B MoE 모델 V4.1-Flash를 MIT 라이선스로 공개했습니다. 토큰당 KV 캐시는 V4-Flash의 약 4분의 1이고, 오프피크 요금은 캐시 적중 입력 0.003달러, 출력 0.6달러로 8월보다 내렸습니다.

"목숨을 건 도박" 앤트로픽 퇴사자 경고에 현직 정렬 리드가 "맞다"고 답했습니다
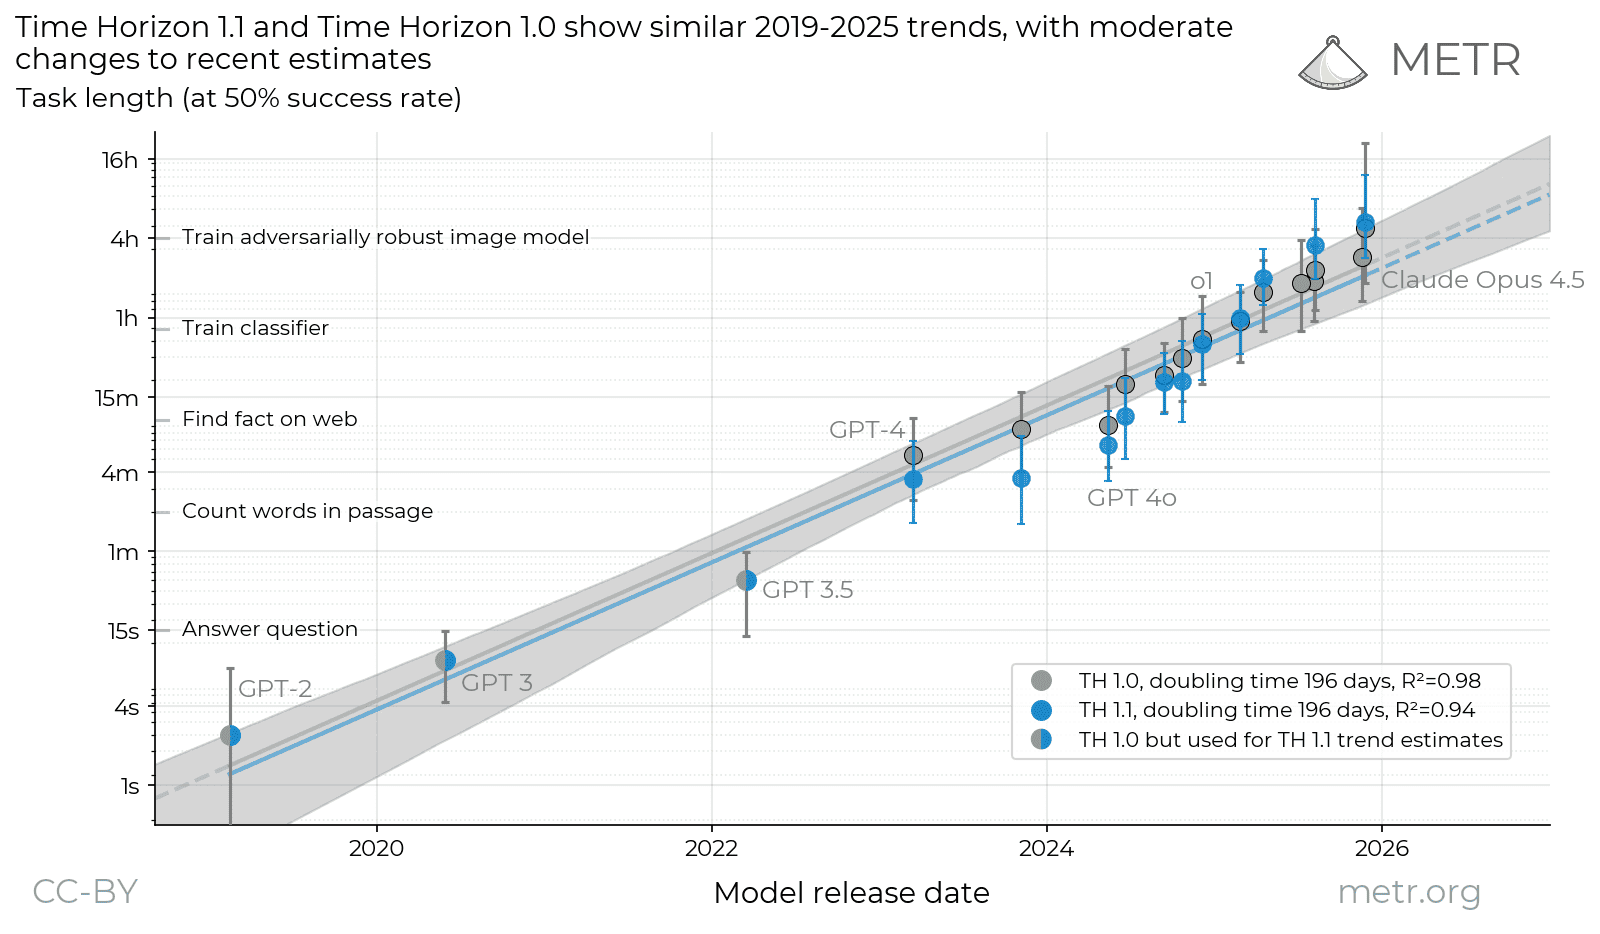
AI 과제 길이의 2배 주기 4.3개월은 METR이 새 과제로 잰 2023년 이후 추세이고, 2019년부터 전체로는 두 판 모두 약 7개월이었습니다. 오픈AI는 Astra 계열 GPU 배분이 59.2% 줄어든 주에 다른 계열을 늘려 감소분의 85%를 메웠습니다.
몸집은 그대로, GLM-5.3이 후속 학습만으로 터미널 점수를 6배로
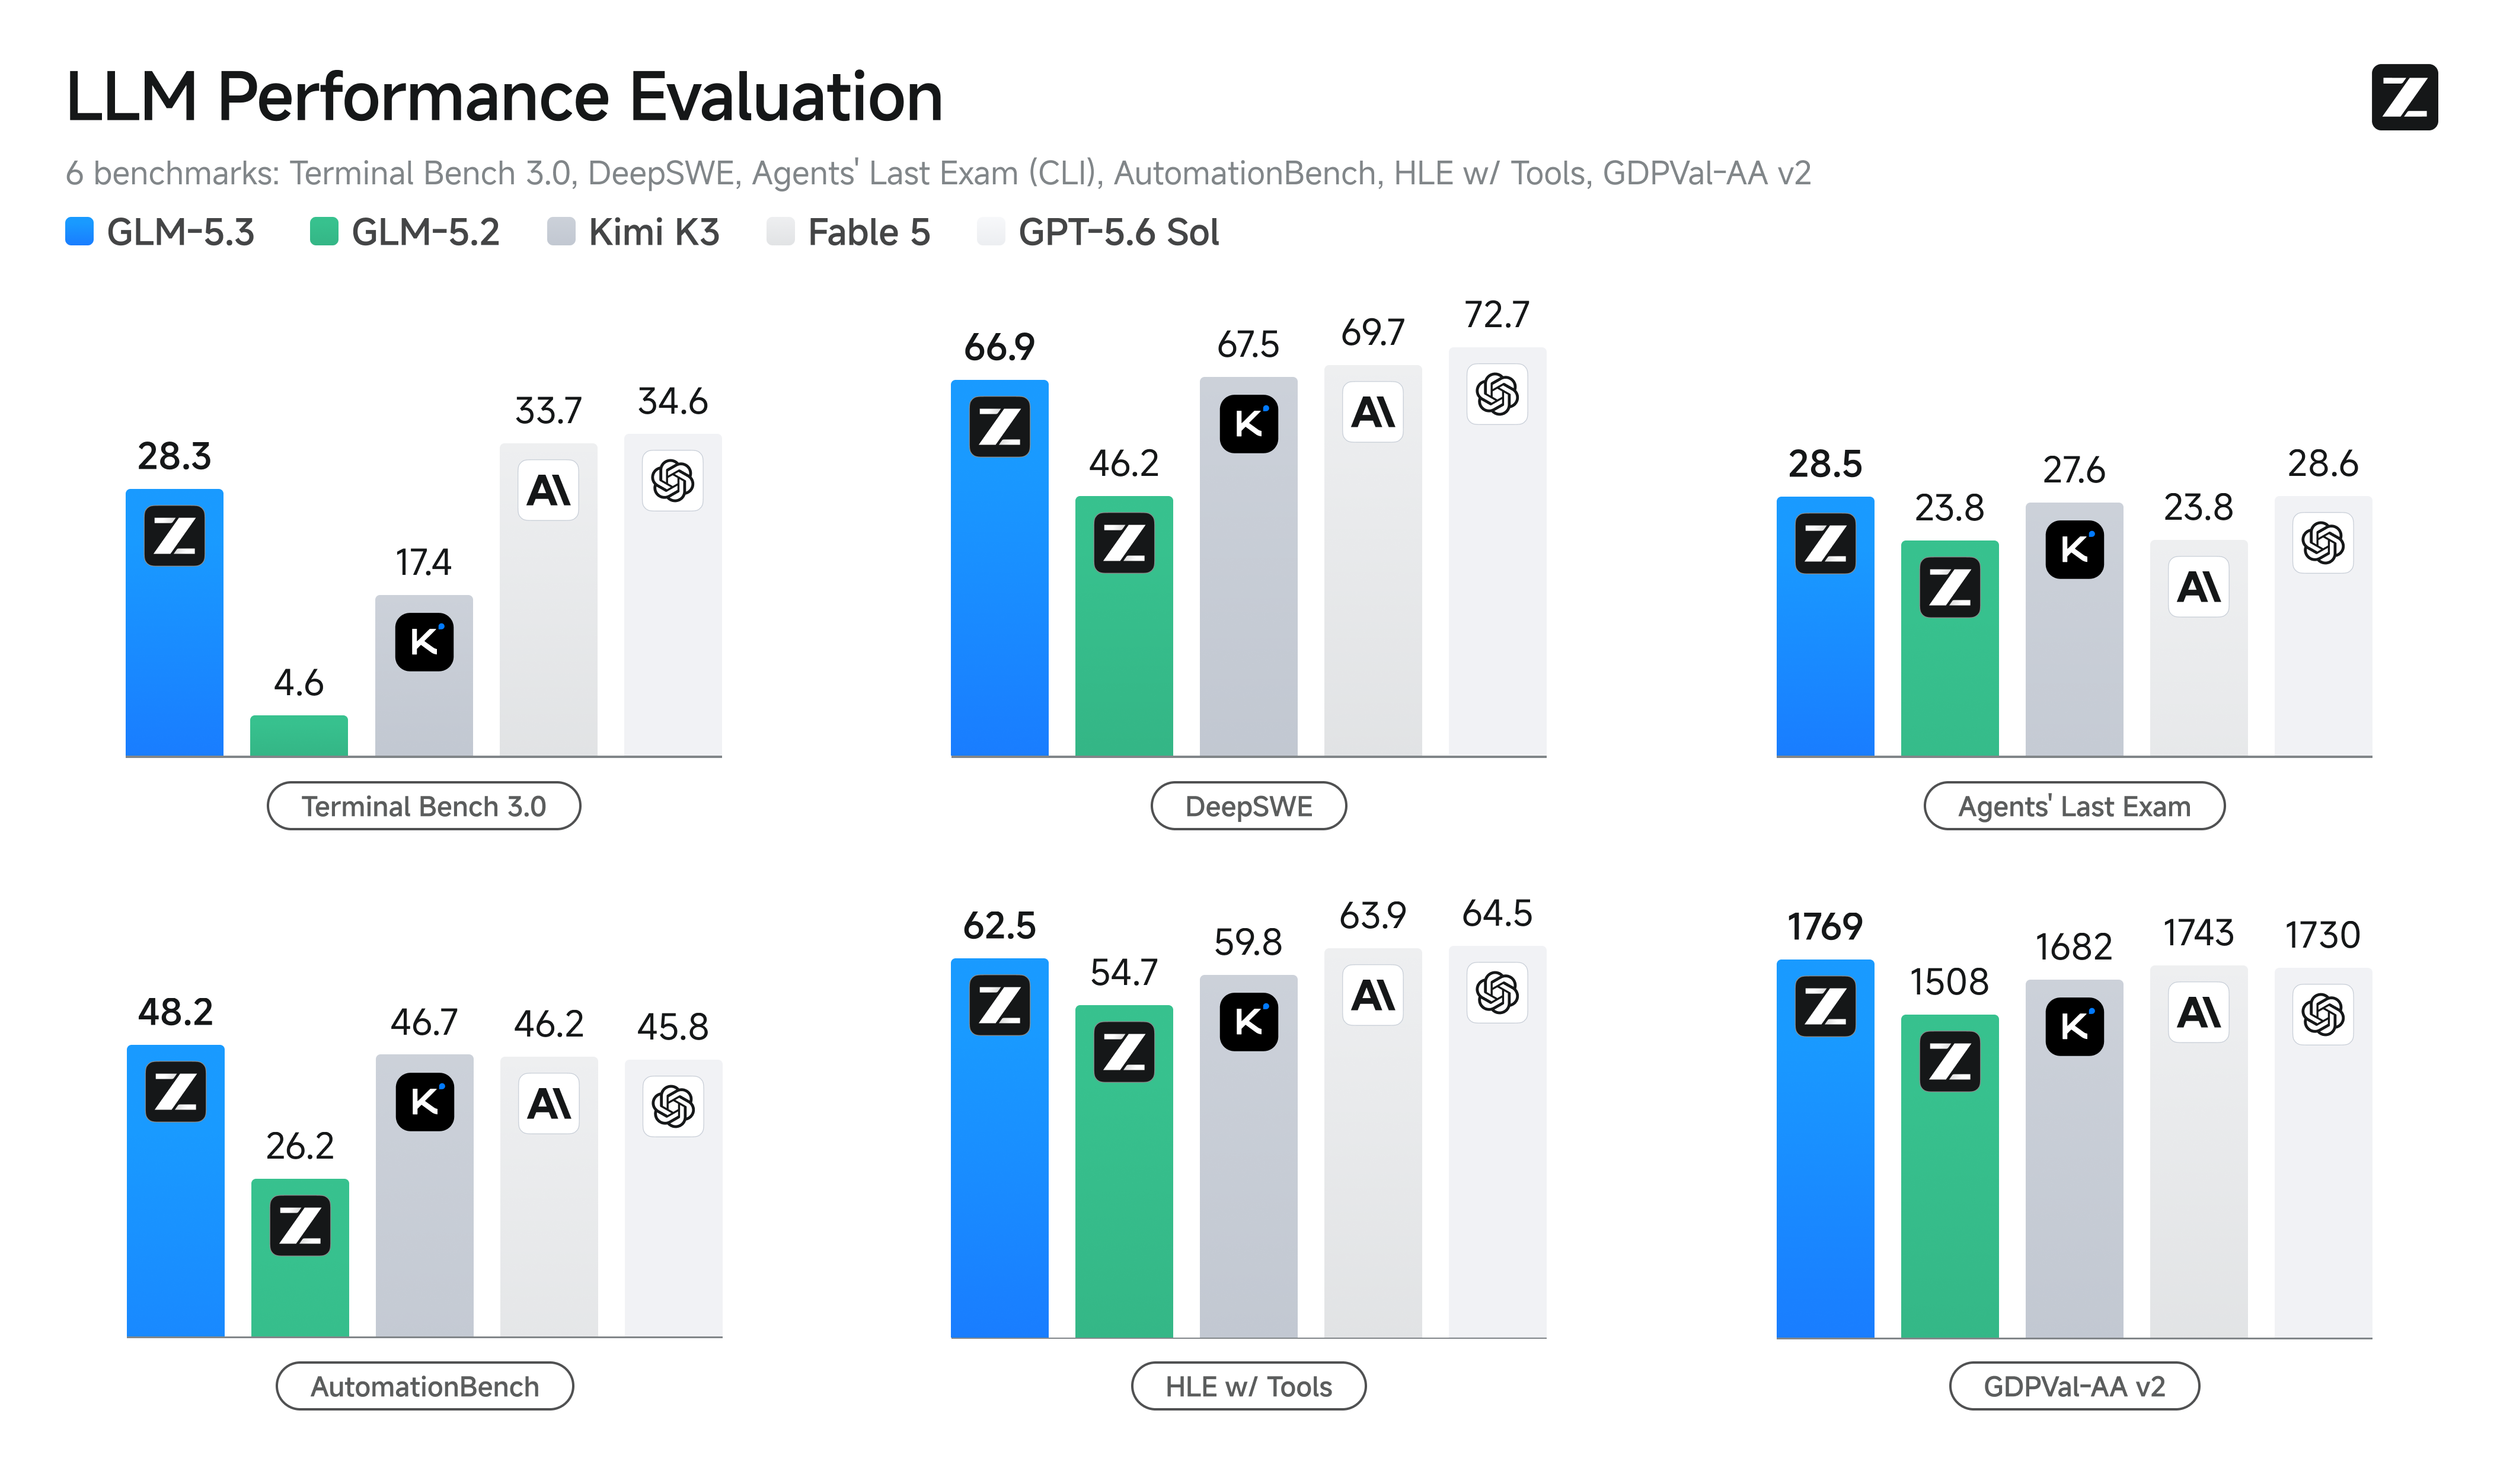
Z.ai가 8월 14일 공개한 GLM-5.3은 전작과 같은 743B 기반 모델에 후속 학습만 한 달 더한 모델입니다. 코딩 에이전트 평가 DeepSWE는 46.2에서 66.9로, 취약점 탐지 CyberGym은 77.2%에서 84.5%로 올랐고, 가중치는 2주 뒤 공개하겠다고 했습니다.
"2025년 AGI를 믿었다" 오픈AI 추론 이끈 트워렉, 트랜스포머 대체에 나서
오픈AI 추론 팀을 이끈 제리 트워렉과 제미나이 사전학습을 이끈 로한 아닐이 7월 29일 세쿼이아 팟캐스트에 나왔습니다. 트랜스포머로는 배포 뒤에도 계속 배우는 모델을 만들 수 없다며, 연구를 자동화해 대체 구조를 찾겠다고 했습니다.
함께 나오는 용어5
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 오픈 웨이트학습된 가중치 파일을 공개해 누구나 내려받아 돌릴 수 있는 모델입니다. 학습 데이터·코드까지 다 여는 '오픈 소스'와는 구분합니다.
- 오픈웨이트학습이 끝난 모델의 가중치 파일을 내려받아 직접 돌릴 수 있게 푼 것입니다. 소스 전체를 여는 오픈소스와 다르고, 내려받을 수 있다는 말과 상업적으로 써도 된다는 말도 다릅니다. 라이선스를 따로 봐야 합니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.