
인간 기준선
human baseline · 사람 기준선 · 인간 전문가 수준
같은 과제를 사람이 하면 얼마나 걸리고 어느 정도 맞히는지 미리 재 둔 수치입니다. 모델 점수를 이 수치와 나란히 놓아야 뜻이 생기는데, 영국 AI안전연구소 사이버레인지의 32단계 기업망 장악 시나리오는 인간 전문가면 약 20시간짜리로 잡혀 있습니다.
‘인간 기준선’ 이 나오는 글2

논문원 논문 공개 AI
월말 결산 네 과제, 회계사 평균 37%… Claude는 20번 모두 만점
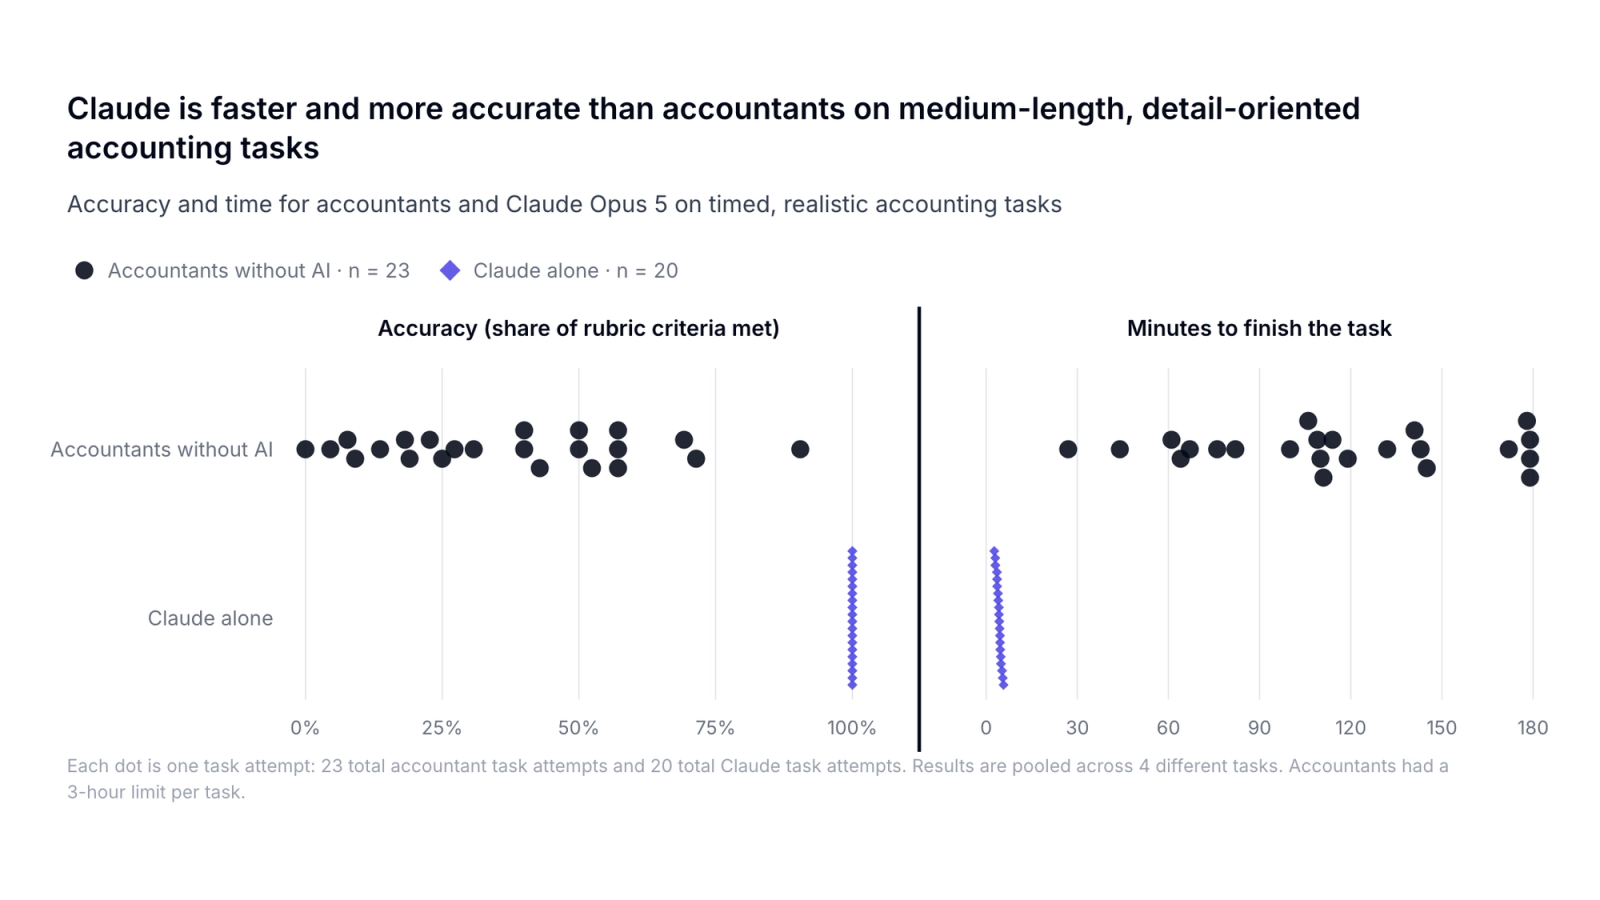
머코어가 한국 시각 10월 2일 새벽에 공개한 실험에서 Claude Opus 5는 간소화한 월말 결산 과제 20번을 모두 만점으로 10분 안에 풀었습니다. AI 없이 푼 회계사 12명의 평균은 약 37%였고, 함께 푼 24건은 약 15배 오래 걸렸습니다.
12분
함께 나오는 용어4
- 벤치마크모델 실력을 재는 표준 시험입니다. 수학(GSM8K·MATH), 코딩(HumanEval·SWE-bench) 같은 문제집 점수로 모델을 비교합니다.
- 코딩 에이전트저장소를 읽고 명령을 실행하며 코드를 끝까지 고치는 에이전트입니다. 최근 모델 도약이 지식 문답 대신 이쪽에 몰려서, 딥시크 V4-Pro는 코딩 에이전트 평가 DeepSWE에서 12.8점이 62.7점이 됐습니다. 같은 모델도 어떤 하네스에 올리느냐에 따라 점수가 크게 달라집니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 레드팀모델을 공격자 입장에서 시험해 취약점을 찾아내는 작업입니다. 사람이 하던 일을 자동 레드팀 AI가 대신하기 시작하면서, 가장 강한 공격 도구를 공개할지가 별도의 판단 대상이 됐습니다.
