답을 내게 하고 점수(보상)를 매겨, 점수가 높은 쪽으로 모델을 조금씩 옮기는 학습입니다. RLHF 는 사람 선호를, GRPO 는 여러 답을 서로 비교한 상대 점수를 보상으로 씁니다.
용어 자세히 보기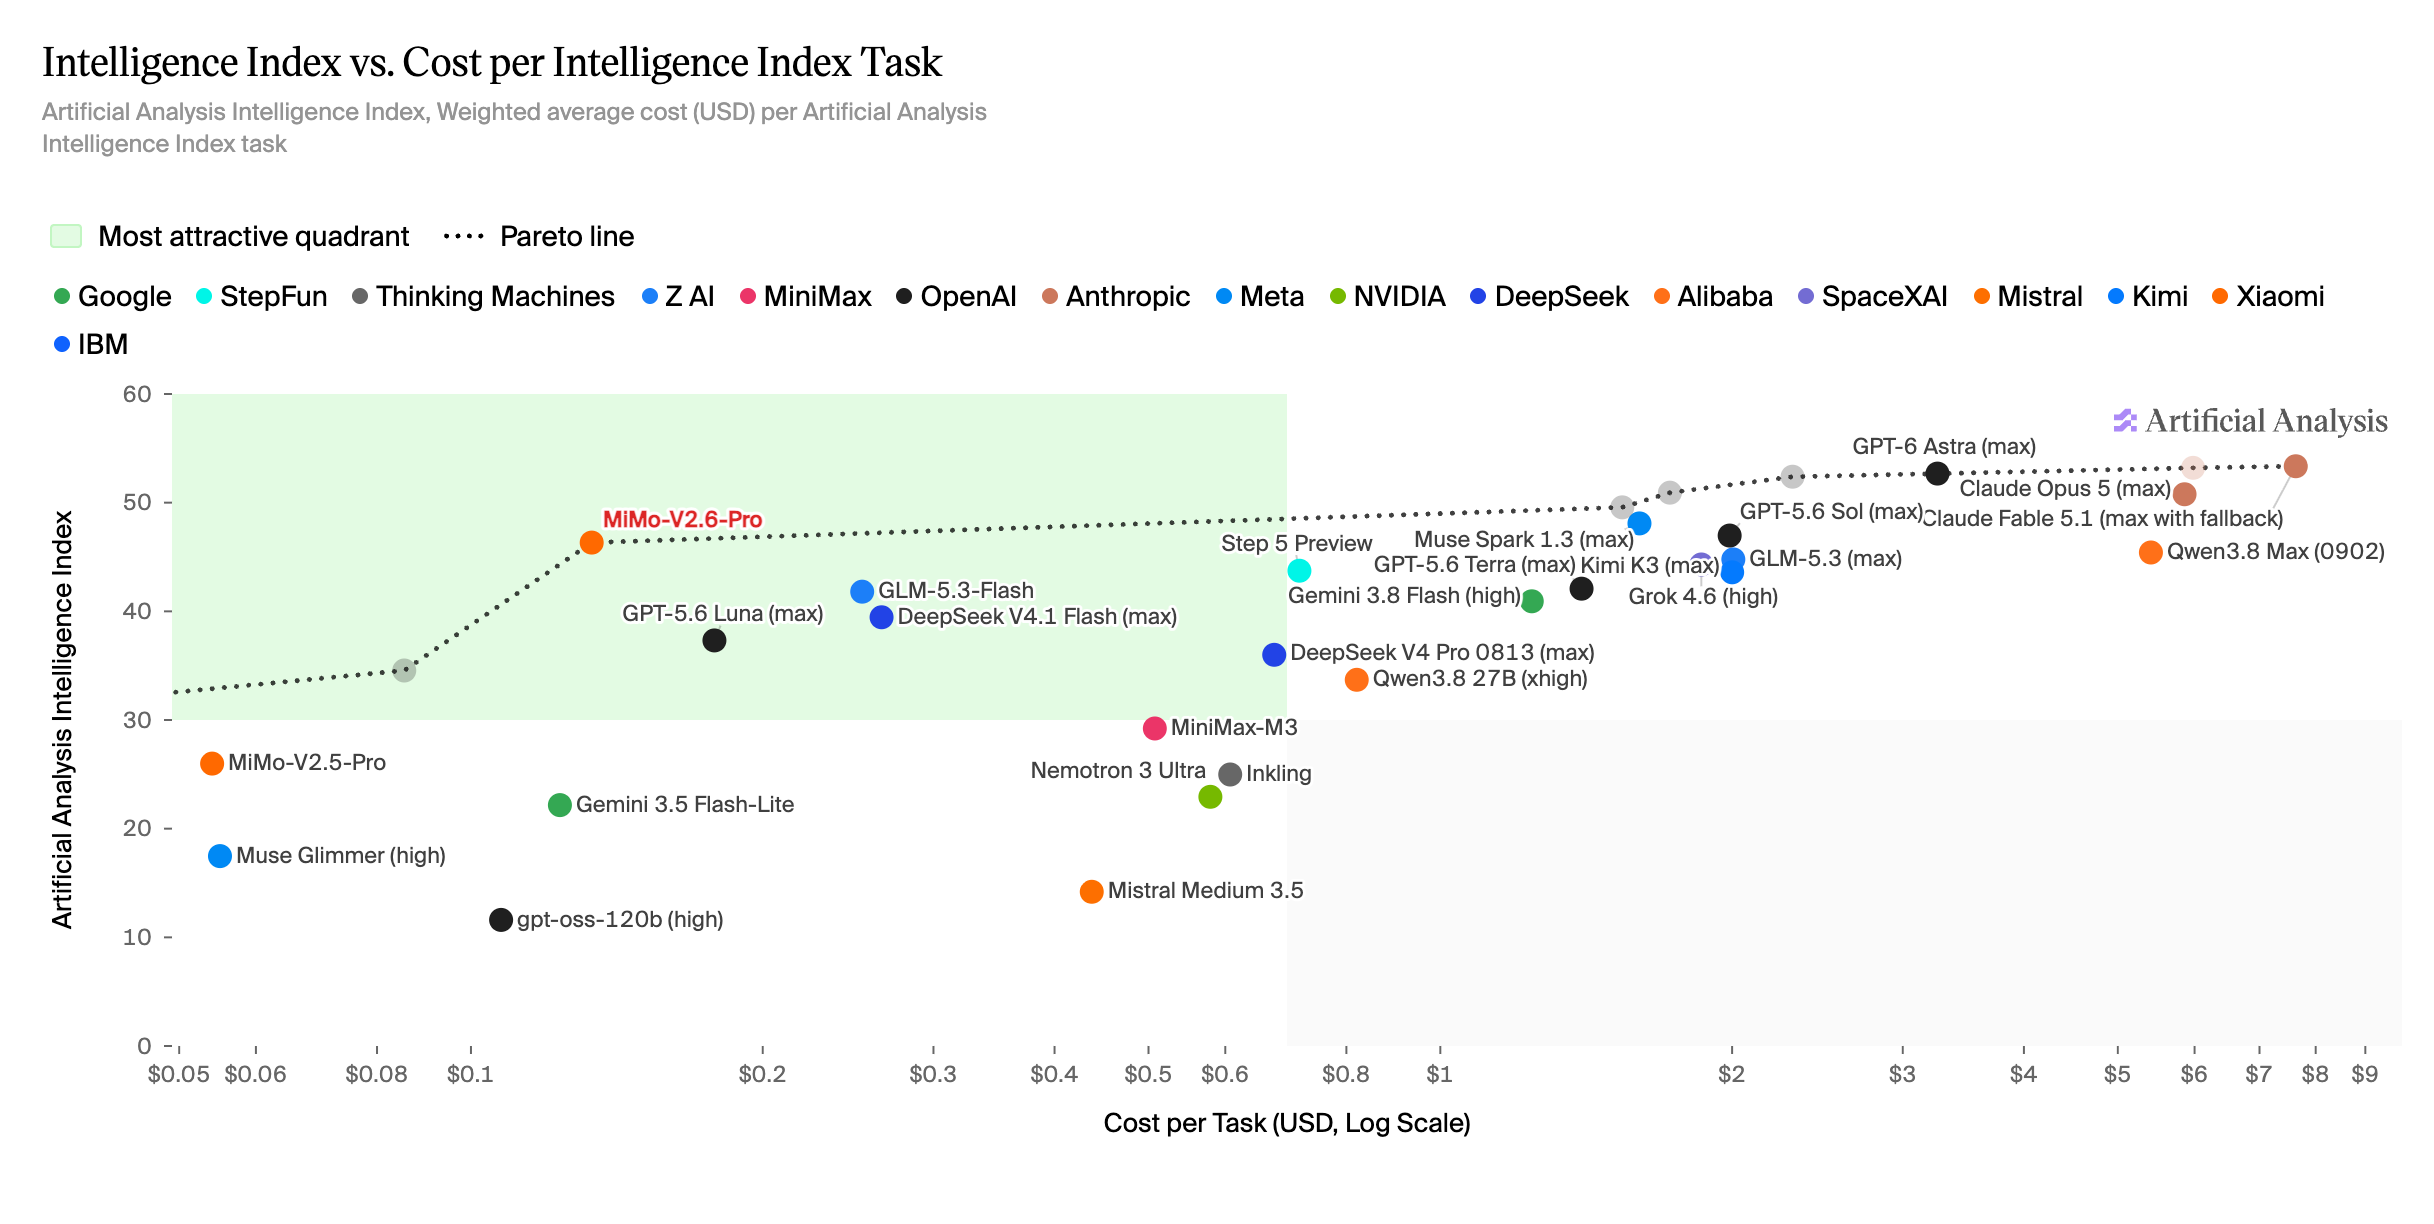
MiMo 팀이 강화학습(RL) 과정을 생중계하고 있습니다.
한 단계마다 약 20억 토큰을 처리하며, 1,568개 프롬프트에서 각각 16번씩 결과를 생성해 학습합니다.
MiMo-V2.6 Pro는 총 1조 개가 넘는 파라미터 규모이며, 샤오미는 강화학습을 AI가 스스로 개선되는 방향으로 가는 중요한 방법 중 하나로 보고 있습니다.
앞으로 몇 주 동안 학습 방식과 세부 기술도 순차적으로 오픈소스로 공개할 예정입니다.
Choi
소식12분AI
소식AI

팟캐스트1시간 37분AI
팟캐스트AI

학습 과정을 실시간으로 여는 방식은 결과만 내놓던 공개 관행을 흔듭니다. 재현 가능한 설정까지 순차 공개되는지가 이 시도의 값을 정합니다.
새롭게 공개된 PlayTrain은 LLM이 만든 JavaScript 게임을 그대로 강화학습(RL) 환경으로 바꿔 AI 에이전트를 학습시키는 프레임워크입니다.
예를 들어 원하는 게임 규칙을 프롬프트로 설명하면 LLM이 새로운 게임을 만들고, PlayTrain이 이를 AI가 반복해서 플레이하며 학습할 수 있는 환경으로 변환합니다.
게임은 브라우저에서 사람이 직접 플레이할 수도 있어 같은 화면과 조건에서 인간과 AI의 행동을 비교할 수도 있습니다.
이제 강화학습 연구도 정해진 게임을 푸는 데서 벗어나, 실험하고 싶은 환경부터 AI로 만들어 학습시키는 방식이 가능해졌습니다.
Choi
원하는 규칙을 프롬프트로 설명하면 학습 환경이 생기므로, 연구자가 환경을 직접 코딩하던 시간이 줄어듭니다. 사람도 같은 게임을 브라우저에서 할 수 있어 사람과 AI의 행동을 같은 조건에서 비교할 수 있습니다.
Induction Labs가 ‘intrinsic discovery’라는 새로운 강화학습 방식을 공개했습니다.
모델이 환경에서 아직 가보지 못한 상태를 발견하면 보상을 주고, 업데이트할 때마다 다시 탐색시키는 방식입니다.
이 방법을 터미널 환경에 적용하자 기존 고정 모델보다 새로운 상태를 5배 더 많이 발견했고, 그렇게 모은 경험만으로 학습한 월드 모델은 터미널 시뮬레이션에서 GPT-5.6 Sol보다 높은 성능을 기록했습니다.
그동안 AI가 무엇을 배울지는 대부분 사람이 정했습니다.
Choi
가보지 못한 상태를 찾을 때 보상을 주는 방식으로 터미널 환경에서 새 상태를 고정 모델보다 5배 많이 찾았고, 그 경험만으로 학습한 월드 모델이 GPT-5.6 Sol을 앞섰습니다.

매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.