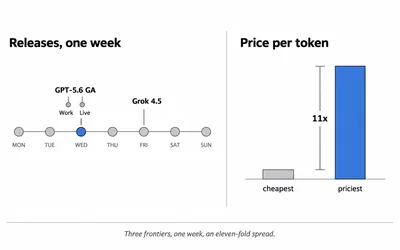
오픈AI가 GPT-5.6을 정식 출시로 넘기고 ChatGPT Work와 GPT-Live를 같은 날 붙였습니다. 이틀 뒤 간판을 SpaceXAI로 바꾼 머스크가 Grok 4.5를 냈고, 같은 주에 자기가 밀던 코딩 벤치마크의 30%가 깨져 있다는 감사 결과도 나왔습니다.
화요일엔 한 주를 정리한 뉴스레터도 와요. 언제든 그만 받을 수 있어요.
세 모델이 같은 주에 나오면서 비교 기준이 점수표에서 단가와 라이선스로 옮겨갔습니다. 그 점수표 자체의 눈금이 틀어져 있었다는 감사 결과도 같은 주에 나왔습니다.
62건입니다. 모델 출시와 수학, 규제, 하드웨어 순으로 배열했습니다.
7월 6일부터 12일까지 프런티어 모델 세 개가 겹쳐 나왔습니다. 오픈AI는 정부 승인 파트너 20곳에만 열려 있던 GPT-5.6 프리뷰를 전면 개방하면서 플래그십 Sol과 중간 Terra, 경량 Luna 세 등급을 한 번에 세웠습니다. 같은 날 앱과 파일을 가로질러 직접 행동하는 ChatGPT Work가 나왔고, 입력을 받으면서 동시에 출력을 만드는 풀듀플렉스 음성 모델 GPT-Live도 붙었습니다.
값이 가장 먼저 움직였습니다. 같은 코딩 작업을 끝내는 데 드는 비용이 17.32달러와 1.51달러로 갈렸고, 메타는 Muse Spark 1.1을 첫 유료 API로 열면서 출력 토큰을 경쟁 모델의 6분의 1로 매겼습니다.
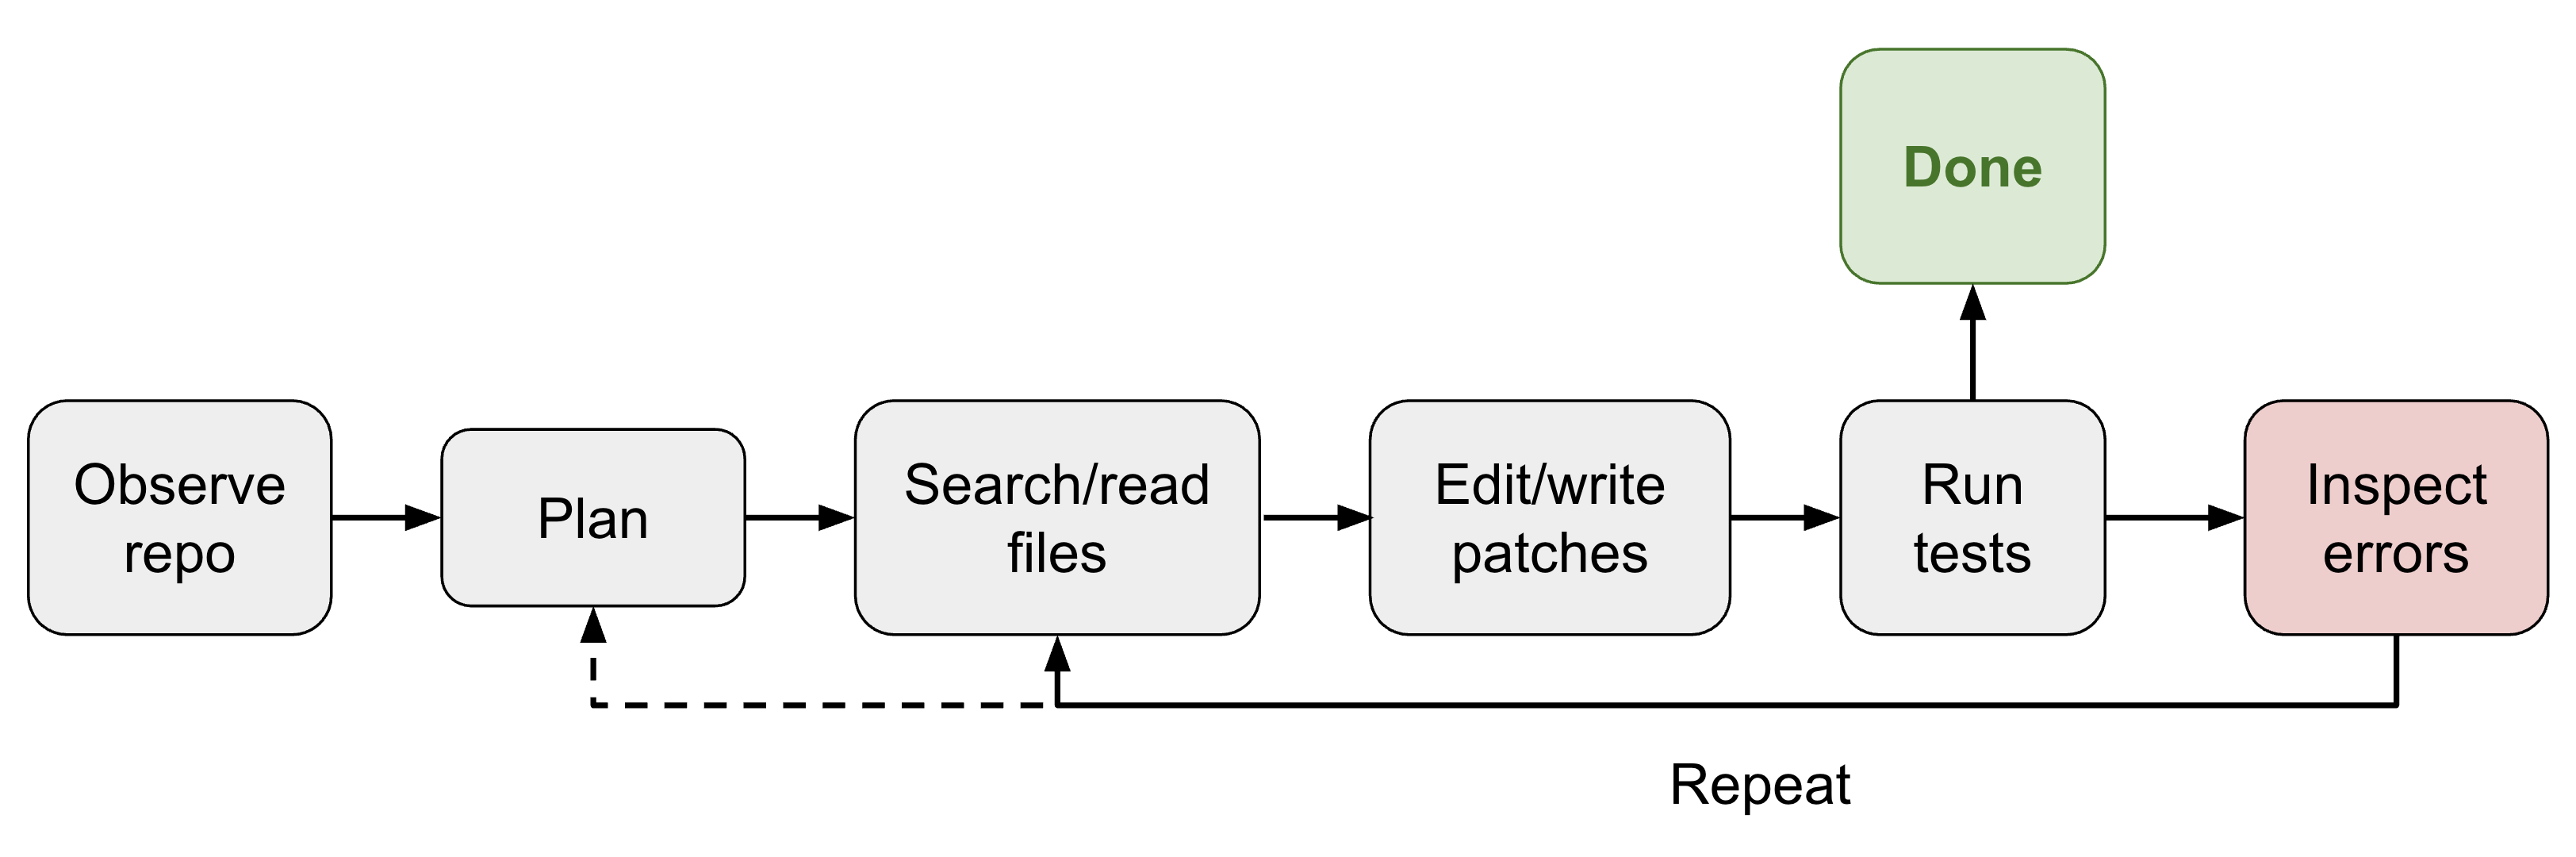
모델 바깥을 다룬 평론이 이번 주에 몰렸습니다. 릴리안 웽은 모델을 한 줄도 고치지 않고 SWE-bench를 20%에서 50%로 올린 기록을 자기개선의 시작점으로 지목했습니다. 앤트로픽 Claude Code 팀은 루프에 넘길 판단을 넷으로 나눈 단계표에 이어 모델 손잡이와 노력 손잡이가 무엇을 바꾸는지도 정리했습니다. 코드가 나와도 남던 배포와 운영 구간을 게시 버튼 하나로 접으려는 제품도 같은 주에 나왔습니다.
노동 쪽 숫자는 더 구체적입니다. 미국 22세부터 25세 개발자 취업이 3년 만에 19% 내려앉았고, KDI는 2030년 일자리 90%에 자동화 가능 딱지를 붙인 계산을 내놨습니다.
모델이 속으로 무엇을 하고 있는지 들여다본 논문이 세 편입니다. 사용자 직업만 바꿔도 도덕 점수가 36점까지 갈린 실험에서는 법 위반(36.2점)과 즐거움 빼앗기(36.8점)처럼 해석 여지가 있는 항목의 폭이 컸습니다. 리퀴드AI는 반복 고리를 여는 첫 토큰 하나를 다시 가르쳐 반복률을 22.9%에서 1%대로 떨어뜨렸습니다.
수학에서 한 주에 두 건이 나왔습니다. GPT-5.6 Sol Ultra가 50년 된 사이클 이중 덮개 추측의 증명을 한 시간 안에 내놨고, Grok 4.5는 4차원에서 반례를 만들어 3차원이 실제 경계임을 보였습니다. 엔비디아는 에이전트 시대의 병목으로 CPU를 지목하며 Vera를 냈고, 팀 쿡은 브로드컴과 300억 달러 계약을 발표했습니다.