
리더보드
leaderboard · 순위표
여러 모델의 점수를 같은 조건에서 줄 세워 공개하는 표입니다. 과제당 비용을 함께 적는 곳이 늘면서 성능과 가격을 한 줄에서 비교하게 됐습니다. Datacurve의 8월 26일 집계에서 Opus 5는 과제 하나에 평균 11.84달러, GPT-5.6 Sol은 73%에 6.46달러였습니다.
‘리더보드’ 이 나오는 글6
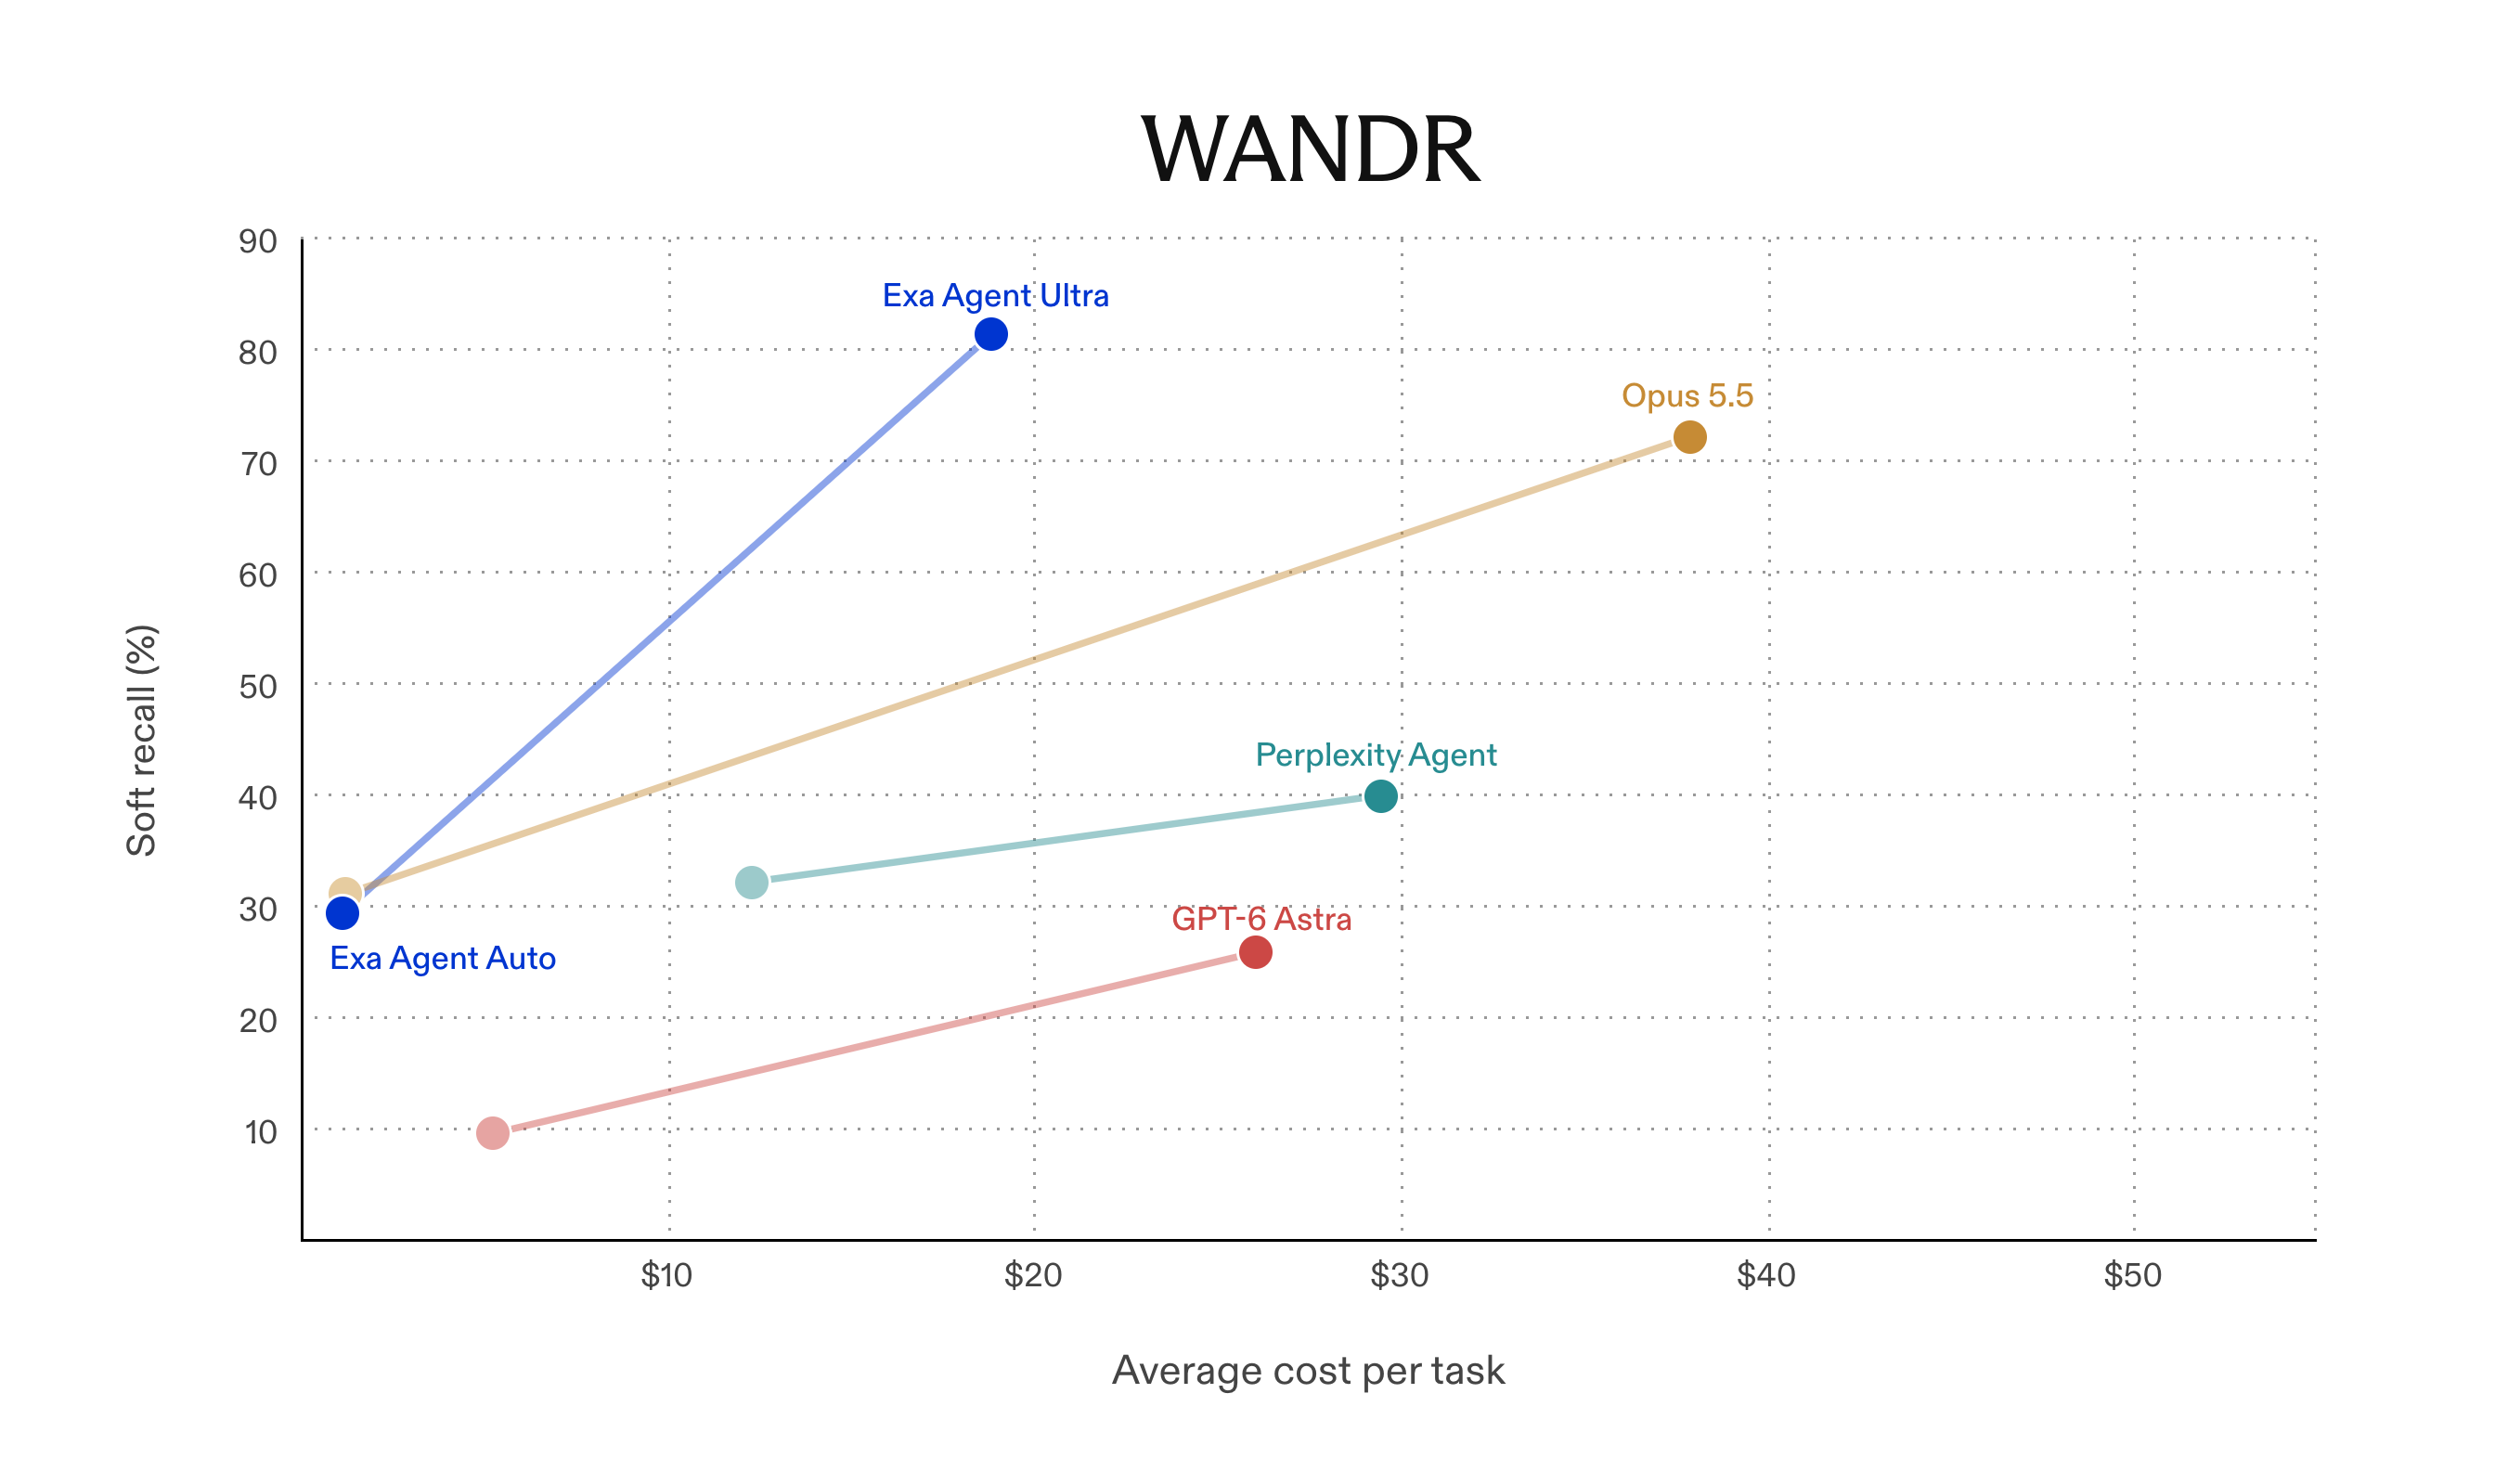
Exa Agent Ultra가 WANDR에서 81.4%, 채점은 Exa가 했습니다
Exa가 9월 25일 리서치 에이전트의 최고 노력 단계 Agent Ultra를 공개했습니다. 회사 표에서 WANDR 81.4%로 Opus 5.5의 72.3%를 앞섰고, 수집 도구와 판정 모델을 바꾼 자체 채점 틀에서 나온 숫자입니다.
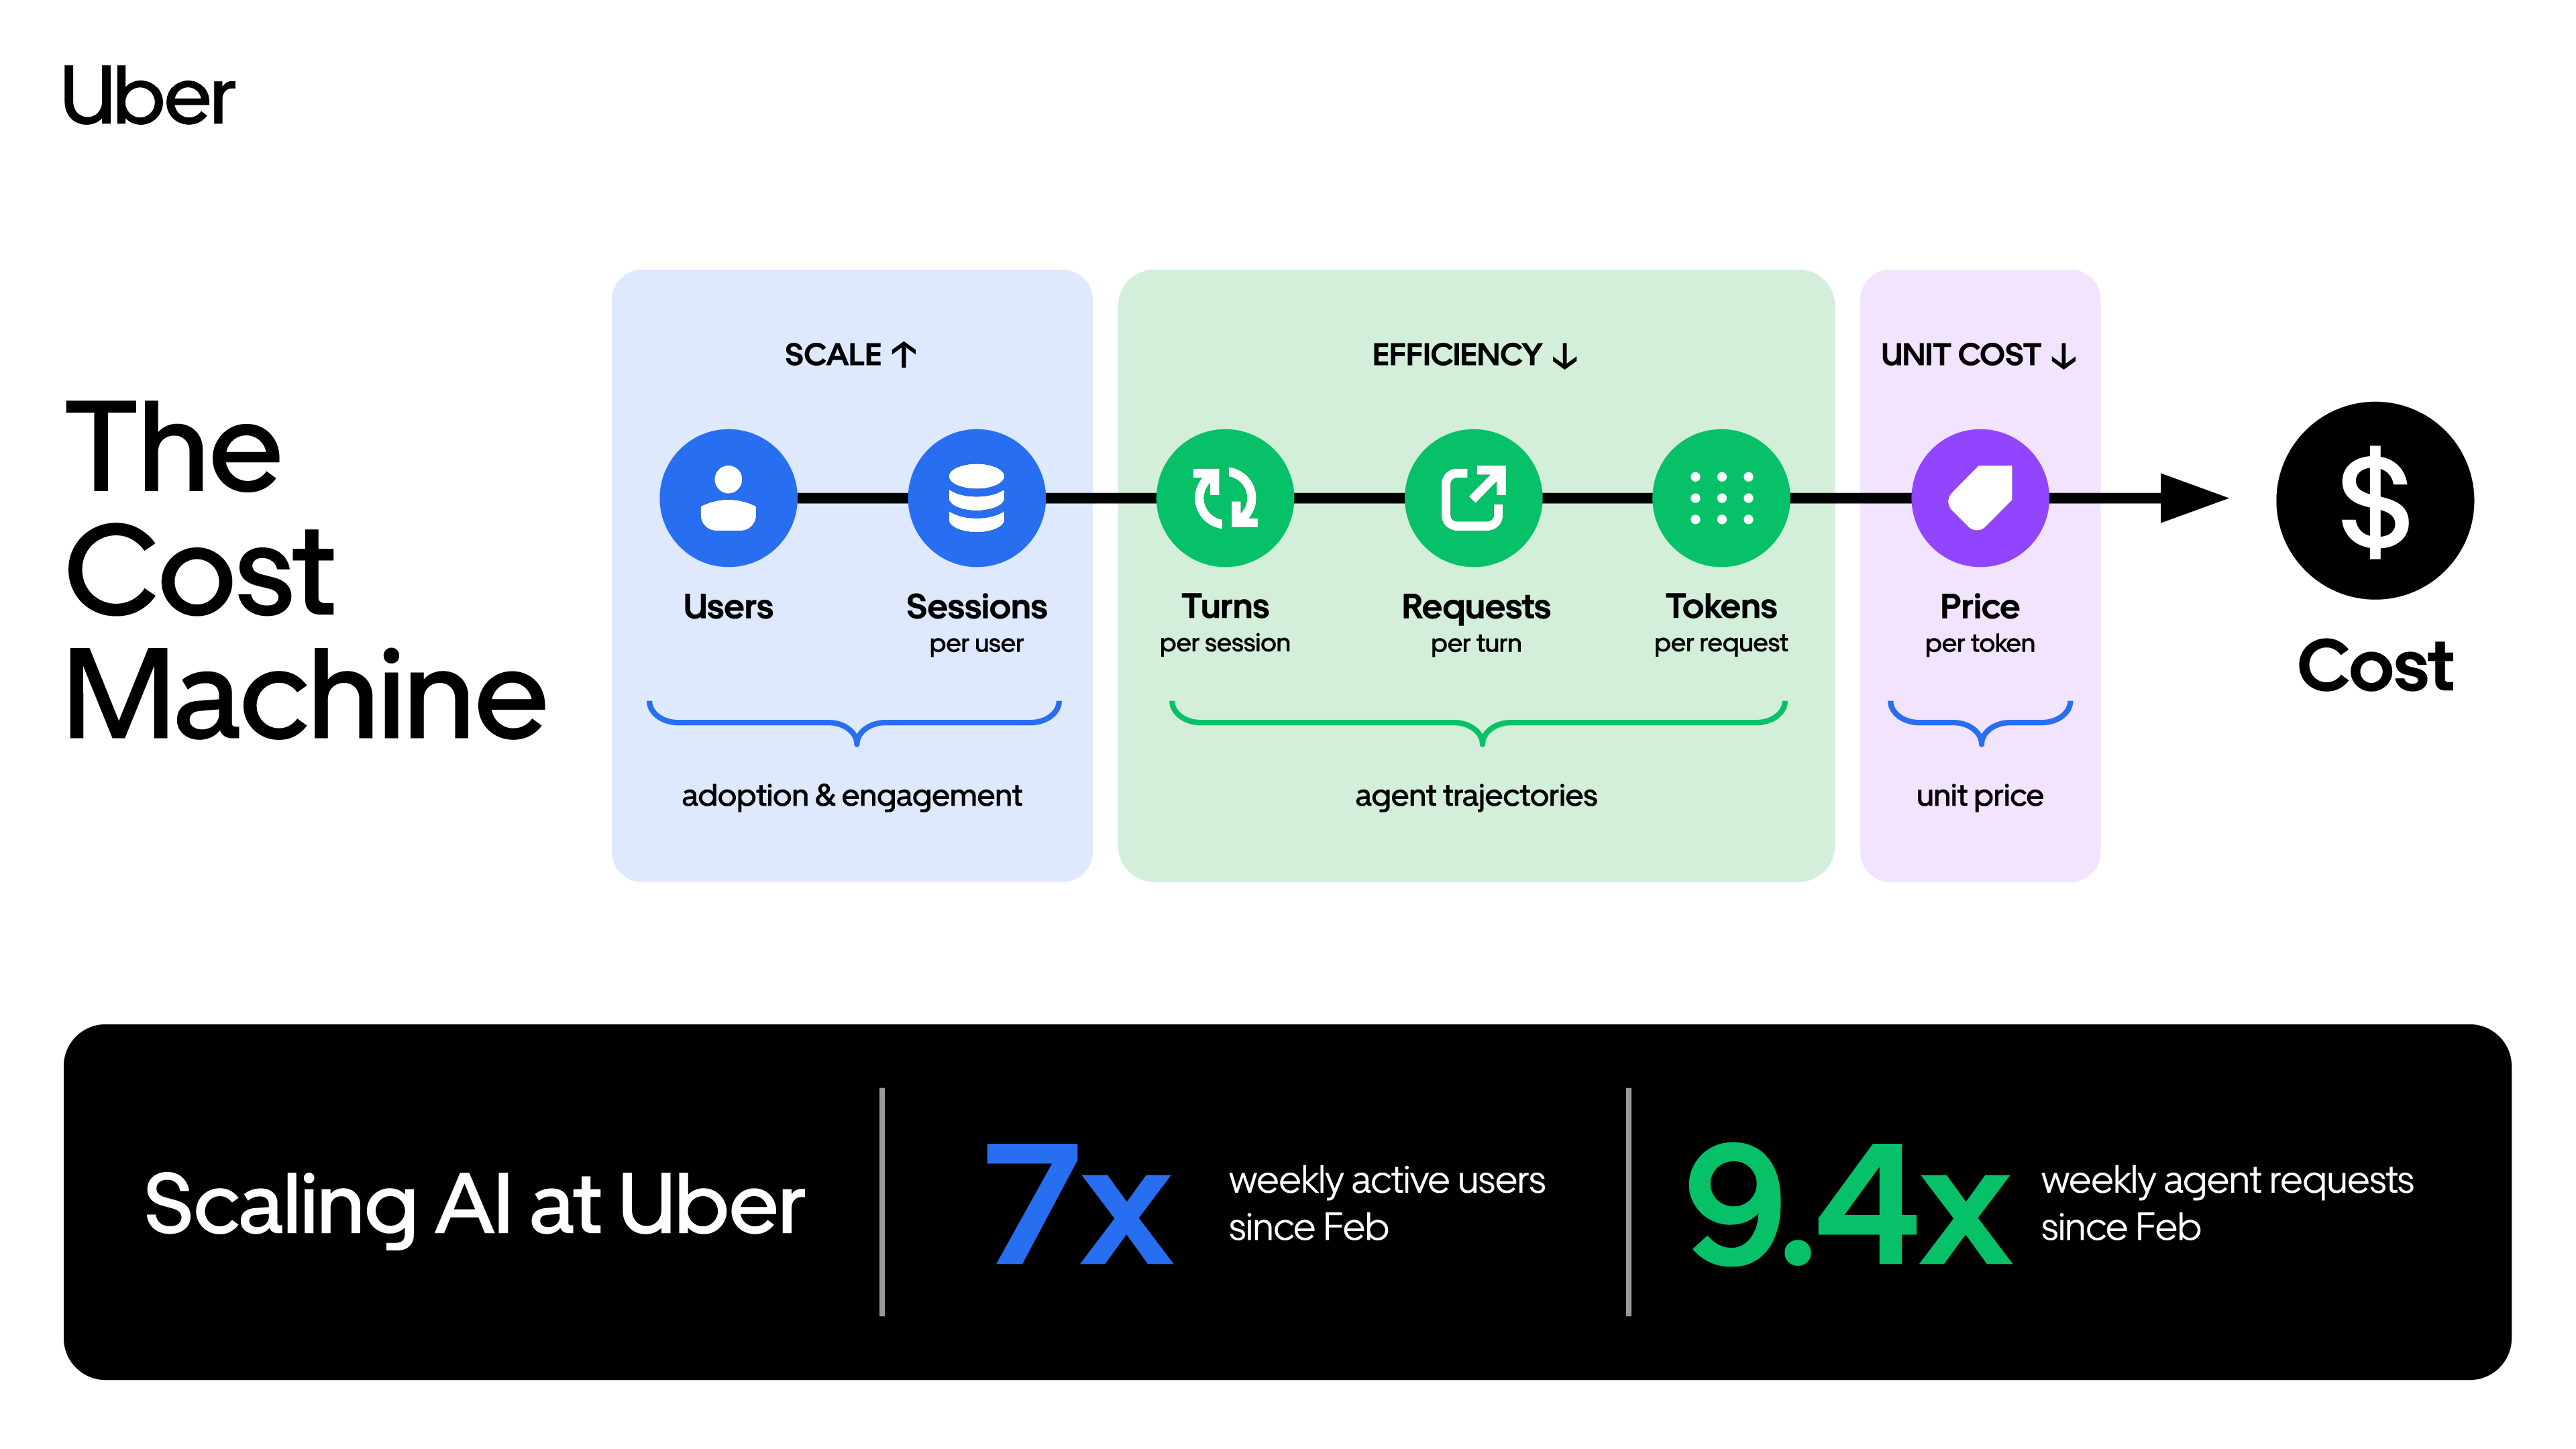
AI 예산을 4개월 만에 바닥낸 우버, 세션당 비용을 절반으로 줄였습니다
폭이 넓은 테이블 조회 한 번이 143만 토큰에서 900토큰이 됐습니다. 같은 질문에 지식 그래프를 쓴 에이전트는 38초 만에 맞혔고, 그래프 없는 에이전트는 20분을 쓰고 틀렸습니다.
14위에서 단숨에 2위, xAI 이미지 모델 Imagine Image 2.0
xAI가 8월 7일 Imagine Image 2.0을 Grok의 새 Quality Mode로 내놓았습니다. 직전 모델이 14위였던 Arena 텍스트 투 이미지 순위에서 2위에 올랐고, 편집 순위에서는 1위 GPT Image 2와 24점 차입니다. API는 곧 열겠다고만 했습니다.
최고라던 사카나 보안 AI 86.9%, 순위표엔 더 높은 기록이 둘 있었습니다
사카나 AI가 7월 21일 공개한 Fugu-Cyber는 CyberGym 86.9%로 최고 성능이라고 밝혔습니다. 이틀 전 공개 순위표에는 마이크로소프트 MDASH의 88.45% 등 더 높은 기록이 둘 있었고, 사카나는 시도 횟수를 적지 않았습니다.

미국 턱밑까지 쫓아온 중국 오픈 모델, 2.8조 Kimi K3가 나왔습니다
문샷AI가 7월 16일 총 2.8조 파라미터 Kimi K3를 공개했습니다. 아티피셜애널리시스 지수에서 57점으로 3위에 올랐고, 프런트엔드 코드 순위표에서는 Fable 5를 제치고 1위였습니다. 다음 날 경쟁사 Z.ai 주가는 30% 가까이 떨어졌습니다.

"CLI는 없애지 않는다" 오픈AI가 서울 코덱스 밋업 질의응답에서 내놓은 답
7월 8일 서울 코덱스 밋업 질의응답에서 오픈AI 발표자는 CLI를 없애지 않고 실험 기능을 CLI에서 먼저 낸다고 답했습니다. Terminal-Bench 2.1에서 코덱스 CLI와 GPT-5.5는 83.4%, 같은 모델을 공용 하네스에 얹으면 78.2%였습니다.
함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 벤치마크모델 실력을 재는 표준 시험입니다. 수학(GSM8K·MATH), 코딩(HumanEval·SWE-bench) 같은 문제집 점수로 모델을 비교합니다.
- 프런티어 모델그 시점에 공개된 모델 가운데 능력이 가장 앞선 등급을 가리킵니다. 각국 안전연구소의 평가 대상과 수출통제 논의가 이 등급을 기준으로 짜입니다.
- 오픈 웨이트학습된 가중치 파일을 공개해 누구나 내려받아 돌릴 수 있는 모델입니다. 학습 데이터·코드까지 다 여는 '오픈 소스'와는 구분합니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.